好用的 UX 工具,就是能回答你正在问的那个问题的工具,所以按工作选,而不是按产品清单选。统计看人在哪里流失;热力图和会话回放看他们做了什么;问卷、访谈和可用性测试解释为什么;原型提出修法;性能和错误监测排除技术原因。五个测试用户就能发现一轮约 84% 的问题。先有问题,再每件事选一个工具。
读完你会知道
- 先写问题,再选证据类型(计数、轨迹、原因、耗时),最后才选工具
- 五个测试用户能发现一轮约 84% 的问题;每轮五人做三轮,胜过一次十五人
- 每件事只留一个工具;小团队先用统计、少量真实对话和性能监测
UX 工具怎么选:先有问题,再选类别
一个 UX 工具只有在回答你真正在问的问题时才值得买。「访客在哪里离开?」由统计分析回答;「他们想点哪里?」由热力图和会话回放回答;「他们为什么离开?」要靠人:访谈、问卷或有人陪同的测试;「页面是不是对一部分人又慢又出错?」由性能和错误监测回答;「下一步做什么?」则是设计和原型的问题。
多数盘点文章列出 15 到 20 个产品,让你自己判断哪个合适。顺序是反的。可靠的顺序是:
- 把问题写成一句话(「为什么 38% 的手机购物者停在地址这一步?」)。
- 判断什么证据能回答它:计数、行为轨迹、口头原因还是耗时。
- 然后才选这一类里的工具。
本文就按这个顺序写:一套 UX 工具要完成的六件事、每件事回答什么、靠人的几件事需要多少测试用户、一个人、十个人和五十个人的团队先补哪几件、买之前的检查清单。文中有意不点产品名,因为类别比厂商变得慢得多。如果你只关心统计这一半,UX 分析讲得更深,热力图工具比较的是这一个类别。
| 如果你的问题是…… | 先用 |
|---|---|
| 这一步有多少人流失? | 统计与漏斗 |
| 他们想点哪里? | 热力图和会话回放 |
| 他们为什么离开? | 访谈、一道题的问卷或有人陪同的测试 |
| 页面慢或者报错吗? | 性能与错误监测 |
| 下一步该做成什么样? | 原型和设计工具 |
每件事一个工具;每件事留下的缺口,由下一件事来补。
UX 工具要完成的六件事
| 工作 | 回答的问题 | 证据类型 | 典型产出 | 留下的缺口 |
|---|---|---|---|---|
| 产品与网站统计 | 有多少人做了这件事,在哪里流失? | 计数和比率 | 漏斗、留存、来源 | 说不出原因 |
| 热力图与会话回放 | 他们在这个页面上做了什么? | 行为轨迹 | 点击图、滚动图、录像 | 样本少,要注意隐私 |
| 问卷与反馈 | 他们为什么这样做? | 自述原因 | 简短回答、评分 | 人们说的是记得的,不一定是做过的 |
| 可用性测试与访谈 | 有人能完成这个任务吗? | 观察到的任务 | 任务成功率、问题清单 | 人少,环境是测试环境 |
| 原型与设计 | 还能做成什么样? | 样稿 | 可点击原型、设计说明 | 说明不了真实使用 |
| 性能与错误监测 | 够快吗,对所有人都能用吗? | 耗时和异常 | 加载时间、错误分组 | 不判断设计本身合不合理 |
从这张表能得出两条规则。
- 没有哪一件事能替代另一件。 统计告诉你某一步流失 38%;只有真人在屏幕前,或者一段录像,才能告诉你按钮看起来像是点不了。
- 每件事留下的缺口就是下一件事。 计数提出问题,轨迹定位问题,人解释问题,原型提出修法,再用计数检查修法有没有效。
只有统计的团队,仪表盘里全是问题。只有原型和访谈的团队,观点很强,却没法衡量自己对不对。
靠人的几件事需要多少测试用户?
可用性测试和访谈是工具最不重要、方法最重要的部分,所以值得知道你需要的人有多少。Jakob Nielsen 在他与 Thomas Landauer 1993 年模型的基础上,估算 n 个测试用户能发现的可用性问题比例为:
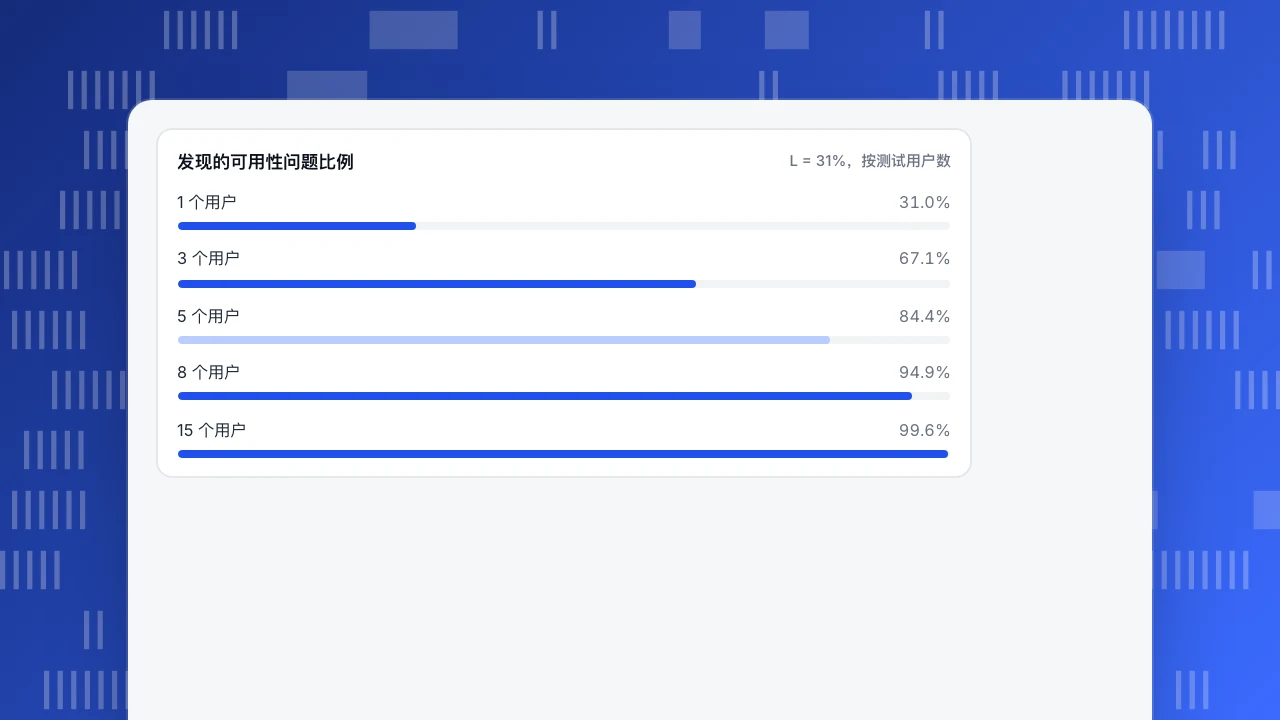
发现比例 = 1 − (1 − L)^n,L 是单个用户能发现的比例,Nielsen 取 L = 31%。
按 L = 0.31 重新计算:
| 测试用户数 n | 发现的问题比例 |
|---|---|
| 1 | 31.0% |
| 3 | 67.1% |
| 5 | 84.4% |
| 8 | 94.9% |
| 15 | 99.6% |
五个用户能发现一轮测试大约 84% 的问题,与 Nielsen 自己的说法一致:第一次五人研究大约发现了 85%。实际含义不是「测五个人就够」,而是「每轮五人、中间修一次,三轮胜过一次十五人」,因为第二轮能发现被第一轮问题遮住的问题。
有两个前提要说清楚。L = 31% 是 Nielsen 所依据研究的平均值;产品复杂、用户分好几类时,每一类的 L 都会更低,所以要每类测五个。另外,这个模型只适用于发现问题,不适用于衡量某个问题有多普遍。要知道「有多少人踩到这个问题」,回到统计分析,分母是你的全部流量。
发现的可用性问题比例
L = 31%,按测试用户数一个问题、四种工具:行为类工具怎么配合
下面用一个问题看前四件事怎么配合。示例数据:某商店手机端结算在地址这一步流失 38% 的访客。
- 统计(是什么、多少人)。 漏斗显示 5,000 个手机会话到达地址步骤,3,100 个继续到配送:流失 1,900,即 38.0%。桌面端同一步只流失 14%。所以问题只出在手机上。
- 热力图(在哪里)。 手机端地址页的点击图显示「继续」按钮上有一团重复点击,国家下拉框上还有另一团。
- 会话回放(怎么发生的)。 看流失人群的六段录像,发现填完邮编后键盘挡住了「继续」按钮,而且按钮要等很靠上、不在首屏的一个字段填完才变亮。
- 问卷或访谈(为什么)。 一道题的退出提示,或五位手机测试用户被要求「买下这件商品」,证实他们以为表单卡住了。
这条链上的任何一个工具单独都不够。漏斗找到了问题,却看不到灰色按钮;录像看到了灰色按钮,却说不出影响多少人。修法(必填字段标红、按钮保持可点)再回到第 1 步:那 38% 降了吗?
配置工具的规则:同一件事先选定一个工具,再考虑第二个。 两个热力图产品会给出两组对不上的数字,而且没人有时间去查为什么。
性能和错误工具比统计多提供什么?
设计问题和技术问题在漏斗里长得一样:人走了。性能和错误监测能把它们分开。要对照的是 Google 的核心网页指标(Core Web Vitals)阈值,按页面加载的第 75 百分位、分手机和桌面统计:
| 指标 | 衡量什么 | 「良好」阈值 |
|---|---|---|
| 最大内容绘制(LCP) | 主要内容何时可见 | 2.5 秒或更短 |
| 下次绘制交互延迟(INP) | 页面对点按的响应有多快 | 200 毫秒或更短 |
| 累计布局偏移(CLS) | 加载时版面跳动多少 | 0.1 或更小 |
为什么看第 75 百分位:平均值会掩盖最慢的四分之一访客,而这些人往往是网络较差的手机用户,也是漏斗里流失的人。中位数 LCP 良好、第 75 百分位 LCP 很差的页面,对四分之一的流量是慢的。
一条好用的判断规则:如果某一步对某类设备骤降,并且这类设备的 LCP 或 INP 不在良好范围内,先修性能再谈改版;如果耗时良好、错误平稳,问题就在设计上,回到热力图、回放和真人。
1 人、10 人、50 人的团队先补哪几件?
第一天不需要六件都有。按你最先被问到的问题来补。
| 团队 | 先补 | 再加 | 留到以后 | 原因 |
|---|---|---|---|---|
| 1 人或 2–3 人 | 统计,加每季度一次五个用户的通话 | 性能监测 | 大规模回放,设计师已有工具之外的原型工具 | 计数加少量真实对话,就能抓住大多数明显问题 |
| 5–15 人,有产品或增长负责人 | 统计和热力图 | 回放、错误、简短反馈提示 | 专门的研究资料库 | 流量够抽样看行为了,也有人负责跟进 |
| 30–50 人,多个小组 | 六件都有,每件一个工具 | 管理规则:谁能看录像、保留多久 | 各小组各买一套 | 统一口径比多几个功能更重要 |
小团队有两个现实限制。其一,热力图和回放需要流量:一个月 200 次访问的页面,点击图每多一个人点击就变一次。每种设备不到几百个会话的图,只能当个例。其二,真正的预算是注意力。上个月没人打开过的工具不是 UX 工具,只是一笔订阅费。
UX 工具的价格到底跟什么挂钩?
与其引用每季度都在变的价格,不如看每个类别的账单随什么增长,这决定了哪个工具在你变大之后还付得起。
| 类别 | 账单通常随什么增长 | 要留意 |
|---|---|---|
| 统计 | 追踪的事件数或会话数 | 活动带来流量高峰时的超额费用 |
| 热力图与回放 | 录制的会话数、保留天数 | 采样率,以及录像保留多久 |
| 问卷 | 收集的回答数、席位 | 题目数或分支逻辑的限制 |
| 可用性测试 | 按参与者或按测试次数 | 自己招募用户和用样本库的成本差 |
| 原型与设计 | 席位(编辑者和查看者) | 为只需评论的人付编辑费 |
| 性能与错误监测 | 页面浏览量或错误事件数 | 一个出错的脚本重复产生成千上万条错误 |
同一类别里两个工具看起来差不多时,选账单随你能控制的东西增长的那个。你能用采样限制录制量,却没法限制有多少人访问你的网站。
买任何 UX 工具之前要查什么?
对每个候选工具做同样的六项检查,并写下答案:
- 它回答哪个问题? 写不成一句话,就先别买。
- 数据存在哪里、保留多久? 问清保留期,以及能否按请求删除某位访客的数据。
- 默认采集什么? 表单字段、密码和个人文本应默认排除,需要时再主动开启。
- 能按设备、来源和已保存的分群切分吗? 不能筛选的录像或图,只是故事,不是证据。
- 谁每周都会打开它? 写出名字。
- 离开时数据怎么办? 能真正用上的导出,也是价格的一部分。
让两个工具在同一个页面上并行两周,比较各自促成了什么决定,留下真正改变过决定的那个。
TapCub 在这些工具里的位置
还是上面的手机结算例子,用一个工具走完前四步。
- 在 全端分析 › 行为分析 › 行为分析 建漏斗并按设备拆分,这就是「手机 38%、桌面 14%」那一步。
- 打开 全端分析 › 行为分析 › 热力图,选地址页和移动设备:点击图、挫败点击(狂点)图、滚动图和元素占比。热力图需要先打开全埋点,密码框等元素不会被记录。
- 打开 全端分析 › 行为分析 › 会话回放(默认关闭,先打开),看流失人群的会话。
- 打开 监测 › 性能 看同一页面的核心网页指标,打开 监测 › 错误 看脚本错误。
TapCub 不做问卷和访谈、A/B 测试和原型,所以第 3、4、5 件事仍在你的其他工具里;TapCub 衡量的是改版上线之后发生了什么。原生 App 没有点击热力图,App 团队改用屏幕漏斗和稳定性报表。
常见问题
小团队适合用哪些 UX 工具?
先用网站统计、每季度五次真实用户对话和性能监测。等关键页面每种设备有几百个会话再加热力图和回放,因为点击太少的图基本是噪声。
UX 工具和统计工具有什么区别?
统计工具计数并比较人们做了什么。UX 工具是更大的一组:统计、热力图、回放、问卷、可用性测试、原型和性能。统计找出问题在哪,其余的解释它或测试修法。
每件 UX 工作都要单独买一个工具吗?
不一定。有些产品同时覆盖相邻的两三件事,比如统计加热力图和回放。关键是每件事只有一个工具。问卷、访谈和原型宜分开,除非某个平台明显做得好。
可用性测试需要多少用户?
按 Nielsen 的 L = 31%,五个用户能发现一轮约 84% 的问题。每类用户测五个,修完再做一轮小测试,而不是一次做一轮大的。
怎么判断一个 UX 工具值得付费?
在一个页面上用两周,写下它改变过的每一个决定。如果没促成任何决定,要么问错了问题,要么选错了类别。
资料来源
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
