A/A 测试让两组访客看完全相同的页面,检查的是实验本身,不是选赢家。健康的搭建在 5% 水平下仍会把大约 20 次测试里的 1 次判为显著,按计划分流,两组记录的事件也一样。其中任何一项不成立,先修好,再去相信 A/B 的结果。
读完你会知道
- 正确的 A/A 测试在 5% 水平下约 5% 的时候显著:我们 10,000 次模拟里是 4.96%,不是 0%
- 偷看会把这 5% 抬到:看 2 次是 8.5%,看 20 次是 25.1%;先用卡方检验查分流(50,900 / 49,100 得 32.4,远高于 3.84)
- 采用或更换工具和指标时做一次;搭建已验证、每次测试都查自己的分流时可以不做
A/A 测试检查什么
A/A 测试里,两组访客看到的是同一个体验:页面、优惠和代码完全一样,只有分配是随机的。因为根本没有差异可找,这个测试选不出赢家。它检查的是实验这套机器本身:访客是否按你设想的比例分开、两组记录的事件是否一样、「显著」这个标签出现的频率是否和数学上应有的差不多。
最后一项最容易被忘掉。显著性水平 5% 时,一个正确的搭建,在两组完全相同的情况下,大约每 20 次测试会出现 1 次显著差异。不是 0 次。如果你的工具报告显著的次数远多于或远少于这个数,它的 A/B 结果也不可信。
A/A 测试回答三个问题,每个问题都有可以对照的数字:
| 问题 | 要对照的数字 | 健康的结果 |
|---|---|---|
| 分流是你要求的比例吗? | 每组访客数与计划比例 | 没有样本比例失衡(见下文) |
| 两组的追踪一致吗? | 每组的事件数和目标达成率 | 差异在噪声范围内 |
| 误报率诚实吗? | 相同的两组中被判显著的比例 | 5% 水平下约 5% |
如果你要比较两个不同版本、想知道怎么读结果,那是另一件事,请看 A/B 测试指南和统计显著性。
| 问题 | 要对照的数字 | 健康的结果 |
|---|---|---|
| 分流是你要求的比例吗? | 每组访客数与计划比例 | 没有样本比例失衡(χ² 低于 3.84) |
| 两组的追踪一致吗? | 每组的事件数和目标达成率 | 差异在噪声范围内 |
| 误报率诚实吗? | 相同的两组中被判显著的比例 | 5% 水平下约 5% |
示例数据:模拟 10,000 次 A/A 测试,每组 5,000 位访客,真实转化率 4%。
健康的 A/A 结果是什么样
我们用 Python 模拟了 10,000 次 A/A 测试。每次测试两组各 5,000 位访客,两组的真实转化率都是 4%。每一对最后只比较一次,用双比例 z 检验(NIST/SEMATECH 手册里的合并比例版本),显著性水平 5%。
示例数据结果:10,000 次测试里有 496 次显著,占 4.96%。正确的搭建就是这个样子:接近 5%,不是 0%。
由此得到两点:
- 一次「显著」的 A/A 结果不能证明有故障。 健康的测试里大约每 20 次有 1 次。先重复一次,或者看另外两项检查,再去怪工具。
- 从不报告任何显著结果的工具不是「保守」,很可能是检验力丢了。 多次 A/A 之后,p 值应该在 0 到 1 之间均匀分布,也就是 10% 的 p 值小于 0.10。
怎么做一次 A/A 测试
- 选定指标和统计单位。 选一个转化目标,决定按访客还是按会话计数。用和今后真实测试一样的口径。
- 开始前定好样本量。 用你下一次真实测试需要的样本量(见样本量一节)。写下来。
- 50/50 分流,跑满整周。 工作日和周末的行为不同,至少跑 7 天或 7 的倍数。
- 先检查分流。 检验各组人数是否符合计划(下一小节说明做法)。分流有问题,其他结果都没有意义。
- 然后在计划的样本量上只比较一次目标达成率。 看观察到的差异和它的区间,不要只看标签。
- 条件允许就重复。 一次可能运气不好;跑三次能大致知道误报的频率。
检查分流:样本比例失衡
样本比例失衡(SRM)指各组人数和设计应有的比例不一致。标准检查是把观察到的人数和预期的 50/50 做卡方检验:χ² = Σ(观察 − 预期)² ÷ 预期,5% 水平下自由度为 1 时与 3.84 比较。
示例数据,预期 100,000 位访客按 50,000 / 50,000 分开:
| 观察值 | 计算 | χ² | 结论 |
|---|---|---|---|
| 50,300 / 49,700 | (300² + 300²)÷ 50,000 | 3.6 | 在噪声范围内(低于 3.84) |
| 50,900 / 49,100 | (900² + 900²)÷ 50,000 | 32.4 | 失衡:停下来查原因 |
第二种分流看着差得不多,50.9% 对 49.1%,但已经远远超出随机能产生的范围。常见原因有:重定向让某一组丢了部分访客、某个版本的脚本加载更慢、机器人只被分到了一组。
为什么偷看会毁掉 A/A 测试
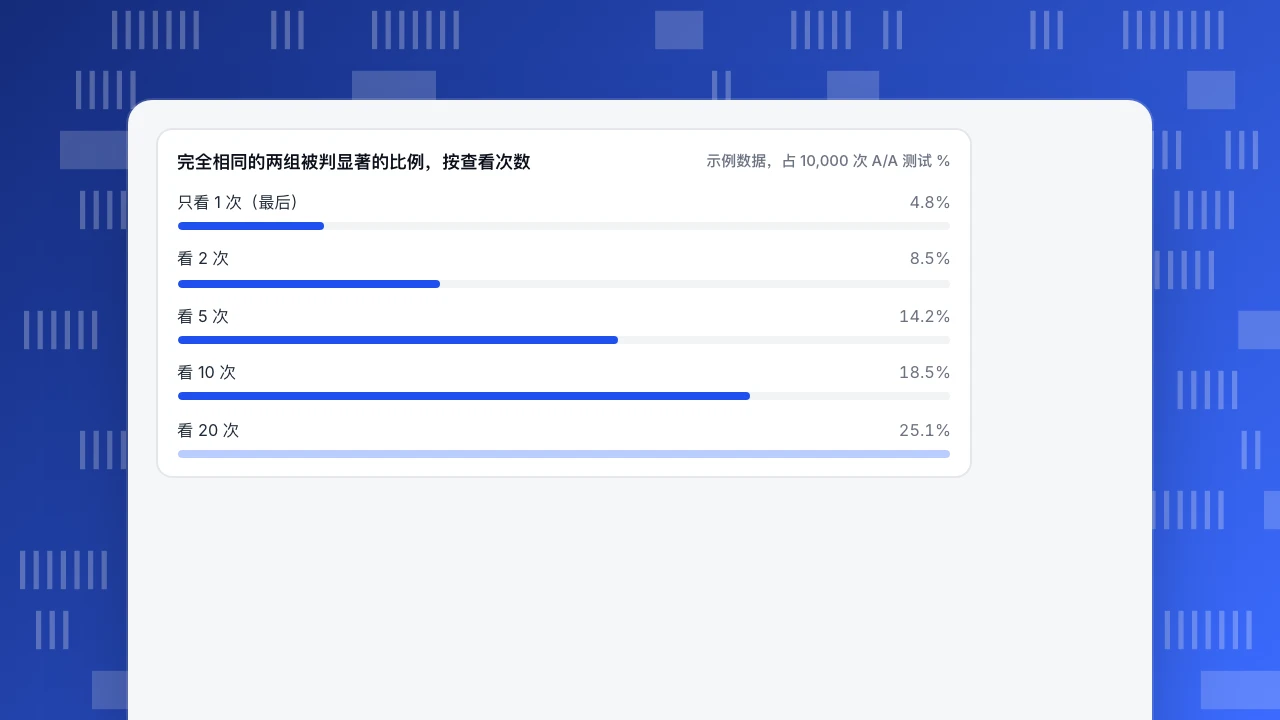
上面的 4.96% 假设只在最后看一次。多数团队每天都看。每多看一次就多一次误报的机会,机会会累加。
我们换一批新的 10,000 对,在每组 5,000 位访客的过程中按相等的步长检查,只要任何一次检查显著就立刻停下:
| 查看次数 | 被判显著的测试比例(两组完全相同) |
|---|---|
| 1(只在最后) | 4.8% |
| 2 | 8.5% |
| 5 | 14.2% |
| 10 | 18.5% |
| 20 | 25.1% |
5% 水平下看 20 次,20 分之一的风险变成了 4 分之一。Evan Miller 那篇著名的文章用另一种设计报告了同样的效应:基线 50%,一旦检查达到 5% 或到 150 个观察就停,误报率是 26.1%,他还指出,提前定好样本量就能消除这个问题。
这些数字也说明,A/A 测试是让团队明白「周二显著了」不是结果,而且代价很小的办法。在允许大家偷看的条件下跑一次,给大家看上面这张表,然后约定样本量和读数日期。
完全相同的两组被判显著的比例,按查看次数
示例数据,占 10,000 次 A/A 测试 %A/A 测试需要多少流量
A/A 测试需要足够多的访客,让它的噪声和你以后想找的效应大小相称。用两个比例的标准正态近似,5% 水平取 1.96,80% 检验力取 0.84。
示例数据:基线转化率 4%,每组 5,000 位访客。
- 差值的标准误 = √(2 × 0.04 × 0.96 ÷ 5,000) = 0.39 个百分点。
- 两个相同的组,差距超过 1.96 × 0.39 = 0.77 个点的情况大约占 5%。
- 这个规模能可靠检出的最小真实差异是(1.96 + 0.84)× 0.39 ≈ 1.1 个点,相当于 4% 基线的 27%。
所以每组 5,000 位时,0.5 个点(相对 12.5%)的真实提升看不见,任何小于 0.77 个点的 A/A 差异都只是噪声。如果团队想在 4% 基线上找到相对 10% 的提升(0.4 个点),同样的近似要求每组约 39,500 位访客,而不是 5,000。无论规模多大,A/A 测试只能说明工具在这个规模下的情况。
什么时候值得做 A/A 测试
A/A 测试花流量、花时间,而且对你的页面什么也没测。按这些规则判断:
- 要做:采用或更换实验工具、改变访客分配或识别方式、新增主要指标、遇到解释不了的样本比例失衡时。
- 可以不做:工具和指标已经验证过,并且每次测试都会自动检查分流。分流检查不花成本,因为它只需要你已有的人数。
- 流量少就在站点的一部分上做。 小一点的 A/A 测试仍然能验证分流和事件数,只是无法精确确认 5% 的误报率。
大规模做实验的研究者把 A/A 测试和样本比例检查当作平台本身的数据质量保障,所以有变动时跑一次,理由是一样的。
A/A 测试失败了怎么办
| 现象 | 可能原因 | 要检查什么 |
|---|---|---|
| 各组人数差几个百分点 | 重定向、加载慢的版本、机器人被分配 | 按浏览器、设备、国家比较分流 |
| 某一组事件更少 | 某个版本里追踪代码缺失或被拦截 | 两组触发同一个测试事件并计数 |
| 多次重复都显著 | 偷看,或统计单位与指标不一致(访客与会话) | 定好样本量,按同一单位计数 |
| 多次运行也从不显著 | 方差被高估,或指标被截断 | 比较两组指标的原始离散程度 |
在 TapCub 里做好铺垫
TapCub 不分流量、不做实验,只做衡量。A/A 测试发生在衡量这一侧的部分仍然有用,你可以先演练一遍。
- 在全端分析 › 用户 › 分群与标签里用随机分桶条件建两个分群,各装一半的访客。
- 在全端分析 › 行为分析 › 行为分析里,对每个分群跑同一个目标漏斗(分群可以带进漏斗),比较完成率。
- 用上面的检查比较两组的访客数。差异落在噪声范围内才是你想看到的。
- 打开网站统计 › 机器人,确认自动化流量和访客分开统计,因为机器人只被分到一组是失衡的常见原因。机器人和 AI 爬虫不在访客数里,也不在转化率的分母里。
如果你的实验工具把版本写进事件属性,就可以按同样的目标比较各组。分流本身和谁赢的决定,仍然留在那个工具里。
常见问题
A/A 测试是什么?
A/A 测试把访客分成两组,给两组看同一个页面。它的用途是检查实验搭建,而不是选出赢家:分流、追踪和误报率都应该符合预期。
A/A 测试要跑多久?
跑完你事先定好的样本量,再向上取整到整周。基线 4%、可检出差异 1.1 个点时,每组约 5,000 位访客;要检出相对 10% 的提升,约 39,500 位。
A/A 测试出现显著结果正常吗?
正常。5% 水平下大约 20 次有 1 次。所以一次显著结果的意义是重复并检查分流,而不是证明工具坏了。
「AT test」是什么意思?
统计学里没有标准的「AT test」。输入这个词的人通常指 A/A 测试、A/B 测试或 t 检验。本文讲的是 A/A 测试。
每个团队都应该做 A/A 测试吗?
不用。采用工具、或改变访客的分配与计数方式时做一次。如果搭建已经验证过,并且每次测试都检查自己的分流,可以不做。
资料来源
- Evan Miller,How Not To Run An A/B Test:持续偷看时误报率 26.1%;提前定好样本量。核对于 2026-11-21。
- NIST/SEMATECH 统计方法电子手册,7.3.3 比较两个比例:模拟中用的合并比例 z 统计量。核对于 2026-11-21。
- NIST/SEMATECH 电子手册,1.3.5.15 卡方拟合优度检验:样本比例检查用的统计量。核对于 2026-11-21。
- Larsen 等,Statistical Challenges in Online Controlled Experiments: A Review of A/B Testing Methodology:A/A 测试和样本比例失衡检查是平台数据质量检查。核对于 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
