AI 归因是用来源域名和 UTM 标记,把访问和注册记到把人送来的 AI 助手名下,同时把爬虫读取单独计数,因为它们代表曝光而不是访问。总会有一部分 AI 访问落进直接访问,所以要报告「已观察到的数字,加上一个怀疑范围」,而不是一个看似精确的单值。
读完你会知道
- 把真人访问和爬虫读取分开:示例里同一运营方的 4,510 次答案引擎读取只带回 96 个访客
- 别拿几个注册给助手排名:13 个注册对应 4.3%–12.0% 的区间
- 把隐藏的直接访问按范围报告(观察到 180,最多 580),并留在 AI 渠道之外
AI 归因是什么,为什么总是少算
AI 归因,是把访问、注册和成交记到把这个人送来的 AI 助手名下:ChatGPT、Perplexity、Gemini、Claude、Copilot 等。它有两半,常被混在一起。真人访问是点了答案里的链接、落到你网站的人;爬虫读取是程序为了训练模型、建搜索索引或回答问题而抓取你的页面。只有前一半是通常意义上的归因,后一半是曝光。
结果一定偏少。有的助手发来源,有的不发,浏览器也可能在来源到你这里之前把它去掉;没有来源的访问会记成直接访问。所以老实的结果是一个范围:你能看到的,加上你怀疑藏在直接流量里的。本文逐项讲怎么测,并把两半分开。
能观察到的四种信号
| 信号 | 它能说明 | 它看不到 |
|---|---|---|
| 来自 AI 产品的来源页 | 有人点了链接并到达;能分出是哪个助手 | 来源被去掉或根本没发的访问 |
| 链接上的 UTM 标记 | 一个有名字的来源和活动(助手或你自己加了的话) | 你控制不了的链接;引用了你的网址但没带标记的答案 |
| 服务端或机器人数据里的爬虫读取 | 内容被读了,哪个运营方读的,用途是什么 | 有没有人看到;多数读取不会带来任何人 |
| 直接流量在深层页面上的突增 | 暗示存在没打标记的 AI 访问 | 证据:邮件、App、书签造成的现象一模一样 |
四种都用,按可信度从高到低排。来源页和 UTM 能证明访问;爬虫数据能证明曝光;直接流量的信号只能告诉你该去哪里查。
正确读懂爬虫数据:读取不是访问
运营方公开了各自爬虫的作用,用途不同,所以先按用途分组再计数。
| 运营方 | 爬虫 | 用途(出自运营方文档) | robots.txt |
|---|---|---|---|
| OpenAI | OAI-SearchBot | 让网站出现在 ChatGPT 的搜索功能里 | 适用 |
| OpenAI | GPTBot | 抓取可能用于训练生成式 AI 模型的内容 | 适用 |
| OpenAI | ChatGPT-User | 用户向 ChatGPT 或自定义 GPT 提问时访问页面 | 可能不适用,因为是用户发起的 |
| Perplexity | PerplexityBot | 让网站出现在 Perplexity 搜索结果里并附链接,不用于训练基础模型 | 适用 |
| Perplexity | Perplexity-User | 用户提问时访问页面 | 一般不遵守 robots.txt,因为是用户触发的 |
由此有三点:
- GPTBot 这类训练爬虫可以读几千个页面而一个访客都没带来。它的读取量衡量的是训练曝光,不是流量。
- 搜索或答案类爬虫(OAI-SearchBot、PerplexityBot)的读取才可能变成引用和点击。
- 用户触发的抓取(ChatGPT-User、Perplexity-User)说明那一刻有人问到了你的页面。它不是对你网站的访问,但比定时抓取更能说明兴趣。
如果你在 robots.txt 里屏蔽爬虫,先读运营方的说明:屏蔽训练爬虫不会让搜索爬虫看不到你,反过来也一样。单个爬虫的细节见 GPTBot 和 PerplexityBot。
按来源页归因访问,再做对比
建一条渠道规则,把各 AI 产品的来源域名(chatgpt.com、perplexity.ai、gemini.google.com、claude.ai、copilot.microsoft.com)映射到一个「AI 助手」渠道,同时保留域名作为来源以便拆分。浏览器会按引荐策略决定发什么;现代浏览器的默认策略(strict-origin-when-cross-origin)对跨站链接仍会发送来源域名,但带 rel="noreferrer" 的链接或更严的策略什么都不发。所以总有一部分 AI 访问会落进直接访问。
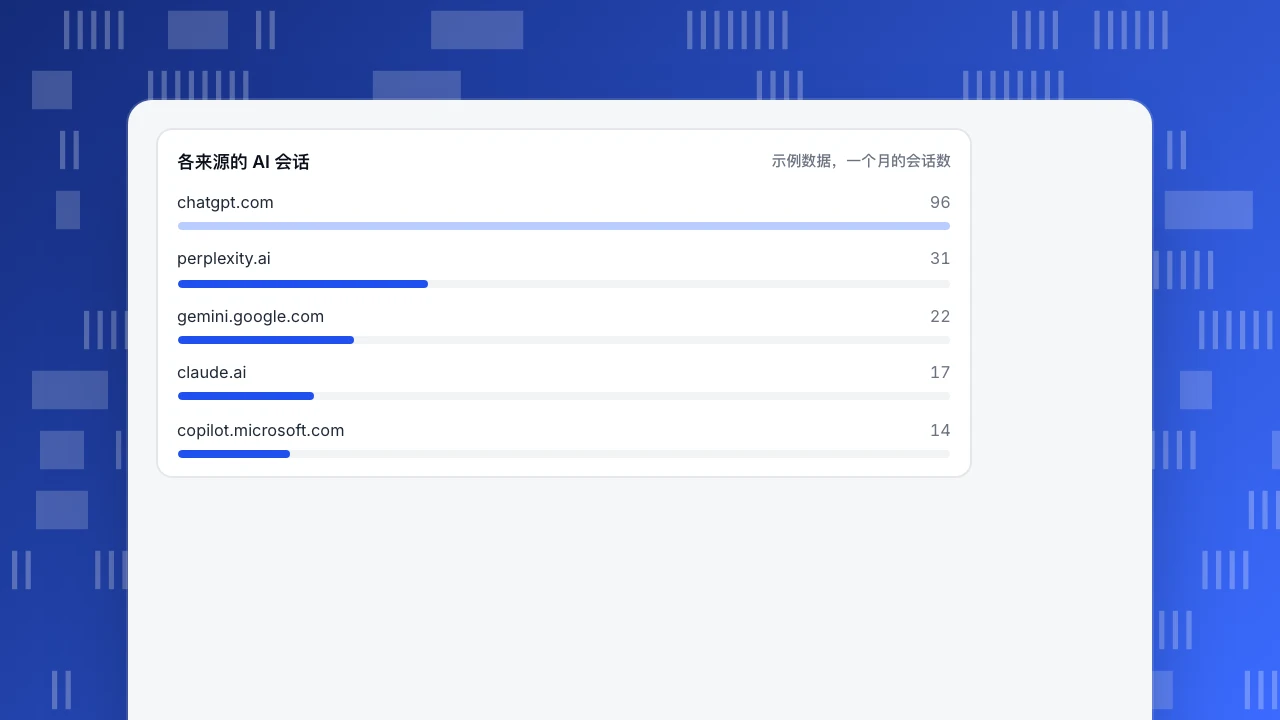
示例数据:一个月,24,000 个真人会话。
| 来源 | 会话 | 注册 | 注册率 |
|---|---|---|---|
| chatgpt.com | 96 | 7 | 7.3% |
| perplexity.ai | 31 | 3 | 9.7% |
| gemini.google.com | 22 | 1 | 4.5% |
| claude.ai | 17 | 2 | 11.8% |
| copilot.microsoft.com | 14 | 0 | 0.0% |
| AI 合计 | 180 | 13 | 7.2% |
AI 来源占会话的 180 ÷ 24,000 = 0.75%。拿同一个月的自然搜索对比:9,600 个会话、192 个注册,注册率 2.0%。
各来源的 AI 会话
示例数据,一个月的会话数别把小渠道的数字读过头
AI 访客的注册率是 7.2%,自然搜索是 2.0%。对这两个比例做两比例 z 检验,z = (0.0722 − 0.02) ÷ 0.0108 = 4.8,显著。但这 7.2% 只建立在 13 个注册上。13 对 180 的 95% Wilson 区间是 4.3% 到 12.0%,范围接近三倍。
判断规则:报告比例时带上区间;只有各来源都至少有 30 个转化时,才去比较来源之间(ChatGPT 7.3% 对 Perplexity 9.7%)。现在只有 7 个和 3 个注册,这两个数字谁大谁小还没有意义。数量上来之前,先在渠道层面汇总。
还要记住是谁在点击。从答案里点进来的人通常已经读过摘要,并选了你的页面,所以带着意图。比搜索更高的转化率是合理的;把它当作下个月要复测的假设,而不是助手之间的排名。
估算藏起来的那部分,但不要把数字撑大
有些 AI 访问到达时没有来源。要估它的大小,看落在深层页面(一篇博客、一个定价页)上的直接会话,这类页面很少有人手敲或收藏。示例数据:深层页面上的直接会话通常每月约 1,000 个,这个月是 1,400 个。
多出来的 400 个只是候选,不是 AI 访问。归给 AI 之前先查三件事:
- 突增是否从你被引用的日期开始,或从某条新答案开始引用你的网址那天开始。
- 落地页是不是助手引用的那些页面。
- 没有邮件群发、App 发版或活动可以解释它。
结果按范围报告:观察到的 AI 会话 180 个,如果多出的直接会话全是 AI 则最多 580 个。把那 400 个留在 AI 渠道之外,这样你逐月跟踪的数字才站得住。
把爬虫读取和它们带回的访客放在一起比
有用的比值是每个访客对应的读取数:运营方每送来一个人,读了你的页面多少次。同一个月的示例数据:
| 运营方 | 训练读取 | 答案引擎读取 | 带来的访客 | 每个访客对应的读取 |
|---|---|---|---|---|
| OpenAI | 18,500 | 4,510 | 96 | 47 : 1(仅答案引擎);240 : 1(全部读取) |
| Perplexity | — | 1,900 | 31 | 61 : 1 |
OpenAI 的答案引擎读取是 OAI-SearchBot(4,200)加 ChatGPT-User(310)。除以 96 个访客,大约每个访客对应 47 次读取;算上 GPTBot 的 18,500 次训练读取,23,010 ÷ 96 约为 240。
看趋势,不看水平。读取翻倍而访客不变,说明内容被用了但没被引用;访客上升而读取不变,说明已有的引用被点得更多了。
| 信号 | 它能说明 | 它看不到 |
|---|---|---|
| 来自 AI 产品的来源页 | 有人点击并到达;是哪个助手 | 来源被去掉的访问 |
| 链接上的 UTM 标记 | 一个有名字的来源和活动 | 你控制不了的链接 |
| 爬虫读取 | 内容被谁读了、为什么读 | 有没有人看到 |
| 深层页面上的直接流量突增 | 暗示有未标记的访问 | AI 是原因的证据 |
四种都用,按可信度排序:来源页和 UTM 能证明访问,爬虫数据能证明曝光,直接流量突增只能说明去哪里查。
把结果写成带范围的报告
把数字写进一段让管理者不看方法也能读懂的话。用示例数字写的模板:
「10 月,AI 助手带来 180 个会话(占真人会话的 0.75%)和 13 个注册(7.2%,95% 区间 4.3% 到 12.0%),自然搜索是 2.0%。深层页面上另有 400 个直接会话高于常态,不计入 AI。OpenAI 的搜索和答案类爬虫读取了我们的页面 4,510 次,带来 96 个访客。」
三个习惯能让报告保持老实:写明是哪个月、包含哪些来源;转化数不到 100 时一律给出区间;写明排除了什么。下个月只改数字,趋势才有可比性。
在 TapCub 里跟踪 AI 归因
拿上面这个月的示例,从头到尾设置一遍。
- 看人。 打开 网站统计 › 来源,进入 AI 来源 页签。它统计从 AI 产品来的真人会话,依据来源域名和 UTM,并且和爬虫读取分开。来源规则可以在 配置 › 网站设置 里改,历史数据可以重新计算。
- 比转化。 渠道表里有转化列,可以把 AI 渠道和自然搜索放在一起看;注册用 网站统计 › 目标 来定义。
- 看爬虫。 网站统计 › 机器人 有 AI 与智能体、全部机器人、访问记录 三个页签。AI 内容账本 按运营方列出读取次数,训练爬虫和答案引擎分两列,同时给出带回的真人访客和读取与访客的比值。
- 注意限制。 只装页面脚本时,不执行 JavaScript 的爬虫看不到;爬虫请求要走服务端接口发送。只有 Applebot 做 DNS 反查验证,其他机器人显示为未验证。
- 认出这个人。 注册时调用
tapcub.login,注册的人会出现在 全端分析 › 用户 › 用户 里,时间线上能看到他的第一个来源。
TapCub 不会告诉你助手是怎么说你的,也不会猜哪些直接访问是 AI。它衡量到达了什么,以及谁读了你的页面。
常见问题
什么是 AI 归因?
AI 归因是把访问、注册和收入记到推荐这个人的 AI 助手名下。主要靠点击上的来源域名和 UTM 标记来测量。爬虫读取单独跟踪,因为它们显示的是曝光,不是访问。
怎么追踪来自 ChatGPT 的流量?
在分析工具的渠道规则里把 chatgpt.com 映射到 AI 渠道,并拿它的转化和其他渠道比。预期会有缺口:没有来源的访问会落进直接访问。留意直接流量在深层页面上的突增,并把它们排除在 AI 数字之外。
为什么 AI 流量显示成直接访问?
没有来源到达,就是直接访问。浏览器可能去掉它,链接可能带 rel="noreferrer",App 打开链接时也可能不带。所以 AI 访问适合报告成「已观察到的数字,加上一个怀疑范围」。
AI 爬虫流量和 AI 引荐流量一样吗?
不一样。爬虫读取是程序抓取你的页面用于训练、索引或回答;引荐流量是真人点击进入。示例里 OpenAI 的 4,510 次答案引擎读取只带来 96 个访客。
要不要屏蔽 AI 爬虫来保护流量?
屏蔽 GPTBot 这类训练爬虫,只是不让它把内容用于训练,对搜索爬虫没有影响,搜索爬虫有自己的 robots.txt 规则。按爬虫和用途分别决定,并在前后对比每个访客对应的读取比值。
资料来源
- OpenAI,OpenAI 爬虫概览:OAI-SearchBot、GPTBot、ChatGPT-User 的用途和 robots.txt 行为。核对日期 2026-11-21。
- Perplexity,Perplexity 爬虫:PerplexityBot 和 Perplexity-User。核对日期 2026-11-21。
- MDN Web Docs,Referrer-Policy 响应头:浏览器发送的来源信息和默认策略。核对日期 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
