设计评审常常以各说各话结束。用户体验指标用数字代替观点:人们能不能完成任务、要多久、出多少错、感觉如何。本文列出有用的指标,讲 Google 的 HEART 框架,并走一遍一次结账改版:同时用行为数据和问卷数据来衡量。
读完你会知道
- 行为指标和态度指标搭配使用
- 任务成功、任务用时和错误说明设计能不能用
- SUS 约 68 分是平均水平
- 用 HEART 为每个项目选目标、信号和指标
- 上线前定基线,并检验显著性
什么是用户体验指标?
用户体验指标(UX metrics)是衡量产品用户体验好不好的量化指标:人们能不能完成任务、要花多久、出多少错、感觉如何、会不会继续用。有了它们,设计团队就能比较版本、设定目标,用数字而不是观点来说明设计工作的效果。
用户体验指标分两大类:
- 行为指标 衡量人们做了什么:任务成功、任务用时、错误、放弃、挫败点击。
- 态度指标 衡量人们说了什么:满意度、主观易用性、推荐意愿。
两类都需要。勉强、缓慢地完成任务的用户仍可能流失;说喜欢某个功能却从来不用的用户,也不能证明它有价值。
最有用的用户体验指标
| 指标 | 类型 | 怎么测 | 说明什么 |
|---|---|---|---|
| 任务成功率 | 行为 | 完成某项既定任务的用户占比 | 设计到底能不能用 |
| 任务用时 | 行为 | 完成任务用时的中位数 | 效率 |
| 错误率 | 行为 | 每次尝试中的错误(走错路、校验报错) | 设计在哪里误导人 |
| 放弃率 | 行为 | 开始一个流程却没走完就离开的占比 | 哪里摩擦最大 |
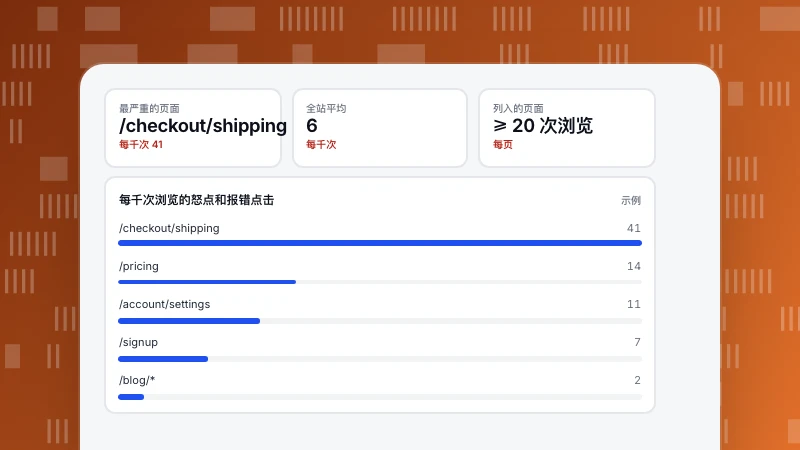
| 愤怒点击和报错点击 | 行为 | 快速重复点击;点击后紧接着脚本报错 | 线上流量里的挫败感 |
| 系统可用性量表(SUS) | 态度 | 10 题问卷,0–100 分 | 整体主观可用性 |
| 单项易用性问题(SEQ) | 态度 | 任务后问「这个任务有多容易?」1–7 分 | 单个任务的主观难度 |
| CSAT | 态度 | 一次交互后的满意度评分 | 对某个时刻的满意度 |
| 净推荐值(NPS) | 态度 | 推荐意愿,0–10 分 | 整体忠诚度,不是可用性 |
| 采用和留存 | 行为 | 使用某功能的占比;回访的占比 | 体验是否带来持久价值 |
SUS 方面,常被引用的跨研究平均分约为 68:高于 68 算高于平均,低于 68 说明有可用性问题。
框架:Google HEART 和「目标—信号—指标」
Google 研究员 Kerry Rodden、Hilary Hutchinson 和 Xin Fu 提出了用于大规模衡量用户体验的 HEART 框架:
| 维度 | 问题 | 指标例子 |
|---|---|---|
| Happiness 愉悦度 | 用户喜欢吗? | SUS、CSAT、满意度调查 |
| Engagement 参与度 | 用得多吗? | 每周会话数、每次会话的操作数 |
| Adoption 采用 | 新用户或新功能被用起来了吗? | 头一周使用某功能的新用户占比 |
| Retention 留存 | 用户会回来吗? | 30 天后再次活跃的占比 |
| Task success 任务成功 | 能完成他们要做的事吗? | 完成率、任务用时、错误 |
每个维度都要选定一个目标(体验应该达成什么)、能显示进展的信号,以及把信号变成数字的指标。不是每个项目都需要五个维度:结账改版可能只看任务成功和愉悦度,新功能则看采用和留存。
| HEART | 指标例子 |
|---|---|
| 愉悦度 | SUS、CSAT |
| 参与度 | 每周会话数 |
| 采用 | 头一周的功能使用 |
| 留存 | 30 天后再次活跃 |
| 任务成功 | 完成率、用时、错误 |
用到的每个维度都要选目标、信号和指标。
算例:衡量一次结账改版
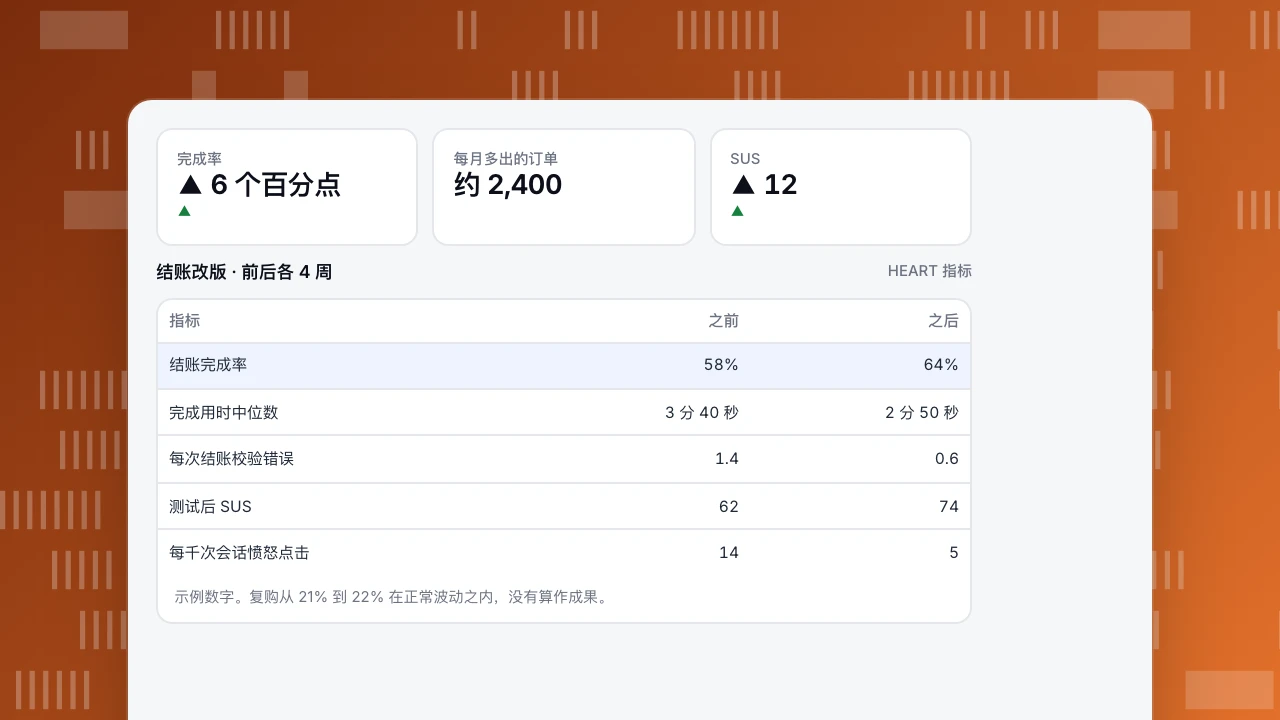
一家网店改版了结账:三页改成一页,加了地址自动补全,错误提示更清楚。团队在上线前定好 HEART 指标,比较前后各四周(示例数字):
| HEART 维度 | 指标 | 之前 | 之后 |
|---|---|---|---|
| 任务成功 | 结账完成率(开始 → 付款) | 58% | 64% |
| 任务成功 | 可用性测试成功,10 名参与者 | 7 / 10 | 9 / 10 |
| 任务成功 | 完成用时中位数 | 3 分 40 秒 | 2 分 50 秒 |
| 任务成功 | 每次结账的表单校验错误 | 1.4 | 0.6 |
| 愉悦度 | 测试后 SUS | 62 | 74 |
| 愉悦度 | 每千次结账会话的愤怒点击 | 14 | 5 |
| 留存 | 60 天内复购 | 21% | 22% |
每月 40,000 次结账开始,完成率提高 6 个百分点,约等于多 2,400 笔订单。团队也谨慎地没有过度宣称:复购从 21% 到 22% 在正常的月度波动之内,所以报告为「没有可检测的变化」,而不是一次胜利。
行为数据还发现了一个可用性测试漏掉的问题:愤怒点击集中在「使用优惠码」链接上,在部分 Android 浏览器里它会把输入框收起而不是展开。下一周就修好了。
完成率
▲ 6 个百分点
▲
每月多出的订单
约 2,400
SUS
▲ 12
▲
结账改版 · 前后各 4 周
HEART 指标| 指标 | 之前 | 之后 |
|---|---|---|
| 结账完成率 | 58% | 64% |
| 完成用时中位数 | 3 分 40 秒 | 2 分 50 秒 |
| 每次结账校验错误 | 1.4 | 0.6 |
| 测试后 SUS | 62 | 74 |
| 每千次会话愤怒点击 | 14 | 5 |
示例数字。复购从 21% 到 22% 在正常波动之内,没有算作成果。
怎么选用户体验指标
- 从你要改的流程的用户目标出发,而不是从手头有哪些指标出发。
- 每个项目选一个主指标,再加两三个辅助指标。
- 行为和态度指标搭配: 一个告诉你发生了什么,一个告诉你感觉如何。
- 加一个护栏指标,它不应变差,比如错误率或客服工单。
- 上线前先定基线,并约定什么样的变化算成功。
- 宣称小差异之前先看显著性,尤其是小样本的可用性测试。
常见误区
- 把 NPS 当可用性指标。 它衡量忠诚度,还取决于价格、客服和品牌。
- 任务用时报平均值。 用时分布是偏的,要用中位数。
- 把十人测试当精确数字。 7/10 和 9/10 是信号,不是精确的比率。
- 只在上线后测量。 没有基线就没法比较。
- 指标太多。 一个放了 30 个体验指标的看板,最后哪个都不会被拿来行动。
在 TapCub 里衡量用户体验
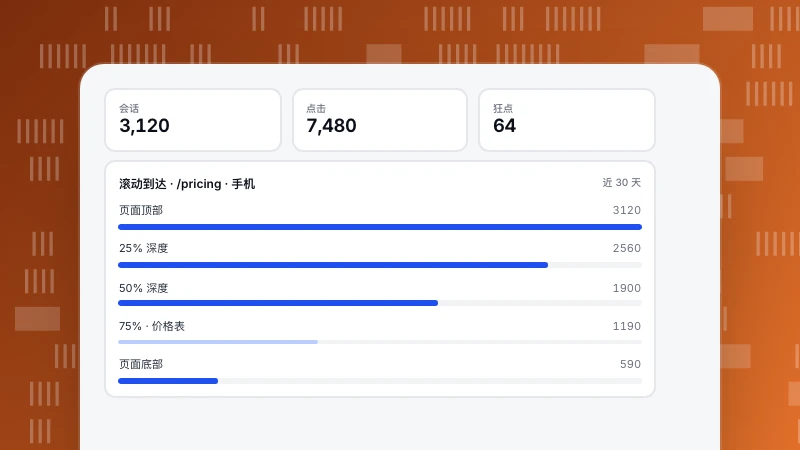
TapCub 从线上流量覆盖行为这一侧。漏斗给出任意流程的完成率和流失(创建漏斗、解读漏斗流失)。监测 › 错误 按页面列出愤怒点击(500 毫秒内同一元素至少点 3 次)和报错点击(点击后 1 秒内出现脚本错误)。热力图展示人们点在哪里、滚到哪里(创建热力图),表单追踪显示哪些字段导致放弃(追踪表单提交)。SUS 或 CSAT 等态度分数用你的问卷工具收集,再作为事件属性发送,就能和行为放在一起比较。延伸阅读:用户体验分析、用户摩擦 和 怎么看热力图。
另见:无效点击(Dead Click)。
资料来源
- Rodden、Hutchinson、Fu,Measuring the user experience on a large scale: user-centered metrics for web applications(Google,CHI 2010)。
- MeasuringU,Measuring usability with the System Usability Scale (SUS)。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。