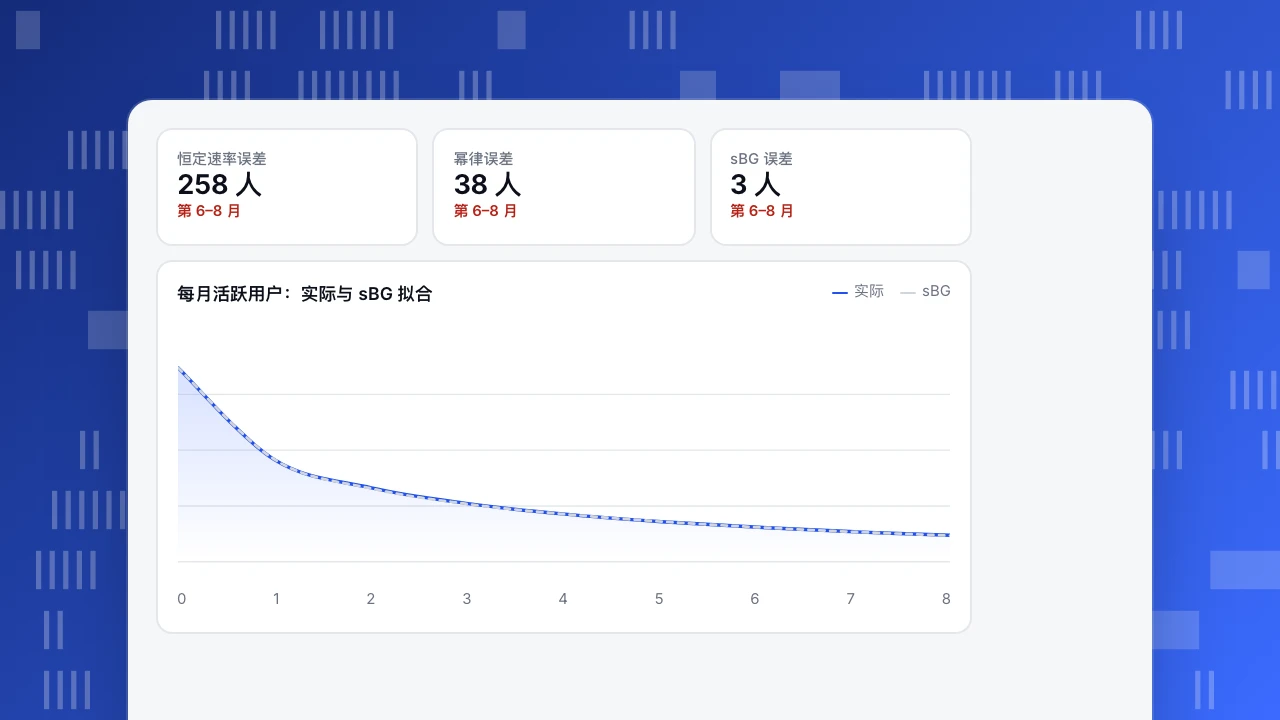
留存建模,是用一个同期群前几个月的留存数据拟合曲线,推算之后还有多少用户活跃。不要用恒定月留存率:注定要走的用户走得早,它会推算出过少的留存用户。示例里,解释曲线为何变平的模型在留出月份上只差 2 人,而恒定速率差了 126 人。
读完你会知道
- 逐月留存率在上升(62.0% 到 95.4%),说明用户是混合的,恒定速率会失败
- 每个模型都要在它没见过的月份上测试:总误差恒定 258 人、幂律 38 人、移位贝塔几何 3 人
- 推算不要超过观测历史的大约两倍:2,000 人里第 12 个月 531 人,第 24 个月 409 人
留存建模是做什么的
留存建模,是取一个同期群前几个月的留存数据拟合出一条曲线,从而推算第 12 个月或第 24 个月还会有多少用户活跃。重点不在曲线是否优雅,而在把「第一个月回来了 62%」变成「一年后大约还剩 27%」,这才是预算、生命周期价值估算和容量规划需要的东西。
要避免的错误是挑最简单的曲线。留存几乎从不按恒定速率衰减,因为注定要走的用户很早就走了,剩下的留下来。忽略这一点的模型会推算出过少的留存用户。本文给同一个示例同期群拟合三个模型,在模型没见过的月份上测试,再用经得起检验的那个推算留存用户。读曲线本身见留存曲线,建同期群表见如何做同期群分析。
先从你已经有的同期群表开始
示例数据:同一个月注册的 2,000 名用户,以及之后每个月有多少人活跃。
| 月份 | 活跃用户 | 相对第 0 月的留存 | 相对上月的留存 |
|---|---|---|---|
| 0 | 2,000 | 100.0% | — |
| 1 | 1,240 | 62.0% | 62.0% |
| 2 | 1,010 | 50.5% | 81.5% |
| 3 | 880 | 44.0% | 87.1% |
| 4 | 792 | 39.6% | 90.0% |
| 5 | 730 | 36.5% | 92.2% |
| 6 | 684 | 34.2% | 93.7% |
| 7 | 647 | 32.4% | 94.6% |
| 8 | 617 | 30.9% | 95.4% |
看最后一列。逐月留存率从 62.0% 一路升到 95.4%。这是同期群由不同类型用户组成的典型特征:有些人几乎立刻就走,有些人留很久,随着走的人退出,平均值不断变好。任何假设每月固定一个速率的模型,在这份数据上都会失败。下面三节展示差得有多远。
为了公平比较,每个模型都只用第 0 到 5 个月拟合,把第 6、7、8 个月(684、647、617 人)留作测试。
| 月份(留出) | 实际 | 恒定速率 | 幂律 | sBG |
|---|---|---|---|---|
| 6 | 684 | 639 | 694 | 684 |
| 7 | 647 | 560 | 660 | 646 |
| 8 | 617 | 491 | 632 | 615 |
| 误差绝对值合计 | 258 | 38 | 3 |
示例数据:模型用 2,000 人同期群的第 0 到 5 个月拟合,在第 6 到 8 个月测试。
模型 1:恒定月留存率
最简单的模型认为每个用户每月留下的概率都相同,所以留存用户按固定比例缩小:users(t) = users(1) × r^(t−1)。用第 1 到 5 个月拟合 r,得到 r = (730 ÷ 1,240)^(1/4) = 0.876。
第 6 到 8 个月的预测:639、560、491 人。实际是 684、647、617。模型分别偏低 45、87 和 126 人,差距逐月扩大。它把早走的人和忠诚用户当成同一群、每月 12.4% 地离开,所以不停地减掉已经不再有风险的用户。
只有在你有充分理由认为用户都差不多时才用这个模型,比如固定时长的短期试用,几乎所有人行为一致。
模型 2:幂律曲线
幂曲线 retention(t) = c × t^k 一开始下降很快、随后变平,和实际形状更接近。用第 1 到 5 个月的留存取对数,对月份取对数做回归即可拟合。在这个样本上,c = 0.626,k = −0.329。
第 6 到 8 个月的预测:694、660、632 人,实际是 684、647、617。误差是 +10、+13、+15:略偏高,并缓慢增大。幂曲线是个好用的描述工具,而且永远不会到零。这也是它的弱点:它不解释曲线为什么变平,所以不知道什么时候该变得更平。它还依赖时间刻度:第 1 个月的值固定为 c,所以拟合结果取决于你把哪个月叫作第 1 个月。
模型 3:移位贝塔几何模型
移位贝塔几何(sBG)模型出自 Fader 和 Hardie,它是解释形状,而不是硬拟合形状。它假设每个用户有自己的流失概率 p,随时间不变,而 p 在用户之间服从由 α 和 β 两个参数决定的贝塔分布。p 高的用户先走,留下的是 p 低的,于是同期群的留存率自己就会上升。留存函数是:
S(t) = B(α, β + t) ÷ B(α, β),其中 B 是贝塔函数
作者指出,这个模型用一张简单的 Excel 表格就能实现;α 和 β 通过让观测人数的似然最大来求得。用示例同期群的第 0 到 5 个月,拟合结果是 α = 0.386、β = 0.632。用户的平均流失概率是 α ÷ (α + β) = 0.379。
第 6 到 8 个月的预测:684、646、615 人,实际是 684、647、617。误差是 0、−1、−2。模型从没见过这几个月,仍然落在两个人以内。
在模型没见过的月份上比较三个模型
| 月份(留出) | 实际 | 恒定速率 | 幂律 | sBG |
|---|---|---|---|---|
| 6 | 684 | 639 | 694 | 684 |
| 7 | 647 | 560 | 660 | 646 |
| 8 | 617 | 491 | 632 | 615 |
| 误差绝对值合计 | 258 | 38 | 3 |
外推的差距比测试期的差距更大。同样用第 0 到 5 个月去推第 12 个月:恒定速率模型说 289 人,幂律说 553 人,sBG 说 529 人。用第一个数字的规划者会预期留住同期群的 14%,用第三个数字的则预期 26%。到底该信哪个,要靠留出测试来回答。
信任任何推算之前先做这个测试:把数据的最后三分之一藏起来,用其余部分拟合,然后对比。如果表现最突出的模型在藏起来的月份上偏差超过 5%,就不要外推太远。
推算留存用户
用全部九个月重新拟合 sBG:α = 0.383、β = 0.627。检查拟合是否稳定:用第 0 到 5 个月拟合时第 12 个月是 529,用全部数据拟合是 531。
| 月份 | 推算活跃用户(2,000 人中) | 留存率 |
|---|---|---|
| 12 | 531 | 26.6% |
| 18 | 457 | 22.8% |
| 24 | 409 | 20.5% |
对一个行为相同、5,000 人的新同期群,预期第 12 个月约有 1,328 人活跃(5,000 的 26.6%),第 24 个月约 1,024 人。报告时取整;如果决策很重大,给出一个范围而不是单个点。一条好规则:推算的长度不要超过观测数据的大约两倍。九个月的数据可以放心推到 18 个月,推到 24 个月就是外推了。
算生命周期价值时,把各月留存比例加起来:第 1 到 12 个月合计每位注册用户 4.42 个活跃月,第 1 到 24 个月合计 7.16 个。按示例中每个活跃月 20 计算,每位注册用户第一年是 88.4,两年是 143.1,未扣成本。
留存模型什么时候会失灵
- 混合的同期群。 把免费注册和付费注册混在一起的同期群是两个群体,要分别拟合。
- 产品或定价变化。 第 4 个月的一次改动会改变第 4 个月之后的曲线。只拟合改动之后的数据,或者做标记。
- 季节性。 12 月开始和 6 月开始的同期群形状可能不同。比较同一季节的同期群。
- 随时间变化的流失。 sBG 假设每个用户的流失概率不变。Fader 和 Hardie 后来的工作加了一个时长依赖的扩展,用于流失概率随时间上升或下降的情况。
- 收入不等于留存。 用户数的推算对花费什么都没说;收入要另外建模。
在 TapCub 里建同期群表
模型只需要分析工具提供一样东西:同期群表,TapCub 能生成它。
- 设置起始事件和回访事件。 在 全端分析 › 行为分析 › 行为分析 打开留存,选一个起始事件(比如
signup_completed)和一个回访事件。两个都留空表示任意活跃。 - 选周期。 天、周或月,最多 30 天或 12 周或 12 个月。九个月的月度数据,就选月。
- 选模式。 「第 N 期正好回来」对应上面的活跃用户表;「第 N 期或之后回来」得到一条不会再上升的曲线。
- 读表。 每一行是一个同期群,有起始日期、人数,以及每期的人数和比例;下面一行是按人数加权的平均值。还没结束的周期是空的,不是零,比例从第 1 期开始。
- 把人数复制进模型。 把最早一个完整同期群的活跃人数取出来,放进表格或脚本。
TapCub 展示留存,不拟合曲线,也不推算留存用户。模型在外部做,下个季度再用同一张表去检验预测。
常见问题
什么是留存建模?
留存建模是给一个同期群观测到的留存数据拟合一条曲线,以便推算之后各期还有多少用户活跃。它用于生命周期价值、预算和容量规划。模型应在它没见过的月份上测试。
该选哪个留存模型?
没有哪一个模型始终适用,要靠留出月份的测试来选。示例里,恒定速率模型在第 8 个月差了 126 人,幂律差 15 人,移位贝塔几何模型差 2 人。当用户离开的可能性各不相同时,sBG 是个很强的默认选择。
怎么推算客户留存?
取一个同期群随时间变化的人数,用早期的周期拟合模型,拿留出的后期数据检验,再用它向更远处推算。推算的长度不要超过观测历史的大约两倍。
为什么留存会随时间变平?
因为用户各不相同。最可能离开的人先走,剩下的人越来越忠诚。示例里逐月留存率从 62.0% 升到 95.4%,却没有任何一个用户发生变化。
需要多少个月的数据?
足够看到曲线变平,通常一个同期群至少 6 个月,再加几个月用来留出做测试。月份更少时,把推算报告成一个很宽的范围,并随着数据增加重新拟合。
资料来源
- Fader, P. S. 和 Hardie, B. G. S.,How to Project Customer Retention,Journal of Interactive Marketing(2007):移位贝塔几何模型及其表格实现。核对日期 2026-11-21。
- Fader, P. S.、Hardie, B. G. S.、Liu, Y.、Davin, J. 和 Steenburgh, T.,"How to Project Customer Retention" Revisited: The Role of Duration Dependence,Journal of Interactive Marketing 43(2018 年 8 月),第 1–16 页:针对随时间变化的流失的扩展。核对日期 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
