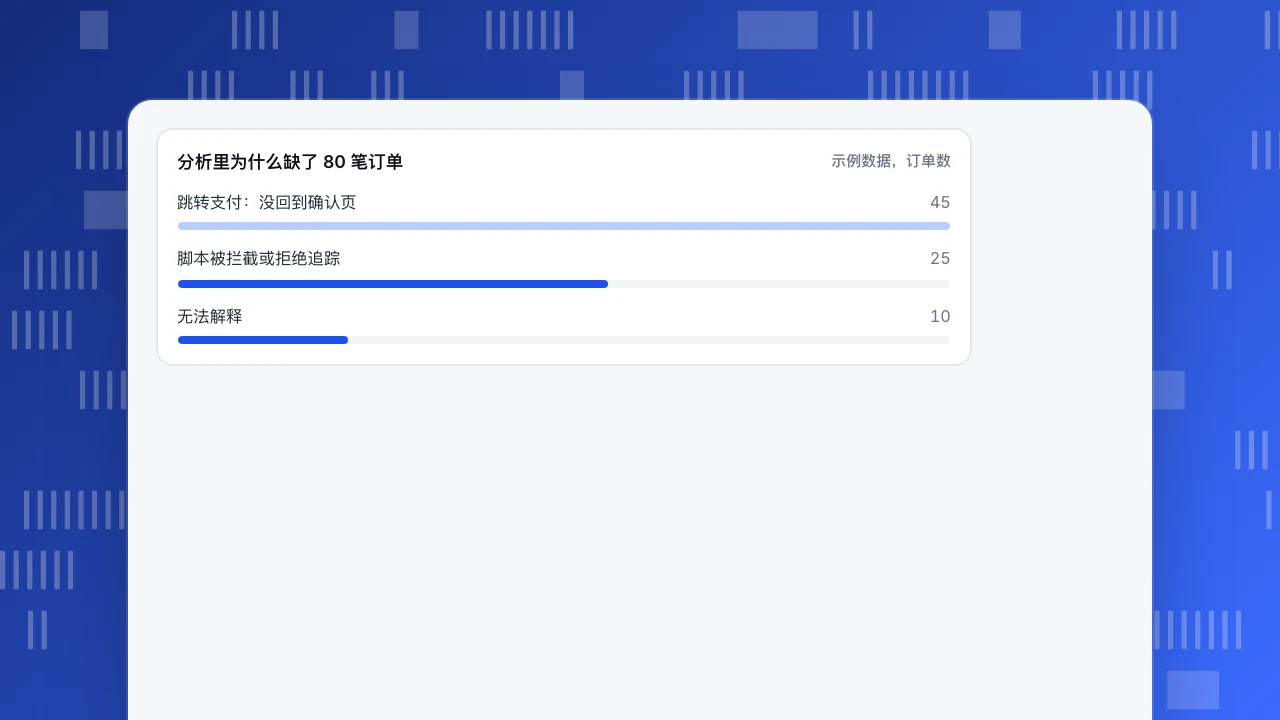
可靠的数据是误差可以预测的数据:它和第二个来源在你能解释的差距内吻合、是数出来的而不是抽样估的、每个事件只触发一次并且名称正确。示例里分析和支付数据库之间 −6.3% 的差距,在解释了缺失的 80 笔订单中的 70 笔之后只剩 0.8%。
什么样的分析数据算可靠
可靠的数据是你能预测它的误差的数据。没有哪个分析配置是精确的,所以实际的问题不是「它完美吗」,而是「我知道它偏多少吗,这个误差稳定吗」。四项检验涵盖大多数问题:一致性(和另一个来源在已知的差距内吻合)、完整性(事件和属性该到的时候到了)、抽样(数字是数出来的,而不是从一小部分估出来的)和埋点正确性(每个动作只触发一次,名字正确)。下面把每一项变成可以核对的数字。更大的话题看数据质量,数据出问题的后果看糟糕数据质量的影响。
检验一:它和第二个来源吻合吗?
选一个在两个地方都存在的数字。订单是合适的候选,因为支付数据库是事实来源。公式是:
差距 =(分析的计数 − 来源的计数)÷ 来源的计数
示例数据:一个月分析里有 1,180 笔购买,支付数据库里有 1,260 笔已付订单。
- 差距 = (1,180 − 1,260) ÷ 1,260 = −6.3%
在下判断之前,先解释这缺的 80 笔订单。示例里,45 笔是通过跳转支付、没回到确认页,25 笔来自脚本被拦截或拒绝追踪的访客,10 笔无法解释。这样解释了 80 笔里的 70 笔(87.5%),剩余是 10 ÷ 1,260 = 0.8%。
| 解释完已知原因后的差距 | 意味着什么 | 怎么办 |
|---|---|---|
| 低于 5% | 浏览器端追踪的正常水平 | 记下差距;用这个数字看趋势 |
| 5–15% | 多半有可以修的原因 | 先找最大的原因(跳转、同意、脚本加载) |
| 超过 15%,或差距逐月变化 | 配置坏了 | 修好之前不要汇报这个指标 |
这些界线是我们自己用的经验规则,不是标准。更重要的是差距有解释并且稳定:稳定的 −6% 仍然可以比较各周,而从 −2% 摆到 −14% 就不行。
分析里为什么缺了 80 笔订单
示例数据,订单数检验二:它被抽样了吗,还是从一小部分估出来的?
有些工具在查询很大时,会用一部分数据估出一个数字。Google 的文档说,标准 Google Analytics 4 属性的事件级查询配额是 1,000 万个事件;超过后它会用一部分数据并按比例放大结果,数据质量图标会显示用了多少百分比。表格超过行数上限时,Google 还会把很少出现的维度值归到「(other)」行,并把超过 500 个值的维度视为高基数。
对数字的影响,用示例数据说明:一次查询涉及 2,500 万个事件,但只用了 1,000 万个,所以抽样 40%,每个被数到的事件代表 2.5 个。如果样本里有 120 笔购买,报表显示 300。120 这个计数的粗略 95% 误差范围是 1.96 ÷ √120 = 17.9%,所以真实值大约在 246 到 354 之间。报出的 300 不算错,但环比 10% 的变化在噪声之内。
规则:汇报的每张报表都要找抽样提示;看到提示就缩短日期范围或改用标准报表;不要引用抽样查询里的小分段。
检验三:审计埋点本身
信任一个新配置之前,先做这个八项审计,每项只有通过或不通过:
| # | 检查 | 怎么测 | 什么算通过 |
|---|---|---|---|
| 1 | 每个页面都有脚本 | 打开五类页面(首页、商品、购物车、确认页、404) | 五类页面的页面浏览都出现在实时里 |
| 2 | 每个动作只触发一次 | 点一次按钮 | 一个事件,不是两个 |
| 3 | 事件名一致 | 把事件名按字母排序 | 没有 signup / sign_up / SignUp 三胞胎 |
| 4 | 必填属性到达 | 数一下属性为空的事件 | 空值低于 2% |
| 5 | 内部流量被排除 | 从办公室访问 | 你的访问被排除或被标记 |
| 6 | 机器人被去掉 | 对比请求数和访客数 | 已知爬虫单独计数 |
| 7 | 时区和货币设对 | 核对一个已知的时间戳和价格 | 与来源一致 |
| 8 | 最后一步对得上 | 检验一 | 差距有解释 |
八项过七项不等于「好」:购买事件上一项不通过,比五项无关紧要的通过更重要。按离收入多近来排序修失败项。
检验四:用合理性比值识别重复触发
有些错误在你看到任何细节之前,就先以奇怪的比值出现。示例数据:一个网站一天报告 52,000 次页面浏览和 26,000 次会话。这正好是每次会话 2.00 页,跳出率 0%。真实流量几乎不会同时出现这两点:跳出率为零意味着没人只看一页就走,而正好 2.00 意味着每次页面浏览都被数了两遍。这通常是脚本装了两遍,比如主题里一次、标签管理器里又一次。
| 比值 | 可疑的值 | 可能的原因 |
|---|---|---|
| 页面浏览 ÷ 会话 | 正好 2.00 或 3.00 | 脚本装了两遍 |
| 跳出率 | 0% 或接近全部 | 事件在加载时发送,或只追踪了第一页 |
| 必填属性为空的事件 | 超过 5% | 某条代码路径漏了属性 |
| 直接访问占比 | 突然升到 60% 以上 | 跳转去掉了来源或 UTM 标记 |
检验五:它按时到达吗?
数据迟到会让昨天的数字今天就不对了。检查两件事:事件多久出现(打开实时、触发一个事件、计时),以及从服务器发来的数据是否保留原始时间。在 TapCub 里,通过服务端接口导入、超过 72 小时的历史事件,事件时间会改成接收时间,所以早于三天前的回填会落到错误的日期。你汇报的每个指标都要注明延迟,不要拿完整的一天和不完整的一天比。
差距通常从哪里来,怎么逐项估算
出现差距时,把每个原因分别估算,不要猜。用这张清单,并为每个原因写下它解释了多少笔订单:
| 原因 | 怎么估算 | 修法 |
|---|---|---|
| 买家跳到外部支付页后没有回来 | 有支付 ID 但没有确认页事件的订单 | 支付确认时由服务器发送购买事件 |
| 脚本被拦截或拒绝追踪 | 同一小时内对比服务端订单数和浏览器端事件数 | 为关键转化增加服务端事件 |
| 数据库里的测试订单和员工订单 | 按测试标记或内部邮箱域名过滤 | 在来源计数里排除它们 |
| 退款和取消的口径不同 | 对比两个系统里的总额和净额 | 选定一个口径并写下来 |
| 午夜的时区不一致 | 把两个系统放到同一时区重新计数 | 各处使用同一时区 |
| 页面刷新导致事件重复 | 数订单 ID 相同的购买事件 | 按订单 ID 去重 |
连续一个月在每周同一天做同样的核对。差距反复出现在一两个点之内,说明它是你的配置的特性,可以容忍;差距在某次发布后跳变,说明问题出在那次发布。
在记分卡旁边留一份简短的日志:日期、指标、差距、原因、核对人。半年后有人问某个数字为什么变了,日志一行就能回答,不用再花一周去查。
一页纸可靠性记分卡
对你向别人汇报的每个指标写一行:
| 指标 | 交叉核对的来源 | 差距 | 抽样? | 审计通过项 | 结论 |
|---|---|---|---|---|---|
| 购买 | 支付数据库 | 解释已知原因后 −0.8% | 否 | 8 项中 8 项 | 可靠,照常汇报 |
| 开始注册 | 无 | 无 | 否 | 8 项中 6 项 | 只用来看趋势 |
| 分群收入 | 支付数据库 | 未测试 | 是(40%) | 8 项中 7 项 | 不要引用小分段 |
没有交叉核对的指标不是不可靠,只是未经证明。在报告里说明这一点,并把第一次交叉核对排给支撑最贵决策的那个指标。
| 检验 | 检查什么 | 什么算通过 |
|---|---|---|
| 一致性 | 与第二个来源的差距 | 解释原因后低于 5%,并且稳定 |
| 抽样 | 报表上的抽样提示 | 没有抽样,或不引用小分段 |
| 埋点审计 | 八项通过 / 不通过检查 | 收入事件上的检查全部通过 |
| 合理性比值 | 每会话页数、跳出率 | 没有正好 2.00 或 0% |
| 时效 | 动作到报表的延迟 | 已知且稳定 |
5% 和 15% 的界线是经验规则,不是标准。
在 TapCub 里怎么做
在 TapCub 里把五项检验走一遍:
- 交叉核对最后一步。 用差距公式,把网站统计 › 目标里的目标或购买数和你自己的数据库对比。控制台里的数字是实际计数,不是从一小部分估出来的。
- 验证事件方案。 在全端分析 › 数据管理 › 埋点方案里打开「实时验证(近 24 h)」,每个事件会多出两列:24 小时内的到达数,以及必填属性的完整度。完整度低只是警告,本身不会阻止接收。
- 整理名称。 新事件先进事件收件箱,认领后才进正式定义;属性字典把名称和类型集中在一处,能解决
signup/sign_up的问题。 - 把机器人分开。 认得出的机器人计入网站统计 › 机器人,不进访客数,所以不会扭曲比值。
- 持续观察。 全端分析 › 智能运营 › 监控可以按计划检查 error_rate 或保存的自定义指标并通知你;它只通知,不会修复任何东西。TapCub 不会替你审计标签,所以八项审计要自己做。
FAQ
怎么知道分析数据可不可靠?
检查四件事:和第二个来源在你能解释的差距内吻合、没有抽样、事件只触发一次且名称正确、必填属性都到了。示例里 −6.3% 的订单差距被解释到只剩 0.8%。
分析和数据库之间差多少算正常?
浏览器端追踪因为脚本被拦截和跳转,低于约 5% 很常见。5–15% 当作有可修的原因,超过 15% 当作坏了。这些是经验规则;稳定且有解释的差距比大小更重要。
分析里的数据抽样是什么?
抽样是在查询很大时,用一部分数据估出结果。在 Google Analytics 4 标准属性里,事件级配额是 1,000 万个事件;超过后结果从一部分数据按比例放大。
怎么发现重复追踪?
看页面浏览与会话的比值是否正好 2.00 或 3.00、跳出率是否为 0%,然后检查脚本是不是装了两遍,比如主题里一次、标签管理器里又一次。
多久审计一次埋点?
每次发布涉及结算、注册或脚本本身之后审计一次,其他时候每季度一次。
资料来源
- Google Analytics 帮助,About data sampling(标准属性 1,000 万个事件的配额)。
- Google Analytics 帮助,About the (other) row(表格超过行数上限时把罕见值归并;500 个值作为高基数的参考)。
- TapCub 文档,埋点方案和数据导入(docs.tapcub.com),2026-11-21 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
