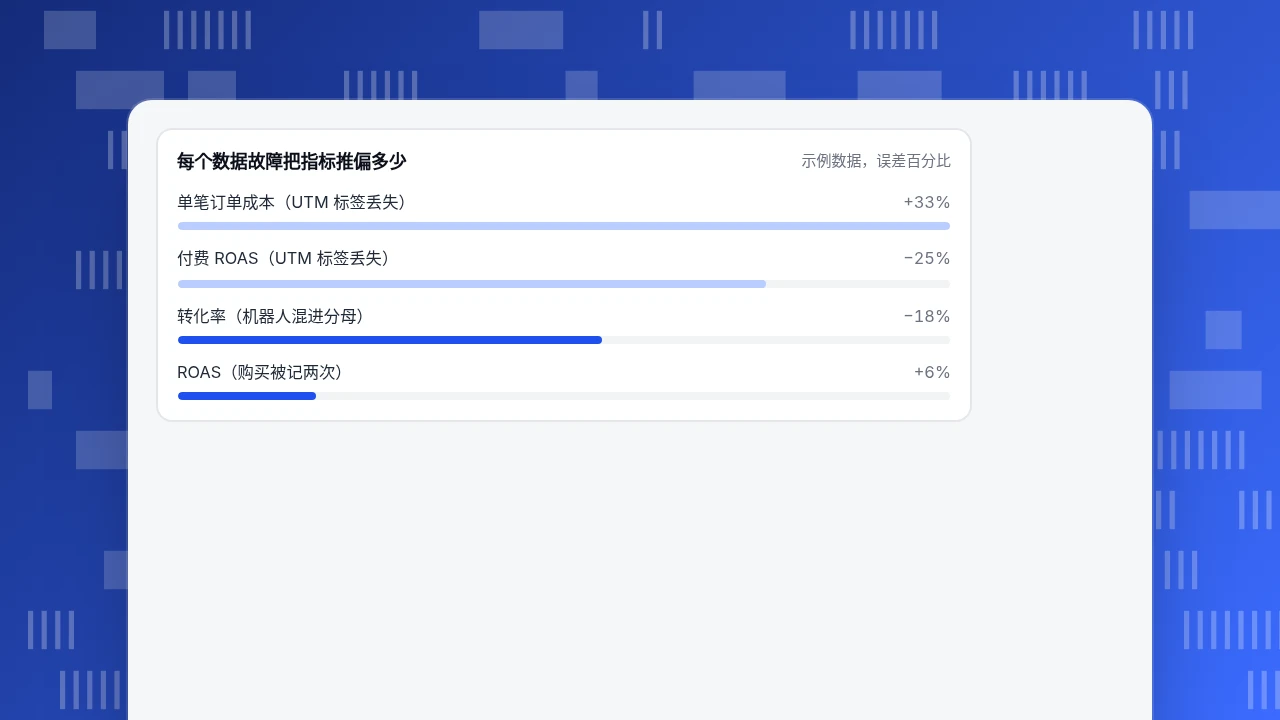
数据质量差的影响落在三个地方:决策(错数字导致错选择)、成本(人们花时间查找和修正错误)和信任(人们不再相信看板)。决策成本最大,也最难看见。下面的示例里,四分之一的付费点击丢了标签,让广告看起来贵了 33%,差点砍掉每月 9,600 美元的收入。
数据质量差会带来什么影响?
数据质量差,指数据不准确、不完整、重复、延迟或不一致。它的影响出现在三个地方,顺序很重要,因为排在前面的那个,人们最晚才会注意到:
| 方面 | 表现 | 衡量什么 |
|---|---|---|
| 决策 | 一个错误的数字导致错误的选择:从有效的渠道砍预算,把修复对准了错的页面 | 依据该指标做的决策 × 误差的大小 |
| 成本 | 人们花时间查找、修正、重新解释数据;团队重跑报表 | 返工小时数 × 每小时成本 |
| 信任 | 人们不再相信看板,转而依靠意见或私人表格 | 一个数字被质疑的频率;一个指标有几个版本 |
决策方面的代价最高,也最难看见,因为错误的数字和正确的数字看起来一模一样。本文用一家小型网店作为示例,说明怎样给这三方面各给出一个数字。数据质量本身的含义和维度,见数据质量。
| 方面 | 表现 | 衡量什么 |
|---|---|---|
| 决策 | 错误的数字导致错误的选择,比如从有效渠道砍预算 | 决策调动的金额 × 误差的大小 |
| 成本 | 人们花时间查找、修正、重新解释数据 | 返工小时数 × 每小时成本 |
| 信任 | 人们转而依靠意见或私人表格 | 有多少个指标同时流通着不止一个数字 |
行业数字只给量级;要量你自己的。
行业层面报告的成本有多大?
你会遇到两个很大的数字,两者都更适合当作量级来读,而不是对你公司的预测。
- Thomas Redman 在《哈佛商业评论》的文章里引用 IBM 的估算:2016 年质量差的数据让美国经济每年损失约 3.1 万亿美元,并提出隐藏的数据工厂:每个部门为查找和纠正错误、处理其下游影响所做的额外工作(出处)。
- Gartner 的数据质量页面引用 2020 年的研究,称数据质量差的平均成本为每个组织每年 1,290 万美元(出处)。
两者都是概括性的估算,不是对任何一家公司的测量,后者还是规模差别很大的组织的平均值。它们告诉你的是问题的形状:成本大多藏在隐性的工作和下游的错误里,而不在某个看得见的科目里。所以你必须量你自己的。
一个错误的数字怎样改变决策?
示例数据:一家网店一个月里有三个悄悄存在的数据问题。数字在下面复算。
问题 1:机器人混进分母。 工具记录了 100,000 次会话,其中 18,000 次是没人过滤的机器人。订单是 1,476 笔,全部来自真人。
- 记录的转化率:1,476 ÷ 100,000 = 1.48%。
- 真实转化率:1,476 ÷ 82,000 个真人 = 1.80%。
- 记录的转化率偏低 18%。看到“转化率 1.48%”的团队,可能会启动一次结账页改版,去弥补一个并不存在的差距。
问题 2:一笔购买被记了两次。 有人刷新确认页时,确认页会再次触发购买事件,这发生在 6% 的订单上。真实订单 1,500 笔,平均订单 80 美元,广告花费 30,000 美元。
- 真实收入:1,500 × 80 = 120,000 美元,广告支出回报(ROAS)4.00。
- 记录的订单:1,500 × 1.06 = 1,590,收入 127,200 美元,ROAS 4.24。
- 这次活动看起来比实际好 6%。误差不大,而且对每个渠道抬高的比例相同,所以排名不变;但 4.0 的目标现在看起来被轻松超过了。
问题 3:活动链接没带追踪标签。 付费广告花了 18,000 美元,带来 600 笔订单、每笔 80 美元,但四分之一的付费点击丢了 UTM 标签,被记成了直接访问。
- 真实:600 笔订单,收入 48,000 美元,ROAS 2.67,单笔订单成本 18,000 ÷ 600 = 30.00 美元。
- 付费渠道的记录:450 笔订单,收入 36,000 美元,ROAS 2.00,单笔订单成本 18,000 ÷ 450 = 40.00 美元。
- 付费渠道看起来单笔订单贵了 33%,ROAS 低了 25%。
如果团队的规则是“ROAS 低于 2.5 的渠道要砍”,记录值不达标,真实值达标。把付费砍 20%(每月 3,600 美元),就会放弃 3,600 × 2.67 = 每月 9,600 美元的收入,原因只是缺了一个标签。
每个数据故障把指标推偏多少
示例数据,误差百分比数据质量差在时间和返工上的成本是多少?
Redman 说的隐藏数据工厂是很贴切的画面:从没出现在“数据质量”预算里的人,照样在花小时数做这件事。粗略的定价方法:
年度返工成本 = 每周小时数 × 周数 × 每小时成本 × 受影响的人数
如果一位分析师每周花 5 小时去核对同一个数字的两个来源,每小时 60 美元,那就是 5 × 52 × 60 = 每年 15,600 美元,只来自一个人、一个指标。再加上问“哪个对?”的经理和去深挖的工程师,真实数字更高。
同样的算术也能给修复定价。如果每季度花半天检查一次追踪标签(4 小时 × 4 × 60 美元 = 每年 960 美元),能避免哪怕一次像上面那 9,600 美元的错误砍预算,就已经赚回了十倍。要拿预防的成本去和一次错误决策的成本比,而不是和零比。
数据质量差怎样侵蚀信任?
信任是最晚出现、也最难恢复的成本。模式很一致:
- 一个数字有一次被证明是错的,通常是在会议上。
- 人们在接受任何数字之前先要求看来源。
- 团队“为了保险”建自己的表格,于是每个指标都有了两三个版本。
- 决策回到意见上,因为数据不再被当作依据。
不用问卷也能衡量信任。数一数有多少个指标同时流通着不止一个数字,会议里多常花时间在“谁的数字对”上,有多少个看板没人打开。如果只要一个早期预警,就找那份“第二张表格”:它说明第一个来源已经失去了信任。
怎样给你自己的数据质量问题估一个数?
用一个下午做一次小型审计:
- 列出你的决策最依赖的五个指标(转化率、单笔订单成本、收入、活跃用户、客服量)。
- 给每个指标写下它支撑的决策, 以及这个决策每月值多少钱。
- 检查输入里三种常见的毛病: 混入了非真人流量、事件重复记录或漏记、来源标签缺失。
- 估算每一项的误差占比, 就像上面三个问题那样(18%、6%、25%)。
- 相乘: 决策调动的金额 × 它本来会带回的收入 × 误差改变决策的可能性。对付费砍预算这件事,误差确实翻转了决策,所以风险敞口是 3,600 美元的削减 × 2.67 = 每月 9,600 美元的收入。
- 加上返工小时数, 用上面的公式。
单位保持为每月多少钱。这样经理可以拿它和修复的成本比较。相关的技术是数据清洗;这里的目的只是估出问题有多大。
轻量的数据治理是什么样?
预防这三个问题,不需要一个专门的项目。四个习惯就够:
- 给每个关键指标指定负责人, 由他回答“为什么变了”。
- 写下你打算收集什么, 带上必填属性清单,这样可以把实际到达的和你打算发送的做对照。
- 在入口检查数据。 每天或每周数事件和缺失字段,而不是在季度复盘时才发现缺口。数据可观测性讲的就是这个思路。
- 过滤非真人流量, 并单独报告,让它没法抬高分母。
哪些错误会让坏数据的代价更大?
- 等一个大错误。 悄悄存在的 6% 误差会花钱好几个月,因为没人触发调查。
- 改看板,不改源头。 手工调整会掩盖问题,下一个人又会重复。
- 向老板引用行业数字。 概括性的数字打动不了人;你自己的 9,600 美元可以。
- 只算直接成本。 返工和信任流失不会出现在某个科目里。
- 以为小误差无害。 6% 的重复是均匀的,没有改变任何排名,但 25% 的标签丢失翻转了一个决策。
- 没有负责人。 如果谁都能修,就没人去修。
怎样在 TapCub 里发现这些问题?
下面说明上面这家店怎样用 TapCub 找出三个问题。TapCub 显示数据在哪里丢失、标出缺口;它不会在源头修复数据,也不会替你删除重复的事件。
- 把机器人挡在分母之外。 新项目默认单独统计识别出的机器人,它们只出现在网站统计 › 机器人,不会抬高访客数或转化率。同一页把 AI 与智能体、全部机器人和访问记录分开,你可以看到占比有多大。
- 把实际到达的和计划的对照。 在全端分析 › 数据管理 › 埋点方案里记录你打算收集的事件和必填属性。打开实时验证(近 24 h),能看到每个事件 24 小时内的到达数和必填属性的完整度;完整度低是警告,不会拦截。购买事件的到达数远高于订单数,就是问题 2 的信号。
- 看数据在哪里丢了。 全端分析 › 数据管理 › 数据质量按原因列出摄取警告和采集端拒收,例如域名不符、排除规则、配额、限流、无效载荷和机器人。TapCub 的文档描述了它要对付的故障:采集坏了,报表会缩小,而图上没有任何报错。
- 尽早收到通知。 全端分析 › 智能运营 › 监控里的监控可以盯 pv、sessions、错误率或一个保存的自定义指标,并通知你。试运行会告诉你过去 30 天它会触发几次。它只通知,不会改动任何东西。
- 检查来源标签。 网站统计 › 来源按渠道和 UTM 显示直接访问;直接访问突然上升、付费同步下降,就是问题 3 的模式。修复链接要你自己来。
FAQ
数据质量差有什么影响?
它落在三个地方:决策(错数字导致错选择)、成本(人们花时间查找和修正错误)和信任(人们不再相信数据)。示例网店里,缺失的标签让付费广告的单笔订单成本看起来高了 33%,差点触发一次相当于每月 9,600 美元收入的预算削减。
数据质量差怎样影响决策?
错误的数字和正确的数字看起来一样,所以人们会放心地基于坏的输入做决策。即使是小误差,在阈值附近也有影响:记录的 ROAS 2.0 没达到 2.5 的规则,而真实的 2.67 达标了。先检查支撑你最大决策的那些指标。
数据质量差要花多少钱?
行业数字很大:IBM 对 2016 年美国的估算是 3.1 万亿美元,Gartner 2020 年研究给出每个组织每年平均 1,290 万美元。只当作量级。你自己的成本是返工小时数加上错误决策的价值;一位分析师核对两个来源,就可能是每年 15,600 美元。
怎样衡量坏数据的成本?
列出你的决策所依赖的指标,写下每个决策每月值多少钱,检查机器人、重复和缺失标签来估算误差占比,然后相乘。再加上返工小时数 × 每小时成本。结果用每月多少钱表示,便于和修复的成本比较。
怎样预防数据质量差?
给每个关键指标指定负责人,写下你打算收集什么,数据到达时就检查,并把非真人流量挡在分母之外。定期数事件和缺失字段,让缺口在几天内被发现,而不是等到季度复盘。
资料来源
- Thomas C. Redman。Bad Data Costs the U.S. $3 Trillion Per Year。《哈佛商业评论》,2016 年 9 月 22 日:IBM 的估算和隐藏的数据工厂。通过搜索结果取得,2026-11-19。
- Gartner。Data Quality: Best Practices for Accurate Insights:2020 年研究得出的每年平均 1,290 万美元成本,见 Gartner 主题页。通过搜索结果取得,2026-11-19。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
