直接用原始统计数据做的报表,会继承它所有的问题:机器人、测试订单、重复事件、内部访问和不统一的标签。本文列出网站和产品数据的八种清洗方法,用一个月的订单完整走一遍,并说明怎么从源头解决。
读完你会知道
- 先去掉机器人、测试数据和内部流量,再按不重复的 ID 去重
- 对比任何数字之前,先统一标签和时区
- 保留原始数据,写下每条清洗规则,能从源头修的就从源头修
为什么统计数据需要清洗
统计数据是从浏览器、应用和服务器自动收集的。这让它又多又快,但也很乱:机器人会来访,员工会测试结账,支付页刷新一下就把购买发了两次,一个广告系列标成「LinkedIn」、另一个标成「linkedin」。每个问题都不大,加在一起能让转化率差好几个百分点。
清洗就是在出报表之前,找出这些记录,删除、修正或打上标记。
八种方法
下表列出适用于网站和产品数据的八种方法,以及各自解决的问题。
| 方法 | 解决的问题 | 例子 |
|---|---|---|
| 过滤机器人 | 爬虫被算成访客 | 排除已知和疑似机器人 |
| 排除内部和测试流量 | 员工和 QA 抬高了计数 | 排除办公室地址、测试域名、测试账号 |
| 按 ID 去重 | 事件发了两次 | 每个订单号只保留第一条 |
| 统一标签 | 同一个值写法不同 | 「LinkedIn」「linkedin」→ linkedin |
| 统一时区 | 不同系统切分日期的方式不同 | 统一按项目时区出报表 |
| 处理缺失值 | 属性为空 | 标为未知;只在确定时填 |
| 校验类型和范围 | 数字字段里有文字、价格为负 | 拒收或隔离不合法的值 |
| 检查异常值 | 极端值扭曲平均数 | 排除 90,000 美元的订单之前先核实 |
大致按这个顺序做,从去掉垃圾到判断异常值。
完整例子:一个月的订单
一家网店把统计里的购买事件和订单数据库对比(示例数字):
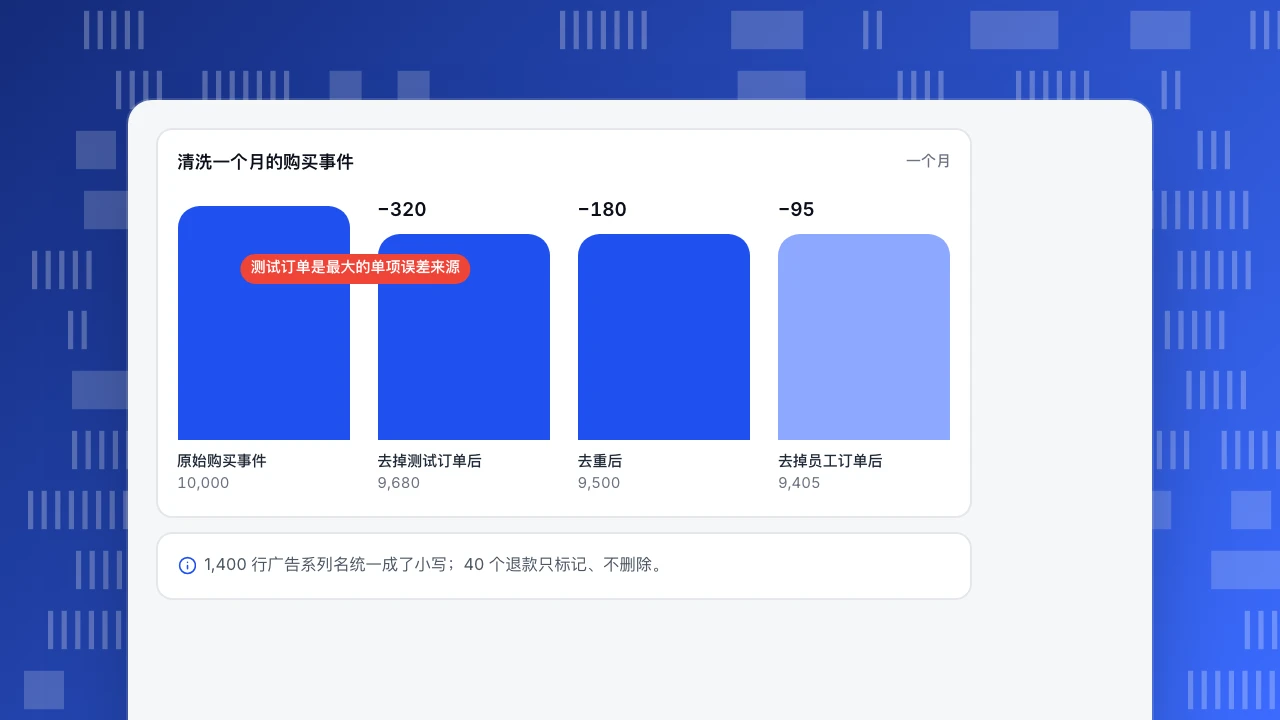
- 统计里这个月有 10,000 个购买事件
- 320 个测试订单,来自测试环境的结账和 QA 账号 → 删除
- 180 个重复:确认页刷新时触发了两次 → 按订单号删除
- 95 个员工内部下的单 → 按账号标记删除
- 1,400 行广告系列名大小写混用(「Spring_Sale」「spring_sale」)→ 统一成小写,不删除
- 40 个退款订单 → 保留,加上退款属性,供收入报表使用
结果:9,405 个干净的订单,和数据库的差距在 0.3% 以内。清洗之前,统计里的订单多了约 6%,「spring_sale」这个活动还被拆成了两个更小的活动。
清洗一个月的购买事件
一个月原始购买事件
10,000
去掉测试订单后
9,680
去重后
9,500
去掉员工订单后
9,405
1,400 行广告系列名统一成了小写;40 个退款只标记、不删除。
示例数据按什么顺序做
- 先去掉本来就不该算的:机器人、测试数据、内部流量。
- 按不重复的 ID 去重。
- 统一标签:大小写、拼写、渠道名。
- 修正时区和日期。
- 处理缺失值:只有在确定时才填,否则标为「未知」。
- 最后再看异常值,等明显的错误都去掉之后;拿不准一个值是不是真的,问数据负责人。
保留原始数据;清洗到一个新的视图或报表里,并把每条规则写下来。
从源头防止脏数据
用 TapCub 在入库时清洗
- 机器人:已知的机器人和 AI 爬虫默认不计入真人数据,见 网站统计 › 机器人。
- 内部流量和测试路径:网站统计 › 配置 › 网站设置 里的排除规则可按地址、路径、主机名或浏览器标识匹配;「排除我自己」会记下你当前的地址。应用的测试机在应用设置里按设备规则排除。
- 服务端的重复:服务端事件带
insert_id(最多 36 个字符);同一个 ID 来两次,以第一条为准。 - 发现问题:全端分析 › 数据管理 › 数据质量 按原因显示被采集端拒收的数据、入库告警、高基数属性,以及突然不再触发的埋点规则。
- 不改代码修标签:全端分析 › 数据管理 › 虚拟事件 / 属性 里的虚拟属性可以把乱的取值映射成干净的取值。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。