数据分类体系决定你追踪什么、每样东西叫什么,让「注册数」在每张报表里都是同一个意思。本文讲清四个层级,给出带例子的命名规则,用一次对四年老事件清单的整理走一遍,并说明怎么防止它再变乱。
读完你会知道
- 事件按「对象 + 过去式动作」命名,统一大小写风格,名字里不放取值
- 差异放进取值受控的属性里,而不是新建事件名
- 先写方案再写代码,上线后检查,每季度复查一次清单
什么是数据分类体系
在统计分析里,数据分类体系是对你追踪内容的统一结构和命名:有哪些事件、叫什么、带哪些属性、属性可以取哪些值。
没有它,同一个动作会在三年里被三个团队分别记成「Signup」「sign_up」和「user_registered」,每张报表都得加脚注。
四个层级
下表列出统计分类体系的四个层级和例子。
| 层级 | 定义什么 | 例子 |
|---|---|---|
| 分类 | 按领域分组事件 | account、billing、reports |
| 事件 | 一个完成的动作,对象 + 动作 | account_created、report_shared |
| 属性 | 附在事件上的上下文,名字统一 | plan、method、report_type |
| 取值 | 每个属性允许的取值 | method:email、google、github |
每个层级都写进埋点方案,带上负责人和示例。
命名规则
规则定一次,写下来,处处照用:
- 对象 + 动作,用过去式:
account_created、report_shared、order_completed。对象放前面,列表里相关事件会排在一起。 - 统一一种大小写风格:事件和属性常用 snake_case。绝不混用。
- 名字里不放取值:不要
clicked_pricing_button_blue,而是button_clicked加上button: pricing和variant: blue。 - 同一个属性,处处同名:每个事件上都叫
plan,而不是plan、plan_name、tier混着用。 - 报表要用的属性,取值要受控:
method只能是email、google、github,全小写。 - 能追踪结果就别追踪点击:服务端确认之后记
account_created,而不是signup_button_clicked。
一次完整的整理
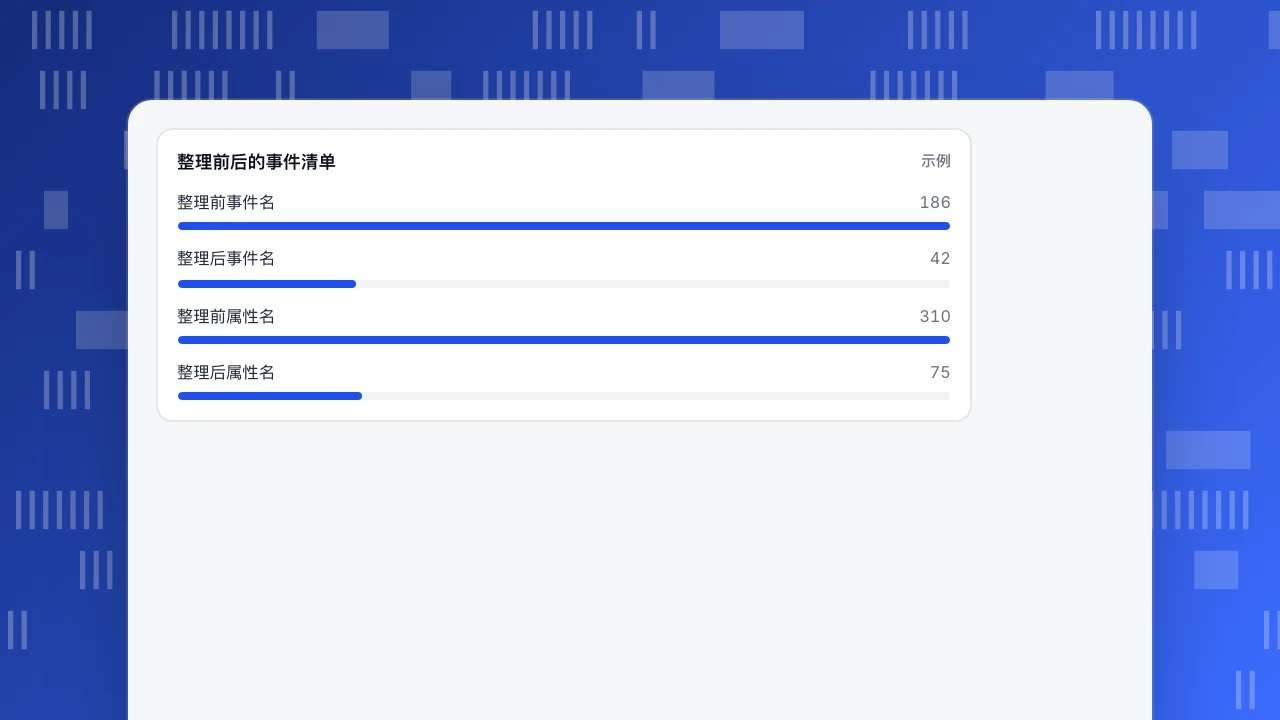
一个发展了四年的产品,有 186 个不同的事件名(以下都是示例数字)。检查发现:
- 创建账号有九个名字:
Signup、sign_up、signUp、user_signed_up、register、Register Click、signup_google、signup_email、account_create。 - 38 个事件 90 天内没有触发过。
- 310 个属性名,大量重复(
plan、planName、plan_tier)。
整理之后:
- 186 → 42 个事件。九个注册变体合成一个事件
account_created,带method: email | google | github。 - 38 个不用的事件先标为已废弃,再从代码里删掉。
- 310 → 75 个属性名,每个都有类型、说明和示例。
- 旧名字映射到新名字,供历史报表使用,趋势不会断。
现在注册数和数据库的差距在 1% 以内;整理之前,看你选哪个事件,要么少 40%,要么多 15%。
整理前后的事件清单
示例保持整洁
- 一个负责人审批新事件和新属性。
- 先写方案再写代码:每个新事件在开发之前写进埋点方案,带上必填属性。
- 上线后检查:头 24 小时的触发次数和必填属性的完整度。
- 每季度复查:弃用不再使用的事件,合并新出现的重复。
在 TapCub 里存放和检查
- 全端分析 › 数据管理 › 埋点方案 存放计划中的事件:显示名、分类、平台、属性(类型、是否必填、示例)、负责人和状态(待评审、开发中、验收中、已上线、已废弃)。实时校验显示 24 小时内的触发次数和必填属性完整度。方案可以从 CSV 导入,也可以导出 XLSX。
- 全端分析 › 数据管理 › 事件收件箱 的「事件定义」页签存放事件定义,还有等待认领的新事件。
- 全端分析 › 数据管理 › 属性字典 记录属性说明。
- 全端分析 › 数据管理 › 虚拟事件 / 属性 可以把已有的事件(比如几个旧的注册事件名)合成一个虚拟事件,不用改代码。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。