防止网页抓取,先衡量谁在抓取你的页面、抓了什么、是否重要。把能识别的机器人分开统计,用多层手段(限流、验证、挑战、登录)拦住值得拦的,其余的接受。一刀切的封禁,往往先误伤搜索引擎和共用网络,然后才轮到抓取程序。
读完你会知道
- 多个信号结合:示例里地址段 A 的请求量是中位数的 136 倍,96.2% 的请求是不同 URL,而且不加载任何资源
- 既按地址段计数,也按单个地址计数:61,200 个请求分摊到 254 个地址上,每个约 241 个,低于 300 的限额
- robots.txt 是请求,不是访问控制;对自称 Googlebot 的访客,放行或屏蔽之前先用反向 DNS 验证
谁在访问,你对他们有什么期待?
想防止网页抓取之前,先决定你想赶走哪些自动化访客。一刀切的封禁,把每个机器人都当成敌人,而其中有几类正是你想要的访客。先把它们分类:
| 访客类型 | 例子 | 它想要什么 | 你的默认做法 |
|---|---|---|---|
| 搜索引擎爬虫 | Googlebot、Bingbot | 收录你的页面,让人能搜到 | 允许,并且在相信它的自称之前先验证 |
| AI 爬虫 | GPTBot、ClaudeBot、PerplexityBot | 训练数据或回答素材 | 属于策略决定:通过 robots.txt 允许、限制或屏蔽 |
| SEO 工具爬虫 | AhrefsBot、SemrushBot | 为它们的客户做审计和外链数据 | 允许或限制;它们通常会表明身份并遵守 robots.txt |
| 内容或价格抓取程序 | 没有名字的脚本,常带浏览器 User-Agent | 你的商品目录、价格或文字,被复制到别处 | 提高它的成本;如果数据价值不高,就接受 |
| 恶意自动化 | 撞库、抢购囤货 | 账号、库存、访问权限 | 需要单独的机器人管理方案;本文只讲读取和复制 |
这张表就是本文先问问题、不先讲工具的原因。「防止网页抓取」对每一行的意思都不同。前三类可以用规则文件加一步验证来管理,第四、第五类才需要多层手段。相关定义见机器人、网络爬虫和 AI 爬虫。
本文的核心观点是:没有衡量过的东西,你保护不了。先弄清谁在抓取、抓了什么、是否重要。数据里能区分的先分开,值得拦的用多层手段拦,其余的接受。不基于衡量的封禁,往往先误伤搜索引擎、守规矩的爬虫和共用网络的办公室,然后才轮到抓取程序。
怎样分辨抓取和正常流量
没有哪个信号单独可靠。每一个都可能被伪造,也可能误伤无辜访客。要两个以上一起用:
| 信号 | 表现 | 可靠程度 | 误判风险 |
|---|---|---|---|
| 系统性遍历 URL | 几乎每个请求都是不同的 URL,按顺序,没有回访 | 强;OWASP 把抓取描述为系统性地读取所有可访问的路径和参数值 | 对真人很低;正规爬虫也会这样 |
| 每个 IP 段的请求量 | 某个地址段远高于同类地址段的中位数 | 和其他信号结合时强 | 共用 IP(办公室、移动网络)上很高 |
| 不加载资源文件 | 请求了 HTML,却没有 CSS、脚本或图片 | 中等;很多简单抓取程序会跳过资源 | 低;但无头浏览器会加载它们 |
| User-Agent 字符串 | 写明某个工具、库或机器人 | 弱;它是客户端自己选的请求头 | 抓取程序可以自称浏览器或 Googlebot |
| 自称的爬虫没通过验证 | 自称 Googlebot,但反向 DNS 的结果不是以 googlebot.com 结尾 | 强;Google 文档记载了这项检查 | 很低 |
| robots.txt 的行为 | 从不读取 robots.txt,或抓了你禁止的页面 | 中等;能把守规矩的爬虫和其他分开 | 低 |
| 命中蜜罐 | 请求了一个没有任何真人链接指向的 URL | 强 | 低,前提是链接对真人不可见,并且在 robots.txt 里禁止 |
关于验证那一行,Google 的文档说,要对请求来源 IP 做反向 DNS 查询,确认主机名以 googlebot.com 结尾,再做一次正向查询,确认它解析回同一个 IP。之所以需要这样,是因为别人可以自称是 Google 的爬虫,所以光看 User-Agent 字符串什么也证明不了。对其他搜索引擎,用各自公布的验证方法。
算例:一天的请求
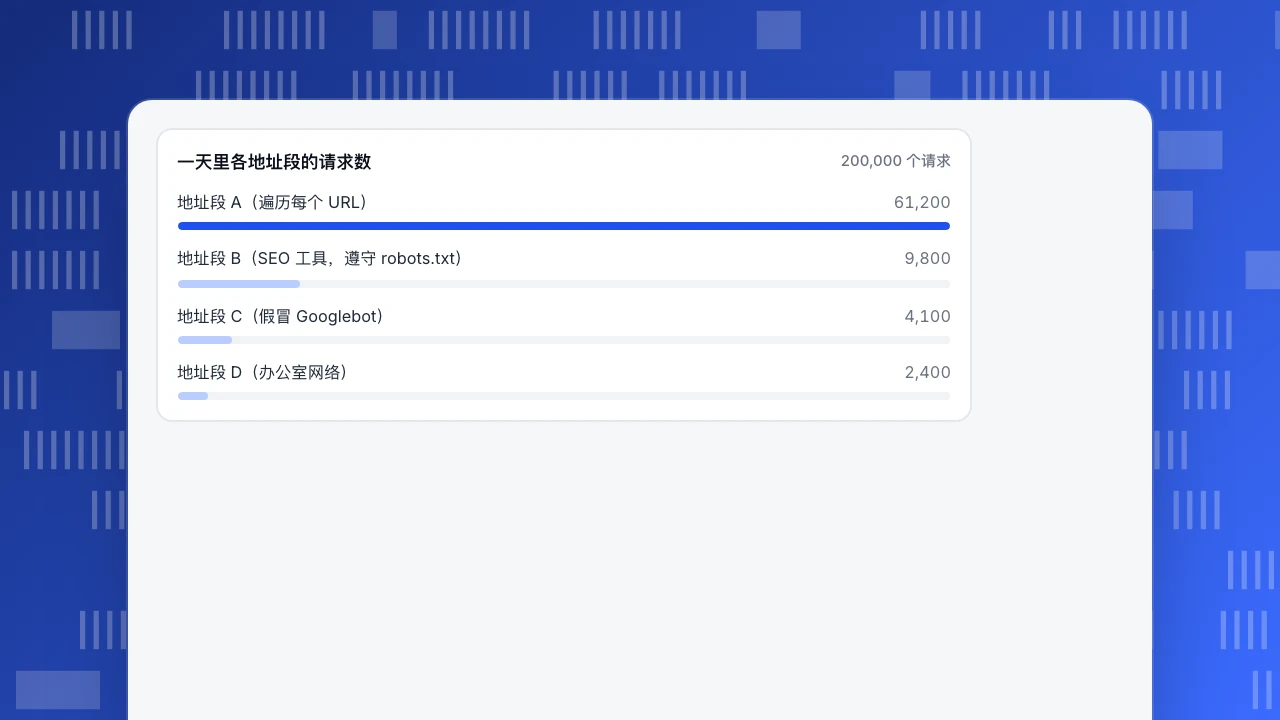
示例数据:某站一天收到 200,000 个请求。「像真人」的 /24 地址段(一个有 254 个可用地址的段)的请求数中位数是 450。有四个地址段很扎眼,地址是占位用的。
| 地址段 | 请求数 | 不同 URL 数 | 每个页面的资源数 | 自称 | robots.txt | 是中位数的几倍 |
|---|---|---|---|---|---|---|
| A | 61,200 | 58,900 | 0 | 普通浏览器 | 从未读取 | 136 |
| B | 9,800 | 9,700 | 0 | AcmeSEOBot/2.0 | 读取并遵守 | 21.8 |
| C | 4,100 | 3,900 | 0 | Googlebot/2.1 | 从未读取 | 9.1 |
| D | 2,400 | 700 | 2.7 | 普通浏览器 | 不适用 | 5.3 |
套用一条两部分的简单规则:某个地址段的请求数至少是中位数的 20 倍,且每个页面加载的资源少于 0.1 个,就标记它。
- 地址段 A 被标记。61,200 ÷ 450 = 中位数的 136 倍;58,900 ÷ 61,200 = 96.2% 的请求是不同的 URL,说明它在遍历网站而不是浏览;而且它不加载资源。它还产生了 61,200 ÷ 200,000 = 30.6% 的请求,却没有产生真实会话。按单个地址限流会漏掉它:分摊到 254 个地址上,每个约 61,200 ÷ 254 = 241 个请求,低于比如每天 300 个的限额。按地址段计数,能抓住按地址计数漏掉的。
- 地址段 B 因请求量被标记(9,800 ÷ 450 = 21.8),但它写明了自己的身份,读取并遵守 robots.txt。这是针对一个 SEO 工具的策略决定,不是攻击:允许它、在 robots.txt 里让它放慢,或者按名字屏蔽它。
- 地址段 C 没有因请求量被标记(9.1 倍),但它自称 Googlebot,反向 DNS 检查没通过。伪造的爬虫就是伪装的抓取程序,所以要屏蔽。规则里需要对「自称是爬虫的」再加一道检查。
- 地址段 D 没有被标记。它有 2,400 个请求,只是中位数的 5.3 倍,并且为 700 个页面加载了 1,900 个资源,1,900 ÷ 700 = 每个页面 2.7 个,像浏览器那样。它看起来是许多人共用一个地址的办公室网络。按地址限制它,会把这些人都锁在门外。
这些数字只是演示,方法才是重点:把请求量和至少一个行为信号结合,既按地址段又按单个地址计数,并对自称是搜索引擎的另做一项检查。
一天里各地址段的请求数
200,000 个请求防御的各个层次,以及各自的代价
没有哪一层能单独挡住决心很大的抓取者。从便宜到昂贵逐层叠加,并权衡每一层的副作用,见下表:
做限流时,返回 429 状态。RFC 6585 把它定义为「请求过多」(Too Many Requests),并说响应里可以带 Retry-After 头,告诉客户端要等多久。守规矩的客户端看到它会放慢,而你能在日志里看出哪些没有。
| 层次 | 它做什么 | 能挡住什么 | 要权衡的副作用 |
|---|---|---|---|
| robots.txt | 告诉爬虫哪些要跳过 | 只对守规矩的爬虫有效 | 对其余的毫无作用;还会把你列出的路径公开 |
| 限流 | 减慢或拒绝请求太多的客户端 | 快速、简单的抓取程序 | 共用 IP 会被一起限流;慢速抓取程序会在限额之下 |
| 验证自称的爬虫 | 确认「Googlebot」确实是 Googlebot | 伪造的搜索引擎名字 | 需要你维护一个查询步骤 |
| 挑战和 JavaScript 检查 | 要求客户端证明自己是浏览器 | 没有浏览器引擎的脚本 | 给真人增加摩擦;无障碍问题;无头浏览器能通过 |
| 登录或 API | 把数据放在账号后面,或以数据源方式提供 | 大规模的匿名复制 | 随便看看的访客会少;API 自己也要有限额 |
| 机器人管理服务或 WAF | 用多种信号给每个请求打分 | 大量自动化流量 | 成本;要调优的误判;请求路径里多了一个供应商 |
| 蜜罐链接 | 只有机器人才会点的隐藏 URL | 会跟随每个链接的爬虫 | 必须在 robots.txt 里禁止,好爬虫才会跳过 |
各层从便宜到昂贵排列;没有哪一层能单独挡住决心很大的抓取者。限流应返回 RFC 6585 定义的 429。
robots.txt 能做什么,不能做什么
robots.txt 是成本最低的一层,也是被误解最多的一层。它的标准 RFC 9309 把这些规则描述为请求爬虫遵守的约定,并明确说它们不是访问授权的一种形式。它还补充说,robots.txt 不能替代真正的内容安全措施,并且把路径写进去,就等于让这个路径可被公开发现。如果一个 URL 不该被看到,就把它放在身份验证后面,而不是放在一条禁止规则后面。
robots.txt 擅长的是:给守规矩的爬虫(包括搜索引擎和许多 SEO、AI 爬虫)一个清晰的指令,也给你留下证据。一个抓取了被禁止路径的爬虫,是无视了你公布的指令,这就是屏蔽它的依据。规则的写法示例见 robots.txt 全部禁止,页面级指令见 X-Robots-Tag。人们常问的两个爬虫,见 GPTBot 和 ClaudeBot。
它做不到的是:拦住从不读它的抓取程序。值得担心的抓取程序,大多数都不读。
别屏蔽错了对象
过于宽泛的封禁,代价很高,又很容易被忽视,因为被封的访客不会抱怨,他们只是不出现了。四项检查能降低伤害:
- 绝不只按 User-Agent 屏蔽。 抓取程序改一下请求头就行,而真正的爬虫或工具却一直被屏蔽。
- 先放行经过验证的搜索引擎。 如果你挑战或屏蔽 Googlebot,你的页面就会从搜索里消失。添加任何规则前,先按上面的方法用反向 DNS 验证。
- 谨慎对待共用 IP。 办公室、大学和移动网络会让许多人共用一个地址。用挑战代替封禁,并且让挑战过期。
- 加了挑战之后,用真实浏览器和读屏软件测试。 确认结算、登录和人们真正在用的表单仍然能用。
如果某条规则屏蔽了不该屏蔽的,你要在客户告诉你之前,就从自己的数据里发现。每加一条新规则,都留意真人流量和转化有没有下降。
到底值不值得拦?
封禁要花工程时间,给访客增加摩擦,还会引发攻防升级。让投入和风险相称:
| 如果…… | 那么…… |
|---|---|
| 数据是公开的、价值不高、提供成本低 | 接受它;监控请求量,只有负载成问题时才限流 |
| 抓取程序占了很大比例的请求却没有会话(地址段 A:30.6%) | 按地址段限流、加挑战,并考虑给读取量大的对象提供登录或数据源 |
| 数据本身就是产品,比如价格、房源或评价 | 多层防御,把最有价值的页面放到账号后面,并留意轮换 IP |
| 某个有名字的爬虫无视你的 robots.txt | 按名字、在服务器层屏蔽它,并保留证据 |
| 你不确定复制是否合法,或是否违反你的条款 | 行动前先问律师;本文不是法律意见 |
抓取是否合法,取决于国家、数据、你公布的条款,以及抓取者拿数据做什么。那是法律问题,不是技术问题。
常见误区
- 把 robots.txt 当成锁。 它是对守规矩爬虫的请求,标准明确说它不是访问控制。
- 按 User-Agent 屏蔽。 抓取程序一行代码就能改掉。真正的爬虫被屏蔽了,抓取程序却没有。
- 只按 IP 地址限流。 在一个地址段内轮换地址的抓取程序,比如每个地址 241 个请求的地址段 A,会一直在限额之下。
- 挑战搜索引擎。 展示给 Googlebot 的挑战,就是一个不会被收录的页面。
- 把机器人算作访客。 混进访客数的已识别机器人,会扭曲转化率,让冷清的一周看起来很热闹。做决定用的数字里要把它们排除。
- 事后不衡量。 如果从不比较加规则前后的请求量和真人流量,你就不知道它有没有用,也不知道它搞坏了什么。
在 TapCub 里发现机器人和抓取流量
以上面那一天的请求为例,看看 TapCub 能告诉你什么、不能告诉你什么。TapCub 负责识别和统计机器人流量,不做任何拦截:把某个爬虫加入排除规则,只是让 TapCub 不再统计它。
- 打开机器人报表。 在 网站统计 › 机器人 里,全部机器人 页签列出每个识别出的机器人:运营方、用途、请求数、访问页数、最常见状态码、最后出现时间、可信度、命中了哪几层检测和来源渠道。按请求数排序,找出读取量大的。识别出的机器人只进这张报表,默认不计入真人的访客、会话和浏览量。
- 看谁渲染了页面。 访问记录 页签覆盖执行了统计脚本的机器人,同一来源 30 分钟内的请求算一次访问。AI 与智能体 页签在 AI 内容账本里显示各 AI 运营方的读取次数。检测的各层如何组合,见机器人检测帮助页;怎么读那个比值,见 AI 内容账本。
- 仔细读可信度这一列。 可信度分为已验证、可疑或未知,未知本身不代表伪造。只有 Applebot 做 DNS 反向查询验证,其余机器人都显示为未验证。所以在示例里,TapCub 不会告诉你地址段 C 没通过 Googlebot 验证,这项查询要你自己做。
- 检查 robots.txt 遵守情况。 监测 › 爬虫合规 会读取你的规则文件,并和真实抓取对比。它报告三类违规:在全局被禁止时仍然抓取、抓取了被禁止的路径、抓取速度快于声明的延迟。它能起草屏蔽训练爬虫或答案引擎的规则,以及一段可放到服务器上的屏蔽片段。文件本身拦不住抓取,这个页面是证据。
- 报告错误的标签。 如果你确定是真人的访客被标成了机器人,可以报告误判,由平台管理员复核(报告误判)。
要知道它的局限。只有页面脚本时,你能看到的是执行了 JavaScript 的机器人。一个带普通浏览器 User-Agent、又不运行脚本的抓取程序,根本不会出现,而状态码和响应时间需要服务端采集或日志导入。要发现地址段 A 这样的对象,需要在你的服务器或 CDN 日志里,按地址段分析请求速率。用 TapCub 看有名字的、能检测到的机器人,并把它们排除在真人数字之外;限流、挑战或屏蔽,交给你的服务器或 CDN。
常见问题
怎样防止网页抓取?
按成本由低到高分层:对守规矩的爬虫用 robots.txt,用 429 响应限流,验证自称的搜索引擎,对可疑客户端加挑战,对有价值的数据用登录或 API。没有哪一层能单独挡住决心很大的抓取者。先衡量,才知道你在屏蔽谁。
robots.txt 能防止网页抓取吗?
只对愿意遵守它的爬虫有效。RFC 9309 说 robots.txt 不是访问授权的一种形式,把路径写进去还会让路径公开。它对守规矩的爬虫有用,也能作为谁无视你的规则的证据。对敏感数据,请用身份验证。
怎么知道我的网站有没有被抓取?
找这样的客户端:几乎每个 URL 只请求一次,来自同一个 IP 段,不加载 CSS 或图片,请求量远高于中位数。再检查自称的搜索引擎是否通过反向 DNS 验证,以及有没有谁读取 robots.txt 或点了隐藏的蜜罐 URL。
怎样屏蔽抓取程序又不屏蔽 Google?
先验证,再放行或屏蔽。对请求来源 IP 做反向 DNS 查询,确认主机名以 googlebot.com 结尾,再确认该主机名解析回同一个 IP,或者核对 Google 公布的 IP 段。千万别只靠 User-Agent,因为谁都能发送它。
网页抓取违法吗?
没有统一的答案。这取决于国家、数据的类型、网站的条款,以及抓取者拿数据做什么。本文不提供法律意见;针对具体的抓取事件采取行动或应诉之前,请先咨询律师。
资料来源
- IETF,RFC 9309: Robots Exclusion Protocol(robots.txt 不是访问授权;写进去的路径是公开的)。核对于 2026-11-17。
- IETF,RFC 6585: Additional HTTP Status Codes(429 请求过多与 Retry-After)。核对于 2026-11-17。
- Google Search Central,Verifying Googlebot and other Google crawlers。核对于 2026-11-17。
- OWASP,OAT-011 Scraping,Automated Threats to Web Applications。核对于 2026-11-17。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
