一个 JavaScript 网站在浏览器里看起来完美,在爬虫眼里却可能是空的。本文讲 Google 处理 JS 的三个阶段、为什么大多数 AI 爬虫根本不运行你的脚本、渲染方式怎么选、导致大部分问题的那几类错误,以及一次改用服务端渲染后收录率从 53% 提到 94% 的审计。
读完你会知道
- Google 先抓取,再排队渲染,最后收录 JS 页面
- 大多数 AI 爬虫完全不执行 JavaScript
- 标题、canonical、链接和主要内容在服务端输出
- 用真正的 <a href> 链接和 History API 路由,不用片段
- 对比原始 HTML 和渲染后 DOM 找出差距
什么是 JavaScript SEO?
JavaScript SEO 是技术 SEO 的一部分,目的是让搜索引擎(以及越来越多的 AI 爬虫)能抓取、渲染和收录那些内容、链接或元数据由 JavaScript 生成的页面。React、Vue、Angular、Svelte 这些框架能做出又快又像 App 的网站,但如果有用的内容要等脚本在浏览器里运行后才出现,那么不运行脚本、或者很晚才运行脚本的爬虫,看到的就是一个空壳。
Google 怎么处理 JavaScript 页面
Google 分三个阶段处理 JavaScript 页面:
- 抓取。 Googlebot 请求网址,读取最初返回的 HTML。这份 HTML 里的链接马上进入抓取队列。
- 渲染。 页面进入渲染队列,用无界面、持续更新的 Chromium 运行 JavaScript,得到渲染后的 DOM。Google 说延迟通常是几秒,但也可能更久。
- 收录。 用渲染后 HTML 里的内容、链接和元数据建立索引;渲染后才发现的新链接再回到抓取队列。
实际中有三点要注意:
- 如果最初的 HTML 里写着
noindex,Google 可能会跳过渲染,所以靠 JavaScript 去掉它是没用的。 - 渲染要消耗资源。 大量依赖客户端渲染的大网站,被发现和更新都会更慢,见抓取预算。
- 别的爬虫不一样。 Bing 能有限度地渲染 JavaScript。Vercel 对爬虫流量的分析显示,GPTBot、ClaudeBot 等大多数 AI 爬虫只取 HTML,不执行 JavaScript,只在客户端生成的内容它们看不到。
渲染方式对比
| 方式 | HTML 在哪里生成 | 对 SEO | 说明 |
|---|---|---|---|
| 客户端渲染(CSR) | 浏览器里 | 最弱:取决于爬虫会不会渲染 JS | 登录后的应用没问题,公开内容有风险 |
| 服务端渲染(SSR) | 每次请求时在服务器上 | 强:第一次响应就是完整 HTML | Next.js、Nuxt、SvelteKit、Remix |
| 静态生成(SSG) | 构建时 | 很强,也很快 | 很适合内容页和营销页 |
| 增量 / 混合 | 静态生成,按计划或按需刷新 | 强 | 适合商品很多的目录 |
| 动态渲染 | 只给爬虫返回预渲染的 HTML | 能用,但 Google 称之为权宜之计,不是长期方案 | 增加维护成本和内容不一致的风险 |
需要排名的公开页面,要在服务器上或构建时输出主要内容、标题、描述、canonical 和内部链接,再在上面挂交互。
| 方式 | 对 SEO | 适合 |
|---|---|---|
| 客户端渲染 | 最弱 | 登录后的应用 |
| 服务端渲染 | 强 | 动态的公开页面 |
| 静态生成 | 很强 | 内容和营销页 |
| 动态渲染 | 权宜之计 | 老系统,短期用 |
大多数 AI 爬虫只看得到第一次响应里的 HTML。
常见的 JavaScript SEO 问题
| 问题 | 为什么有害 | 怎么改 |
|---|---|---|
用 onclick 或 <div> 做链接,而不是 <a href> | 爬虫只跟真正的链接 | 导航用 <a href="/path"> |
路由放在网址片段里(/#/pricing) | 收录时会忽略片段 | 用 History API 和真实路径 |
每个路由都是同一个 <title> | 页面看起来全是重复的 | 在服务端按路由输出标题、描述和 canonical |
| 内容要用户操作后才加载 | 爬虫不会点击和滚动 | 关键内容不依赖交互就能渲染 |
| 错误路由返回 HTTP 200 | 软 404 浪费抓取预算 | 服务端返回真正的 404 状态码或 noindex |
| robots.txt 屏蔽了 JS 或接口文件 | Google 没法渲染 | 放行页面需要的资源 |
| 脚本包太大、接口太慢 | 渲染超时,LCP 很差 | 拆分代码、缓存接口、首屏内容服务端渲染 |
懒加载图片没有真实 src | 图片不被收录 | 用原生 loading="lazy" 并写真实 src |
计算示例:审计一个客户端渲染的商品目录
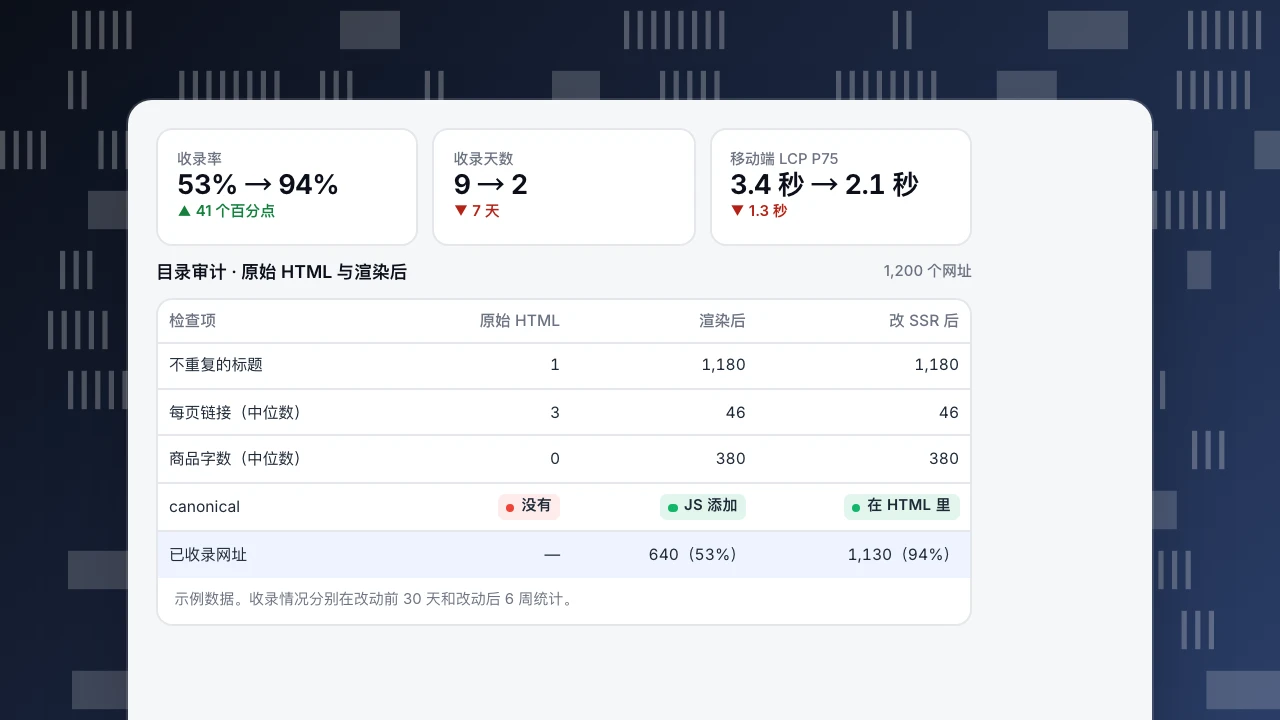
某商店是客户端渲染的 React 应用,站点地图里有 1,200 个商品和分类网址。我们对每个网址比较了原始 HTML 和渲染后的 DOM(示例数据):
| 检查项 | 原始 HTML | 渲染后 DOM |
|---|---|---|
不重复的 <title> | 1 个(每页都是「Shop」) | 1,180 个 |
| 每页内部链接(中位数) | 3 | 46 |
| 商品内容字数(中位数) | 0 | 380 |
| canonical 标签 | 没有 | 有(JS 加的) |
日志显示的情况。 30 天里 Googlebot 抓了全部 1,200 个 HTML 网址,但只收录了 640 个(53%)。AI 爬虫请求每个商品页,拿到的都是同一个空壳。
修复。 团队把商品和分类模板改成服务端渲染,第一次响应就输出标题、canonical 和内部链接,下架商品返回真正的 404。
六周后: 1,200 个网址收录了 1,130 个(94%),商品从发布到被收录的天数中位数从 9 天降到 2 天,AI 爬虫也开始拿到完整的商品文字。移动端 LCP 的 P75 从 3.4 秒降到 2.1 秒,因为内容不再等脚本包和接口。
收录率
53% → 94%
▲ 41 个百分点
收录天数
9 → 2
▼ 7 天
移动端 LCP P75
3.4 秒 → 2.1 秒
▼ 1.3 秒
目录审计 · 原始 HTML 与渲染后
1,200 个网址| 检查项 | 原始 HTML | 渲染后 | 改 SSR 后 |
|---|---|---|---|
| 不重复的标题 | 1 | 1,180 | 1,180 |
| 每页链接(中位数) | 3 | 46 | 46 |
| 商品字数(中位数) | 0 | 380 | 380 |
| canonical | 没有 | JS 添加 | 在 HTML 里 |
| 已收录网址 | — | 640(53%) | 1,130(94%) |
示例数据。收录情况分别在改动前 30 天和改动后 6 周统计。
怎么检查 JavaScript SEO
- 看原始 HTML(
curl或查看源代码),确认标题、描述、canonical、主要内容和链接都在。 - 用 Google Search Console 的网址检查 → 测试实际网址 → 查看测试的页面,看渲染后的 HTML 和被屏蔽的资源。
- 用能渲染 JavaScript 的抓取工具抓两遍:一次不渲染、一次渲染,对比标题、链接和字数。
- 看服务器日志里 Googlebot 和 AI 爬虫的请求:它们有没有抓页面、JS 和接口文件,拿到的是不是 200?见用日志文件做 SEO 分析。
- 关注收录报告里的「已抓取,尚未编入索引」和软 404。
在 TapCub 里看爬虫和性能
TapCub 的机器人识别把爬虫和真人访客分开,AI 爬虫账本显示哪些 AI 机器人请求了哪些页面。要看到那些根本不执行 JavaScript 的爬虫请求,可以导入服务器日志。改了渲染方式之后,按页面对比真实用户的 LCP 和 INP(P75),见查看核心网页指标。单页应用要按单页应用安装指南接入,路由切换才会计为页面浏览。
参考资料
- Google Search Central. Understand JavaScript SEO basics.
- Google Search Central. Dynamic rendering as a workaround.
- Vercel (2024). The rise of the AI crawler.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。