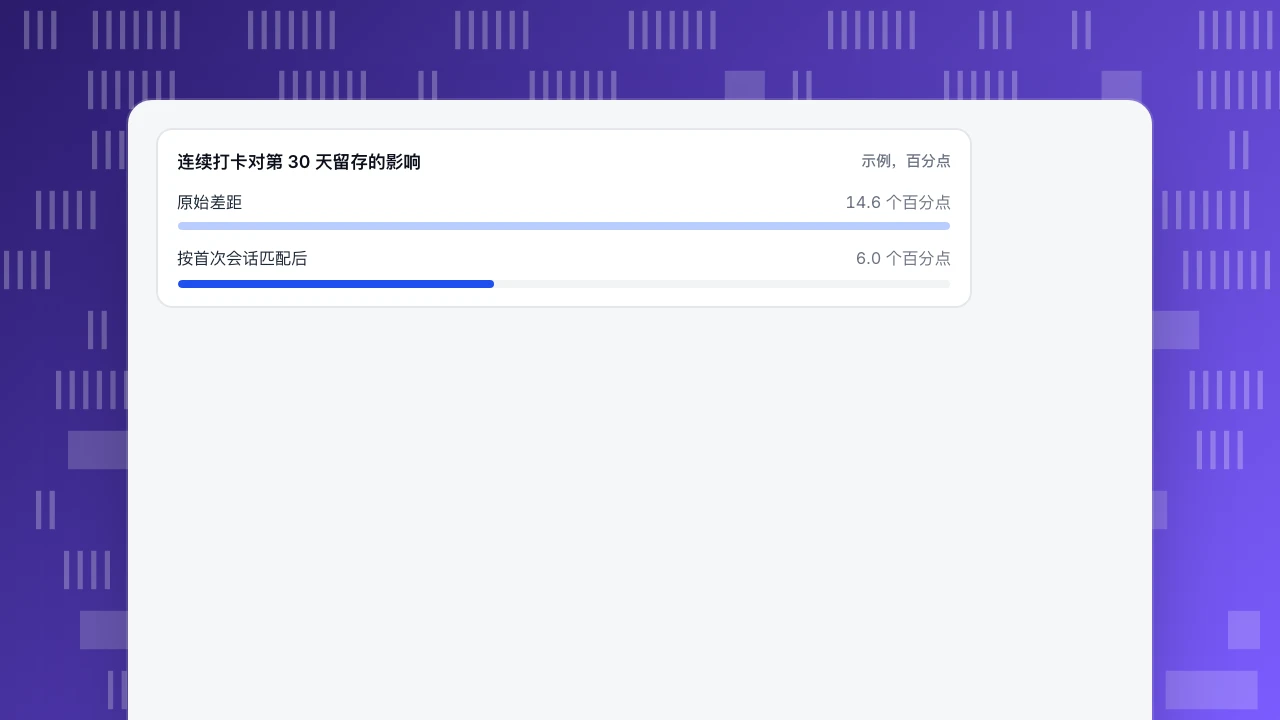
游戏化案例要看有没有改变核心行为,而不是看活跃用户数有没有上升。多数案例是五种机制之一:积分、徽章、连续打卡、排行榜或进度条。每一种都需要一个要改变的行为、一个指标、一个观察窗口和一个护栏指标。下面讲公开案例实际说明了什么,以及一个连续打卡算例,其中选择偏差占了表面提升的很大一部分。
读完你会知道
- 每种机制都绑定一个核心行为、一个窗口和一个失败判据;登录送积分让活跃用户涨了 18.0%,核心动作只涨了 0.8%
- 公开案例是公司的主张,不是实验;要数活跃的参与者,不数已加入的人
- 把参与者和开启前特征相似的非参与者比较:14.6 个百分点的原始差距变成了 6.0 个百分点
什么算游戏化,以及大多数案例背后的五种机制
游戏化是在非游戏场景中使用游戏设计元素,这是学术研究给出的定义,已成为通行的说法(Deterding 等)。在产品里,通常就是五种机制之一:积分、徽章、连续打卡、排行榜或进度条。多数游戏化案例,都是这五种之一用在某个产品动作上,对每一种真正有用的问题不是「看起来好不好玩」,而是「它要改变哪个行为,我怎么知道有没有改变」。
| 机制 | 要改变的行为 | 要读的指标 | 观察窗口 | 要盯的护栏指标 |
|---|---|---|---|---|
| 积分 | 重复使用或重复购买 | 每个活跃用户每周的核心动作数 | 8 周 | 已兑换积分的成本;规则被钻空子 |
| 徽章 | 完成上手里程碑 | 完成各里程碑的占比 | 2–4 周 | 完成的质量,不只是点击 |
| 连续打卡 | 连续几天回来 | 有 7 天连续记录的占比;30 天留存 | 30 天 | 关闭通知的比例、卸载 |
| 排行榜 | 好胜用户的投入 | 按名次段统计的每位参与者核心动作数 | 4–8 周 | 排名靠后用户的活跃度 |
| 进度条 | 完成多步任务 | 步骤和任务完成率 | 同一会话到 7 天 | 低价值步骤的完成情况 |
本文的论点是:游戏化有没有用,要看它是否改变了核心行为,而不是看活跃用户数有没有上升。一个机制如果提高了登录次数,却没有提高真正给用户带来价值的那个动作,它就只是装饰。所以上表每一行都把一种机制和一个行为、一个窗口绑在一起;如果你的产品填不满这一行,就说明还没准备好去做这个机制。
公开的案例实际说明了什么
许多「游戏化案例」清单描述的是品牌和机制。有几处来源可以让你核对到底说了什么:
| 案例 | 机制 | 来源怎么说 | 它没有说明什么 |
|---|---|---|---|
| Duolingo | 连续打卡和排行榜 | 其 2021 年 S-1 说,它把游戏化功能做进平台来激励学习者,这些功能促使学习者每天回来,并把排行榜和连续打卡列为让订阅更黏的功能(Duolingo S-1)。其博客说,连续打卡改版后的早期数据显示有更多人保持了连续记录(Duolingo 博客) | 留存有多少来自连续打卡本身,而不是来自愿意保持连续的那类人;改版没有给出具体数字 |
| Starbucks Rewards | 积分制会员 | 2024 财年第三季度,它报告美国有 3,380 万会员,按 90 天窗口计为活跃(Starbucks) | 没有这个计划,会员本来会买什么 |
| 研究综述 | 多种 | 对 24 项实证研究的综述发现,效果多为正面,但取决于场景和用户(Hamari 等) | 哪些机制适合你的产品 |
两点体会。其一,公司的说法是主张,不是实验:「促使用户回来」描述的是意图和相关,现有的数字是参与者的计数。其二,表中指标定义得最谨慎的是 Starbucks:会员按一个窗口内的「活跃」来数,不是按「已注册」,所以光靠注册数无法把这个数撑大。你自己的计划也用这个标准:数活跃的参与者,不数已加入的人。更广泛地提升 App 参与度的办法见提升 App 参与度,许多这类机制背后的行为模型是钩子模型。
给每种机制配一个行为、一个窗口和一个失败判据
动手之前,每种机制写一句话:「我们预期[机制]在[窗口]内把[核心行为]从[X]提高到[Y],如果[护栏指标]变差,就算失败。」核心行为是产生价值的那个动作,而不是「人在」:
| 产品 | 要衡量的核心行为 | 要避开的虚荣数字 |
|---|---|---|
| 笔记应用 | 每个活跃用户每周新建的笔记数 | 日活跃用户 |
| 语言学习应用 | 完成的课程数 | 打开 App 的次数 |
| 项目工具 | 创建并分享的项目或任务数 | 登录次数 |
| 网上商店 | 60 天内的复购订单 | 获得的积分 |
示例数据:一个项目工具增加了「登录送积分」。接下来一个月,日活跃用户从 10,000 涨到 11,800,+18.0%。每个活跃用户每周创建的项目从 1.20 变成 1.21,+0.8%,30 天留存从 22.0% 变成 22.4%,+0.4 个百分点。活跃数字看上去像是赢了,核心行为却没有变。这个机制奖励了错的东西。与此并排值得跟踪的参与度度量见参与度指标。
算例:连续打卡的参与者与非参与者
示例数据:一个月有 20,000 个新用户。连续打卡功能是可选的;6,000 人在第一周开启(「参与者」),14,000 人没有。核心指标是第 30 天留存。
直接比较
- 参与者第 30 天仍留存:6,000 人中 1,500 人,25.0%。
- 非参与者:14,000 人中 1,460 人,10.4%。
- 原始差距:25.0% − 10.4% = 14.6 个百分点,相对提升 25.0 ÷ 10.4 − 1 = 140%。
照字面理解,连续打卡功能多留住了 6,000 × 14.6% = 874 个用户。这好得不真实,因为愿意开启连续打卡的用户,本来就更倾向于回来。要估算其中有多少是选择偏差,办法是在开启「之前」就已知的某个维度上,拿相似的人互相比较。这里用的是首次会话时长,分为长(5 分钟或以上)和短。
| 首次会话 | 分组 | 用户数 | 第 30 天留存人数 | 留存率 |
|---|---|---|---|---|
| 长 | 参与者 | 2,400 | 960 | 40.0% |
| 长 | 非参与者 | 1,600 | 592 | 37.0% |
| 短 | 参与者 | 3,600 | 540 | 15.0% |
| 短 | 非参与者 | 12,400 | 868 | 7.0% |
匹配后的比较
- 首次会话长:40.0% − 37.0% = 3.0 个百分点。
- 首次会话短:15.0% − 7.0% = 8.0 个百分点。
- 按参与者实际所处的分布加权:(2,400 × 3.0% + 3,600 × 8.0%) ÷ 6,000 = (72 + 288) ÷ 6,000 = 6.0 个百分点。
校正后的效果是 6.0 个百分点,是原始 14.6 的 41%。多留住的用户:6,000 × 6.0% = 360 人,不是 874 人。原始差距里约 59%,也就是 514 人,是选择偏差。这个方法的思路来自观察性研究中的倾向得分匹配(Rosenbaum 和 Rubin)。要注意两点:只按开启「之前」就已知的东西分层(首次会话时长、渠道、平台),因为按之后才发生的东西来分,比如第一周的活跃度,会把你要衡量的效果混进去;另外未被测量的差异依然存在,所以 6.0 个百分点只是估计,很可能仍略偏高。通用概念见选择偏差。
不能分流量时怎么比较
随机留出组是说服力更高的设计,但需要功能开关或实验工具。没有的时候,选偏差最小的替代方案,并说明还残留什么偏差:
| 设计 | 做法 | 预期的偏差 | 怎么处理 |
|---|---|---|---|
| 前后对比 | 比较上线前 4 周和上线后 4 周 | 季节性、其他发版、新鲜感 | 对比相同的星期几;留 4 周的前置期;读第 30 天,不读第 3 天 |
| 分批上线 | 先在一个平台或一个国家上线,和其余的比 | 平台和国家的差异 | 与同一群人上线前的趋势比较 |
| 匹配比较 | 把参与者和开启前特征相似的非参与者比较 | 未测量的差异 | 在多个开启前的特征上分层;把结果当作上限 |
| 剂量反应 | 看参与得越多留存是否越高 | 最有动力的人参与最多 | 只作为辅助证据 |
新鲜感值得单独检查。早期的兴奋会消退,所以一个让第 3 天留存提高的机制,到第 30 天可能没有任何效果。要读完整的留存曲线,不要只看一个点;新鲜感通常持续多久,见新奇效应。
让游戏化看起来比实际更好的做法
- 衡量活动而不是核心行为。 登录送积分的例子:活跃用户 +18.0%,核心动作只有 +0.8%。
- 拿完成者和未完成者比。 只有留下来的人才能攒出 7 天连续记录,所以连续打卡组天然留存更好。要按人在结果窗口开始「之前」做了什么来定义参与,比如是否开启。
- 把第 3 天当作成功。 要看第 30 天。上线时的兴奋会消退。
- 没有护栏指标。 靠通知驱动的连续打卡,可能提高关闭通知和卸载的比例。把上面那张表里的护栏指标放在头条数字旁边。
- 照搬品牌的机制,却没有它的场景。 研究综述发现效果取决于场景和用户,所以适合语言学习应用的机制,放在项目工具里可能失败。
- 奖励了错的动作。 打开 App 送积分,教会用户的是打开 App。要奖励核心行为,否则就不奖励。
怎样在 TapCub 里检验一个游戏化机制
沿用连续打卡的例子:20,000 个新用户、一个可选的连续打卡,问题是第 30 天留存。
- 发送事件。 把机制记录成事件,例如
streak_enabled、streak_day_7、badge_earned,以及核心动作,比如project_created。新事件先进入事件收件箱,认领之后才进入正式定义。 - 定义参与者和其余的人。 在 全端分析 › 用户 › 分群与标签 里,保存一个规则分群「前 7 天内做过
streak_enabled」,再保存一个「没做过」的分群。两者都是可以重复使用的已存受众。 - 对每组分别跑留存。 在 全端分析 › 行为分析 › 行为分析 里打开留存,起始事件设为注册,回访事件设为你的核心动作,依次把每个分群作为同期群应用。留存没有对比周期,也没有拆分,所以要跑两次,把两个第 30 天的比率并排来读。要复现匹配比较,就把开启之前已知的特征加成筛选,比如渠道或平台,或者在你把首次会话时长存成用户属性的情况下,用它来筛选。
- 检查核心行为和护栏指标。 用从上手到核心动作的漏斗,以及事件分析来看护栏事件,比如关闭通知(如果你有记录的话)。
- 了解边界。 TapCub 不分流量、不跑实验,所以随机留出组需要你自己的开关系统;如果你的应用给用户属性写入分组,TapCub 之后就能比较这两组。它衡量你定义的分组,不会替你消除选择偏差,所以要把偏差和结果一起说明。
FAQ
游戏化的例子有哪些?
常见的有积分(会员计划)、徽章(上手里程碑)、连续打卡(每日课程或锻炼)、排行榜(用户之间的竞争)和进度条(完善资料或完成课程)。Duolingo 的连续打卡和排行榜、Starbucks Rewards 有公开记录;它们的数字要当作公司的说法,不是实验。
游戏化真的有用吗?
有时有用。对 24 项实证研究的综述发现多数效果为正面,但取决于场景和所涉及的用户。对你有没有用,要看它能否改变你的核心行为,比如第 30 天留存或复购,并且要用一个公平的比较来衡量。
怎样衡量游戏化是否成功?
选一个核心行为和一个窗口,再把参与者和开启之前特征相似的非参与者比较。示例里,原始的 14.6 个百分点留存差距,匹配之后缩小到 6.0 个百分点。再加上关闭通知之类的护栏指标,并读第 30 天,不读第 3 天。
游戏化最常见的错误是什么?
奖励活动而不是核心行为,或者拿完成了某个机制的人和没完成的人比较。两者都会让机制看起来有效,其实是比较方式造成的。要奖励带来价值的动作,并用机制开始之前已知的特征来比较。
不做 A/B 测试,能检验游戏化吗?
可以,只是设计更弱:分批上线、对比相同星期几的前后数据,或匹配比较。每种都有已知的偏差,所以要把偏差和数字一起报告,并把结果当作上限。如果能做随机留出组,会更强。
资料来源
- Sebastian Deterding、Dan Dixon、Rilla Khaled 和 Lennart Nacke。From Game Design Elements to Gamefulness: Defining "Gamification"。MindTrek 2011 会议论文集,ACM。本文采用的定义。文献条目于 2026-11-17 核对。
- Juho Hamari、Jonna Koivisto 和 Harri Sarsa。Does Gamification Work? A Literature Review of Empirical Studies on Gamification。第 47 届夏威夷国际系统科学会议,2014。24 项实证研究;效果为正面,但取决于场景和用户。文献条目于 2026-11-17 核对。
- Duolingo, Inc.。Form S-1,2021。关于游戏化、连续打卡和排行榜的表述。2026-11-17 阅读。
- Paul R. Rosenbaum 和 Donald B. Rubin。The central role of the propensity score in observational studies for causal effects。Biometrika 70(1),1983。在已观察到的特征上拿相似的人比较。
- Starbucks Corporation。2024 财年第三季度业绩。Starbucks Rewards 美国 90 天活跃会员数。2026-11-17 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
