最有用的电商 SEO 技巧是按优先级做:先处理筛选、排序和缺货 URL,让爬虫能找到并区分你的分类页和商品页,再改进分类页和商品页的内容,并用自然搜索落地页带来的订单,而不是排名,来判断效果。
从哪里开始:优先级顺序
多数电商 SEO 的建议,是一张十二条、权重相同的平铺清单。这掩盖了真正决定时间该花在哪里的一件事:网店最大的 SEO 问题通常是技术问题,而且排在内容之前。一个有 10,000 个几乎相同的筛选页、还有上百个空页面的网店,靠更好的商品描述是救不回来的。
按下面的顺序做,每做完一步就停下来衡量:
| 优先级 | 方面 | 先查什么 | 说明需要处理的信号 |
|---|---|---|---|
| 1 | 可抓取、可区分的页面 | 筛选和排序参数、重复 URL、空分类、缺货页 | Search Console 里有成千上万个已抓取但未收录或重复的 URL;爬虫的请求大多花在参数 URL 上 |
| 2 | 分类页 | 每种购物者的搜索方式一个页面,有标题、简介和有效的内链 | 排名前 10 的分类页点击率偏低;有的分类没有自然搜索入口 |
| 3 | 商品页 | 独有的标题和描述、一个商品一个 URL、处理好规格变体、结构化数据 | 厂商文案在许多店里原样出现;同一个商品有好几个 URL |
| 4 | 内容 | 购买指南和对比页,回答购物者购买前会问的问题 | 客服对话和搜索词里有问题,却没有页面回答 |
| 5 | 链接 | 先做指向能卖货页面的内链,再做外链 | 畅销品只能通过站内搜索找到,或者藏在菜单深处 |
优先级 1 排在最前,因为它限制着其他一切。Google 判断一个页面的重要性,主要看有多少内部链接指向它;而爬虫的访问次数如果花在参数 URL 上,留给真正卖货页面的就少了。本文接下来按这个顺序讲各个优先级,最后讲怎么判断做的事有没有用。文章只谈结构和衡量。访客到来之后怎样变成订单,见电商转化率优化;团队很小时的整体计划,见创业公司的 SEO。
筛选和排序为什么破坏最大
分面导航,也就是颜色、尺码、品牌、价格的筛选加上排序方式,能把一百个分类页变成几万个 URL。Google 关于分面导航的文档明确说了这样做的代价:爬虫会浪费大量资源去抓取海量筛选组合,之后才意识到这些 URL 没用,留给发现新的、有用页面的能力就少了。
有三类 URL 造成破坏:
- 排序和显示参数,例如
?sort=price或?view=48。它们改变的是顺序而不是内容,所以是基础页的重复页。 - 筛选组合,例如
?color=black&size=9&brand=acme。有些对应人们真实的搜索,大多数没有,而且很多根本没有商品。 - 会话和跟踪参数,由网站或广告活动附加。Google 的 URL 结构指南说,不要链接到会话 ID、跟踪码这类临时参数,要使用稳定的 URL。
对于你不想被抓取的 URL,Google 列出了几种做法,效力并不相同。对筛选参数在 robots.txt 里禁止抓取是较强的一种,前提是分类页和商品页保持可抓取。把筛选 URL 的 canonical 指向未筛选版本,可能逐步减少对重复页的抓取,但 Google 说它长期看不如 robots.txt 可靠。给链接加 nofollow 只有在指向该 URL 的每一个链接都加了才有帮助。放在 # 后面的筛选对抓取完全没有影响,因为 Google 通常忽略片段。
对于你想收录的组合,Google 的建议是用标准的 & 分隔符,让路径里的筛选顺序保持一致,对没有结果的组合返回 404 状态,而不是重定向到一个通用页面。参数 URL 背后的道理,见动态 URL。下表把这些变成针对每类 URL 的决定。对每一类用一次,而不是对每个 URL 用一次。
每类 URL 该怎么处理
下表给出每类 URL 的默认处理方式。具体到某个店,正确答案取决于搜索需求,所以套用之前先看最后一列。
| URL 类型 | 示例 | 处理方式 | 套用前先查 |
|---|---|---|---|
| 排序和显示参数 | ?sort=price | canonical 指向基础页,或在 robots.txt 里禁止该参数 | 无需检查,它们没有自己的内容 |
| 会话和跟踪参数 | ?sid=…、?utm_source=… | 不要链接到它们,内链里使用稳定的 URL | 哪些链接生成了它们 |
| 有需求的筛选组合 | ?color=black&brand=acme | 收录:自指向 canonical、放进站点地图、用 & 分隔符并保持顺序一致 | 有人搜这个词,且列出三个或更多商品 |
| 结果太少的筛选组合 | 一两个商品 | noindex,或 canonical 指向上级分类 | 上级分类是否已经覆盖这个搜索词 |
| 没有结果的筛选组合 | 没有商品 | 返回 404,不要重定向到通用页面 | 内链是否仍指向它 |
| 放在 # 之后的筛选 | #color=black | 不要依赖它:Google 通常忽略片段 | 如果必须可被抓取,就用真正的参数或路径 |
| 有自己 URL 的规格变体 | /shoe-black | canonical 指向主商品 URL | 内链、站点地图和 canonical 里 URL 形式一致 |
处理方式依据 Google Search Central 关于分面导航和电商 URL 结构的指南;哪些组合值得收录,取决于你自己的搜索需求。
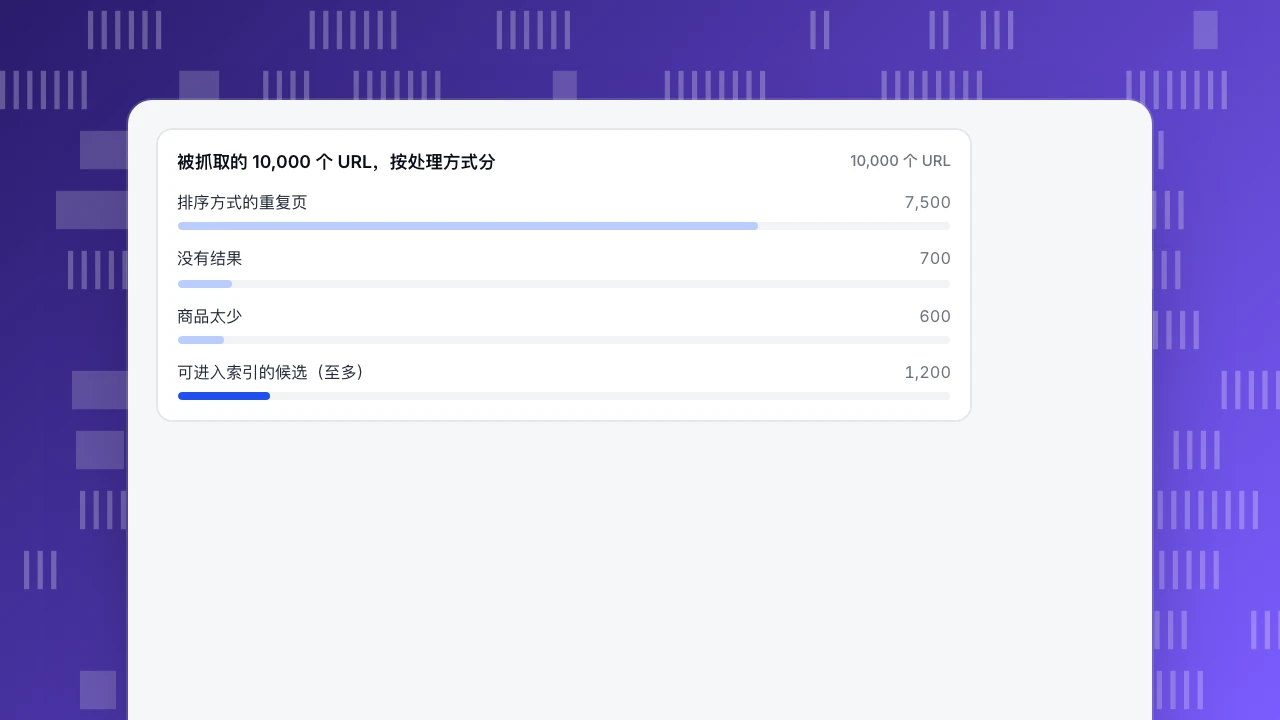
算例:10,000 个 URL,只有 1,200 个值得收录
示例数据:一家店有 20 个分类。每个分类有三个筛选:颜色 4 个值、品牌 4 个、尺码 4 个。每个筛选也可以不选,所以每个分类有 (4 + 1) × (4 + 1) × (4 + 1) = 125 种筛选状态,合计 20 × 125 = 2,500 种状态,其中包括 20 个纯分类页。每种状态还能按 4 种方式排序,所以一次抓取会发现 2,500 × 4 = 10,000 个 URL。
套用表里的规则:
- 排序变体。 每种状态里,默认排序是真正的页面,另外三种排序都是重复页。这是 2,500 × 3 = 7,500 个没有自己内容的 URL。
- 没有结果。 2,500 种状态里,700 种没有任何商品。它们应该返回 404,或者不可被链接到。
- 结果太少。 另有 600 种只有一两个商品。把它们当作不值得收录,canonical 指向上级页面,或者用
noindex。 - 剩下的。 2,500 − 700 − 600 = 1,200 种状态有三个或更多商品,其中包括 20 个分类页。
分项加起来对得上:7,500 + 700 + 600 + 1,200 = 10,000。只有 1,200 个 URL,也就是爬虫发现的 12%,是索引的候选,其余 8,800 个,即 88%,应该归并、屏蔽或移除。1,200 是上限,不是目标:在这些状态里,只保留和购物者真实搜索对得上的,比如「black running shoes」或「acme size 9」,给它们自指向的 canonical,并放进站点地图。这些数字只是演示,重点是方法:把每种 URL 模式按类型分类,数出每一类有多少,然后一次性做决定。
被抓取的 10,000 个 URL,按处理方式分
10,000 个 URL分类页
分类页通常比任何单个商品带来更多自然流量,因为它们对应「women's running shoes」这类宽泛搜索。有三件事最重要:
- 每种搜索意图一个页面。 如果购物者分别搜「trail running shoes」和「road running shoes」,就需要各自的页面,有自己的标题和简介,而不是一个带筛选的页面。
- 一个标题和一段简短简介,说明这个页面列出什么。不要在页面底部堆一大段关键词文字,它对谁都没用。
- 可抓取的链接。 Google 建议在页面标记里使用普通链接,而不是点击事件处理,并按菜单、分类、子分类、商品逐级链接,让每个想收录的商品都能被找到。只能通过站内搜索框找到的商品可能被漏掉。如果没法把所有商品都链上,站点地图或 Merchant Center 商品数据可以帮忙。
也不要让两个分类争同一个搜索词。如果「running shoes」和「jogging shoes」两个页面的列表几乎一样,见关键词蚕食。
商品页和规格变体
商品页靠具体信息取胜:确切的商品名、型号、尺码。遵守四条规则:
- 一个商品一个 URL。 Google 的电商 URL 指南说,颜色或尺码这类变体可以有自己的 URL,但如果有,canonical 应该指向主商品 URL。内链、站点地图和 canonical 里使用同一种 URL 形式。
- 给畅销的商品写自己的标题和描述。 厂商提供的文案会出现在每个卖这件商品的店里,你的页面没有任何可区分之处。重写销量前 50 的商品,而不是全部 10,000 个。
- 加上 Product 结构化数据,带价格和库存状态,让页面被理解为商品,并显示当前库存。
- 在购买按钮附近回答阻止下单的那个问题:送货时间、退货、尺码。这既是转化优化,也是内容优化,还能避免这个问题跑进客服收件箱。
缺货和下架的商品
对一个买不了的页面怎么处理,取决于商品会不会回来:
| 情形 | 处理 | 原因 |
|---|---|---|
| 暂时缺货 | 保持页面在线,在页面和结构化数据里标为缺货 | Google 关于暂停业务的指南说,应当保留页面并标为缺货;购物者和链接都还有去处 |
| 已下架,有接近的替代品 | 301 重定向到替代品 | 访客和链接权重都落在有用的地方 |
| 已下架,没有替代品 | 返回 404(或 410) | Google 把 404 和 410 同等看待,并逐步移除该 URL |
| 季节性商品,明年回来 | 保留页面并标为缺货 | 保留历史,免得重建 |
| 空分类 | 404,或为空时用 noindex | Google 建议不要收录空的或低价值的页面 |
软 404,也就是页面显示错误或「未找到」的提示却返回成功状态,可能在 Search Console 里被标出。一个下个月就会重新上架的页面,别用 noindex;也别把所有下架商品都重定向到首页,那会把访客送到毫不相干的地方。
内容和链接,适度即可
内容和链接排在第四和第五是有原因的:它们解决不了结构问题。抓取理顺、分类页和商品页没问题之后,它们才值得花时间:
- 购买指南,回答购物者购买前会问的问题。从客服对话、客服收件箱和搜索词里找选题,并把它们链到它们能帮着卖货的分类页。
- 内链:从指南和首页链到畅销品。成本低,见效快。
- 外链:来自你所在领域有分量的站点,通过指南、评测和合作获得。这是最慢、最不可控的一环,所以不该拖住其他事。
不要为没人搜的关键词写内容。一个没有任何搜索词、链接或购物者问题需要的页面,只是多一个要维护的 URL。
用订单而不是排名来评判
排名上升只是手段,不是结果。两个示例落地页能说明原因:
| 落地页 | 自然搜索会话 | 转化率 | 订单 |
|---|---|---|---|
| A:宽泛分类页 | 12,000 | 0.9% | 108 |
| B:具体商品页 | 3,000 | 3.0% | 90 |
页面 A 的流量是 B 的四倍,但页面 B 用四分之一的访问带来了几乎一样多的订单。如果你只为 A 从第 8 名升到第 5 名而庆祝,却忽略 B,就选错了该下功夫的页面。两个页面合计带来 108 + 90 = 198 个订单。每个落地页至少跟踪三样:自然搜索会话、转化率和订单。更完整的网店指标见电商数据分析。
上线改动之后,拿前后各四周的等长时段来比较,并在图上标出日期。参数清理通常要几周才会在搜索里体现,所以先看抓取情况和被收录的重复 URL 数量,之后再看订单。
常见误区
- 把所有筛选页都设成 noindex。 有少数组合对应真实搜索,值得收录;分清是哪些要靠数数,而不是一刀切的规则。
- 以为 canonical 能阻止抓取。 canonical 是归并信号,Google 说它减少重复页抓取的可靠性不如 robots.txt。如果问题本身就出在抓取上,就屏蔽这些参数。
- 删除会回来的缺货页。 你会失去历史和链接,找到这个页面的购物者看到的是错误页。
- 在修好 10,000 个 URL 之前先重写 10,000 条描述。 先修抓取,再给畅销品写内容。
- 追逐不带来转化的词的排名。 宽泛的词可能带来流量却没有订单。按落地页数订单。
- 把机器人访问当成需求。 爬虫和抓取程序会抬高会话数、扭曲转化率。做决定用的数字里要把它们排除。
在 TapCub 里找清理的优先项
以上面 10,000 个 URL 的店为例,用 TapCub 看看它现在的状况。TapCub 衡量的是搜索和爬虫的行为;它不是爬虫,也不是站点审计工具,不会修改你的 robots 规则、canonical 或 noindex 标签,这些仍然在你的网店平台上改。
- 接入搜索数据。 在 监测 › 搜索表现 里连接 Google Search Console 或 Bing Webmaster,就能按页面、查询词和国家看点击、展现、点击率和平均排名。排名前 10 但点击率低于中位数的页面会被标出,因为这里先改标题和描述最划算。搜索数据晚 1 到 3 天,没有连接账号时,点击为空表示没有数据,不是流量为零。
- 看爬虫抓了什么。 监测 › 抓取健康 按搜索引擎显示抓取次数、成功率、不同页面数、404 和 5xx;如果设置了站点地图地址,还会拿站点地图和实际抓取对比。放在示例里,这个对比就能看出那 1,200 个页面有没有被抓取。它需要服务端记录,因为页面脚本给不出状态码,见抓取健康帮助页。爬虫的 404 和访客的 404 是分开的,访客 404 在 网站统计 › 页面 的 404 页签里,列出命中次数和上一个页面。两边都出现的路径先修。
- 知道页面报表会隐藏什么。 TapCub 记录页面时会去掉查询字符串,所以每一个筛选和排序变体,在 网站统计 › 页面 里都显示为同一个路径。这让流量保持可读,同时也意味着这个报表看不出参数爆炸,这要靠 Search Console 和抓取记录。UTM 标签作为来源字段保存,出现在 网站统计 › 来源 里。
- 按落地页衡量订单。 给订单事件定义一个目标并打开 启用收入统计,然后打开 网站统计 › 目标。细分可以按来源、入口页、国家或设备拆分转化:用来源拆分看自然搜索的转化,用入口页拆分看哪些落地页转化好。人和机器人默认分开统计,所以识别出的爬虫不会抬高会话数或稀释转化率。多次访问的旅程,全端分析 › 行为分析 › 行为分析 里的归因,默认可以按 30 天回看窗口,把购买记在更早会话的落地页上。
常见问题
电商 SEO 最重要的建议有哪些?
先修抓取和重复 URL,再做分类页,再做商品页,最后做内容和链接。筛选和排序参数、空分类和缺货页,是多数网店最大的结构问题。用自然搜索落地页带来的订单来衡量结果,而不是只看排名。
电商网站怎么做 SEO?
先让抓取干净:归并或屏蔽参数 URL,对没有结果的组合返回 404,每个商品只留一个 URL。然后为每种搜索方式写分类页,给畅销品写自己的标题和描述,加上 Product 结构化数据,并按落地页跟踪自然搜索订单。
筛选页要不要 noindex?
不是全部。对应真实搜索、商品数足够的筛选组合,可以用自指向的 canonical 收录。排序方式、没有结果和结果太少的组合,应该归并、屏蔽或移除。先分类数清楚再决定;一刀切的 noindex 会把有用的也一起去掉。
缺货的商品页该怎么办?
商品会回来的,保留页面,在页面和结构化数据里标为缺货。已下架但有接近的替代品,301 重定向到替代品。没有替代品,返回 404 或 410。不要把所有页面都重定向到首页。
电商 SEO 多久见效?
技术清理最先体现在抓取和索引报表里,常常几周内就能看到,排名和订单则更慢。改动前后拿等长时段比较,比如各四周,评判参数修复时,先看被抓取的重复 URL 数量,再看销量。
资料来源
- Google Search Central,Managing crawling of faceted navigation URLs。核对于 2026-11-17。
- Google Search Central,Designing a URL structure for ecommerce sites。核对于 2026-11-17。
- Google Search Central,Help Google understand your ecommerce site structure。核对于 2026-11-17。
- Google Search Central,Temporarily pause or disable a website(保留缺货页面)。核对于 2026-11-17。
- Google Search Central,HTTP status codes, network and DNS errors(404 与 410 同等看待;软 404)。核对于 2026-11-17。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
