数据滥用,要么是从可靠的数据里得出误导性的结论,比如截断的坐标轴或挑选的时间窗,要么是把个人数据用在收集目的之外。前者导致错误的决定;后者伤害人,并可能违反 GDPR 等法律。下面是七个带数字、可复算的例子,每个配一条预防规则,以及发布前要过一遍的检查清单。
读完你会知道
- 柱子从零开始;纵轴从 980 起画的 6% 增长看起来像 4 倍
- 总体可能在每个分组内都反转:伯克利 1973 年总体是 44.5% 对 30.3%,按统一的申请人构成则是 38.8% 对 42.9%
- 每个个人数据字段都要对应明确的用途;新的用途是一项新决定
什么算数据滥用?
数据滥用有两类,修法不同。
- 滥用分析。 数据没问题,但由它得出的结论有问题:截断的坐标轴、挑选的时间窗、把相关读成因果。后果是做出错误的决定。
- 滥用数据本身。 为一个目的收集的个人数据被用在另一个目的上,或收集的数据超出了目的所需。受伤害的是数据里的人,在一些地区,这还构成违法。
第二类,欧盟的 GDPR 有明确规定。第 5 条第 1 款(b)项要求个人数据为「特定、明确、合法的目的」而收集,并且不得以与这些目的不相容的方式进一步处理;第 1 款(c)项要求数据对这些目的而言「充分、相关,并限于必要范围」。下面的七个例子取自两类。每个例子先用数字展示错误(除非另有说明,均为示例数据),再给出防止它的规则。同一问题在认知层面的部分,见偏差类型;不同工具的数字对不上,见数据差异。
例 1:截断的坐标轴让 6% 看起来像 300%
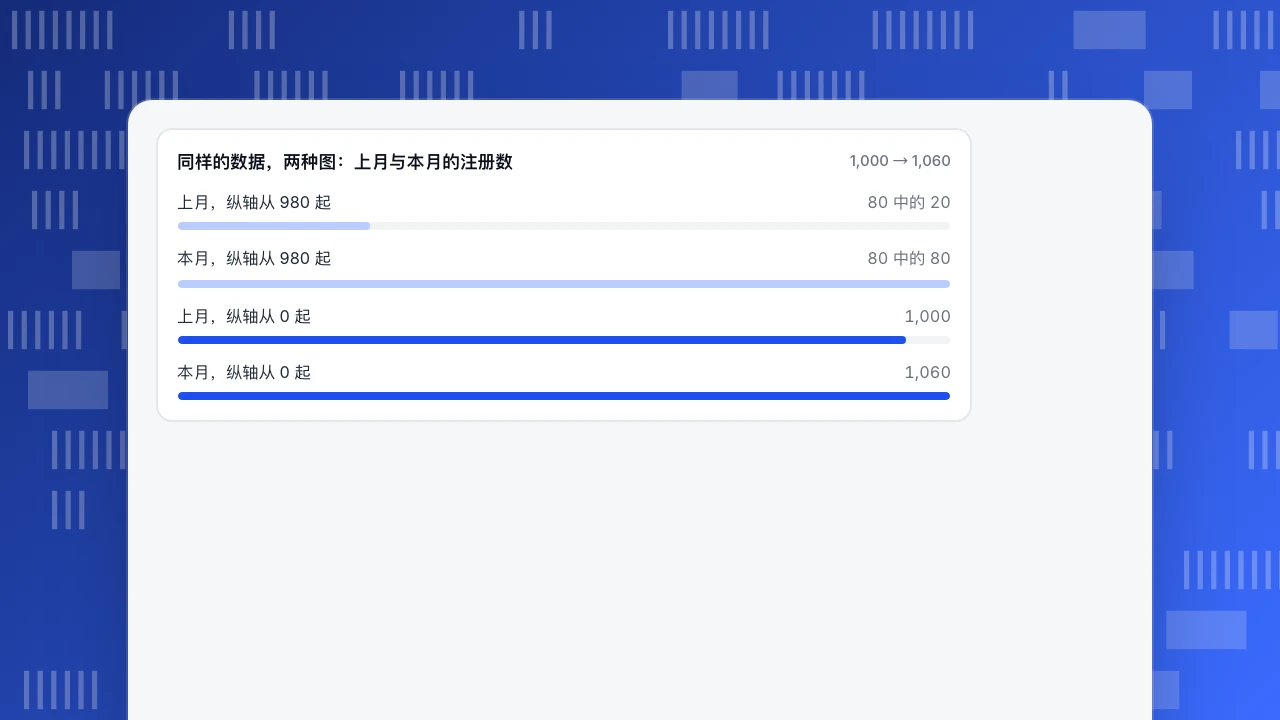
示例数据:上个月注册 1,000 个,这个月 1,060 个,增长 6%。把柱状图的纵轴从 980 开始画,两根柱子分别高 20 个单位和 80 个单位。第二根看起来是前一根的四倍。
| 画法 | 上月 | 本月 | 眼睛读到的 |
|---|---|---|---|
| 纵轴从 980 起 | 高 20 个单位 | 高 80 个单位 | 增长 4 倍 |
| 纵轴从 0 起 | 高 1,000 个单位 | 高 1,060 个单位 | 增长 6% |
规则: 柱子用长度编码数值,所以柱状图要从零开始。如果值得关注的变化很小,就用折线图(由位置而不是长度承载数值),并在旁边用百分比标出变化。双纵轴图同样要小心:重新缩放其中一条轴,两条毫不相关的线也会看起来同步变化。
同样的数据,两种图:上月与本月的注册数
1,000 → 1,060例 2:总体说一回事,每个分组都说相反的事
这就是辛普森悖论,最著名的数据是 1973 年加州大学伯克利分校的研究生录取,由 Bickel、Hammel 和 O'Connell(1975)分析。总体上,男性的录取率明显高于女性。下表是六个最大的系,数据按已发表的结果列出:
| 系 | 男性申请人数 | 男性录取率 | 女性申请人数 | 女性录取率 |
|---|---|---|---|---|
| A | 825 | 62% | 108 | 82% |
| B | 560 | 63% | 25 | 68% |
| C | 325 | 37% | 593 | 34% |
| D | 417 | 33% | 375 | 35% |
| E | 191 | 28% | 393 | 24% |
| F | 373 | 6% | 341 | 7% |
按申请人数加权,这六个系录取了 2,691 名男性中的 44.5%、1,835 名女性中的 30.3%,女性低 14 个百分点。然而六个系中有四个系女性的录取率更高。原因在于大家申请了哪里:多数女性申请了录取率低的系(C 到 F),多数男性申请了录取率高的系(A 和 B)。给两个群体套用同样的申请人构成,即每个系都按其申请总人数计权,录取率就变成男性 38.8%、女性 42.9%,方向反转。
规则: 引用两个群体之间的差距之前,先按最可能的主要驱动因素(这里是系)拆分,看方向在每个分组内是否依然成立。两个数都可能是诚实的,所以要先判断哪种比较回答的是你要问的问题。
| 例子 | 出了什么问题 | 规则 |
|---|---|---|
| 截断的坐标轴 | 6% 的增长被画成 4 倍 | 柱子从零开始 |
| 辛普森悖论 | 总体在各分组内反转 | 按最大的驱动因素拆分 |
| 挑选的时间窗 | 九个窗口里报告最突出的一个 | 看数据之前固定时间窗 |
| 相关当因果 | 比较的是自选分组 | 匹配或留出对照 |
| 极小样本 | 3 对 2 个注册被说成好 50% | 展示计数和区间 |
| 偏态数据的均值 | 均值 114.53 美元,中位数 30 美元 | 报告中位数 |
| 改变用途的个人数据 | 发收据的邮箱被用于广告排序 | 每个字段一行用途 |
发布任何数字之前,先过一遍七项检查清单。
例 3:挑一个能讲出故事的时间窗
示例数据:12 周的每周转化率(%):2.1、2.4、2.0、2.6、3.1、2.2、2.0、1.9、2.3、2.2、2.5、2.1。12 周平均是 2.28%。把每个 4 周区间都找一遍,表现突出的是第 2 到 5 周:2.53%,「比平均高 11%」。而最近四周的平均是 2.28%,没有任何变化。
规则: 看数据之前先固定时间窗和比较对象。比较要同类对同类(同样长度、同样季节),并在任何被突出的区间旁边展示完整序列。试了九个时间窗再报告数字漂亮的那个,结果是挑出来的,不是发现的。
例 4:把相关当成因果
示例数据:500 位试用了新功能的用户里,300 位在 30 天后仍活跃(60%);4,500 位没试用的用户里有 1,350 位(30%)。标题是「这个功能让留存翻倍」。但愿意试新功能的通常是积极的用户,他们本来就会留下;功能本身可能几乎没起作用。
规则: 自选分组之间的差距衡量的是谁做了选择,而不是这个选择带来了什么。要比较有同等机会试用的人(留出对照,或用先前活跃度相近的匹配组),并把原始差距当作上限。
例 5:从极小的样本算出百分比
示例数据:页面 A 的 50 位访客中有 3 位注册(6%),页面 B 的 50 位中有 2 位(4%)。「页面 A 的转化率高 50%。」再多一个注册,结论就翻转了。95% 的 Wilson 区间,A 是 2.1% 到 16.2%,B 是 1.1% 到 13.5%,几乎完全重叠。
规则: 引用比率时把计数写在旁边,任何不到几百位访客的分组都要给出区间,或说明样本很小。见误差范围和统计功效。
例 6:没有任何客户符合的平均数
示例数据:15 笔订单,金额分别是 18、20、22、24、25、26、28、30、35、40、45、50、60、95 和 1,200 美元。均值是 114.53 美元,中位数是 30 美元。一笔大宗订单把均值拉到中位数的近四倍,15 位客户里有 14 位的花费低于均值。
规则: 对订单金额这类偏态数据,报告中位数和离散程度(比如第 25 到第 75 百分位),并说明去掉了多少个异常值、为什么去掉。这里中间一半订单的金额在 24.50 到 47.50 美元之间,比 114.53 美元的均值更能描述一位典型客户。
例 7:把个人数据用在人们没同意的目的上
一家商店为了发收据而收集了邮箱地址。后来,市场团队把同一份名单上传去投放广告,分析团队又把它和行为数据关联起来,按预测消费额给人排序。没有谁偷了什么,数据依然被滥用了:目的变了。按 GDPR 第 5 条第 1 款(b)项,进一步使用必须与最初目的相容;而按预测特征给人排序属于「画像」,第 4 条第 4 款把它定义为用于评估偏好、行为或位置等个人方面的自动化处理。
相关的错误是收集超出问题所需的数据。如果你只想知道表单有没有被提交,就不需要知道人们在里面填了什么。
规则: 对收集的每个字段,用一行写明用途。新的用途不在清单上,就把它当作一项新决定,法律要求时重新告知或取得同意。只收集能回答问题的最少数据。
发布数字之前的检查清单
- 坐标轴和刻度。 柱子是否从零开始?并排的图刻度是否相同?
- 基数和时间窗。 分母写明了吗?时间窗是在看数据之前固定的吗?
- 拆分。 差距在最大的子分组(系、渠道、设备)内是否依然成立?
- 样本。 是否展示了计数?有没有哪个分组小到需要区间?
- 因果。 分组是人们自己选的吗?如果是,就标为关联。
- 平均数。 分布是否偏态?展示中位数。
- 用途。 每个个人数据字段是否都对应明确的用途和保留期?
在 TapCub 里同时防住这两类问题
以例子里的注册漏斗为例。你想要诚实的数字,也想让数据足迹尽量小。
- 展示计数。 在 全端分析 › 行为分析 › 行为分析 里,漏斗会列出每一步的进入人数、转化人数和比率。像小样本的例子那样,引用比率时把计数一起写上。
- 让时间窗保持诚实。 读结果之前先设定日期范围,并用 配置 › 日期标注 标出上线,让序列里的变化有解释,而不是被挑出来。
- 让机器人不进基数。 网站统计 › 机器人 单独统计爬虫,所以它们不会抬高访客数、也不会拉低转化率。
- 先拆分再比较。 给同一个漏斗套用一个分群(全端分析 › 用户 › 分群与标签),检查差距在每个分组内是否依然成立。
- 限制收集的内容。 配置 › 合规中心 设置采集档位、保留期和数据主体请求;表单跟踪开启后只记录表单的 id、name 和 action,不记录人们填写的内容。配置 › 设置 › 公开分享 让你选择开放哪些模块,可选密码和天数限制;访客列表和会话不能公开分享。
TapCub 不会告诉你一个比较是否有因果关系;这个判断仍然在你和上面的清单手里。
常见问题
什么是数据滥用?
数据滥用要么是从可靠的数据里得出误导性的结论(截断的坐标轴、挑选的时间窗、把相关读成因果),要么是把个人数据用在收集目的之外。前者导致错误的决定;后者伤害人,并可能违反 GDPR 等法律。
误导性的数据分析有哪些例子?
把柱状图的纵轴从 980 开始,让 6% 的增长看起来大四倍;每个分组都相反时还拿总体来比较(1973 年伯克利);从九个可能的时间窗里报告数字漂亮的那个;订单中位数是 30 美元时却引用 114.53 美元的均值。
把客户数据用于新目的算滥用吗?
可能算。按 GDPR 第 5 条第 1 款(b)项,为特定目的收集的个人数据不得以不相容的方式进一步处理。发收据的邮箱被拿去投放广告和排序,就是典型情形。新用途开始之前,先检查相容性,或重新取得同意。
怎样避免滥用数据?
看数据之前先固定时间窗和比较对象,柱状图从零开始,小分组展示计数和区间,大的差距按最大的驱动因素拆分,每个个人数据字段都对应明确的用途。发布之前对照检查清单复查。
资料来源
- P. J. Bickel、E. A. Hammel 和 J. W. O'Connell,Sex Bias in Graduate Admissions: Data From Berkeley,Science 187(4175),1975,398–404。各系数据取自辛普森悖论词条的整理表(Wikipedia,核对于 2026-11-21);加权录取率为本文复算。
- GDPR,第 5 条:个人数据处理的原则。目的限制 (1)(b) 和数据最小化 (1)(c)。核对于 2026-11-21。
- GDPR,第 4 条:定义。第 4 款对画像的定义。核对于 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
