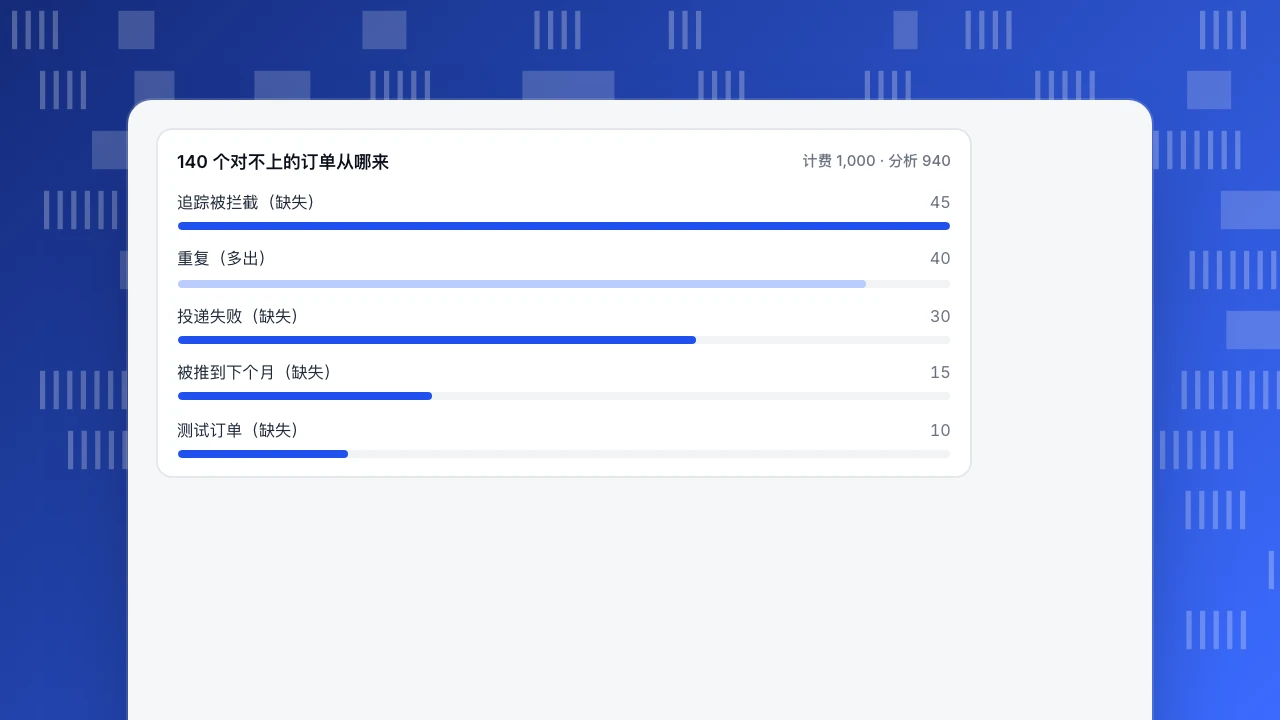
数据集成问题很少报错,它们表现为两个系统对不上。在一个窗口内对账一个单位,按稳定 ID 关联,把每一行对不上的记录分类。示例里,6.0% 的净差异(940 对 1,000 个订单)藏着 140 行问题记录,即 14.0% 的总差异,因为 40 个重复抵消了 100 个缺失订单中的一部分。
读完你会知道
- 同时报净差异和总差异:重复抵消缺失时,−6.0% 的净差异藏着 14.0% 的总差异
- 重试会造成重复和丢失:每次写入都以事件 ID 作键,并先确认再处理
- 每日合计能暴露月合计藏起来的时区和投递问题
怎么判断数据集成出了问题?
大多数集成问题不会报错。管道在跑,看板能打开,数字却悄悄地错了。第一项诊断是对账:选一个单位(订单、注册、工单)、一个窗口(一个自然月、同一个时区),在两个系统里各数一遍。
示例数据:你的计费系统这个月记录了 1,000 个订单;分析工具里显示 940 个。
- 净差异 =(940 − 1,000)÷ 1,000 = −6.0%
这看起来像一个 6% 的问题,其实不是。按订单 ID 把两份清单连起来,把只出现在一边的每一行分类:
| 分类 | 订单数 | 含义 |
|---|---|---|
| 分析里缺失:浏览器里的追踪被拦截 | 45 | 从未发出 |
| 分析里缺失:投递失败或超时 | 30 | 发出了,没到达 |
| 分析里缺失:因时区被推到下个月 | 15 | 到达了,但落在窗口的另一边 |
| 分析里缺失:只在计费里的测试订单 | 10 | 并不是真正的缺口 |
| 分析里多出:重复 | 40 | 同一个订单被数了两次 |
缺失 = 45 + 30 + 15 + 10 = 100,多出 = 40,所以 1,000 − 100 + 40 = 940。总的问题是 100 + 40 = 140 行,即 14.0%,是净差异 6.0% 的两倍多,因为重复抵消了一部分缺失。很小的净差异可能藏着很大的总差异,所以两个都要报。
140 个对不上的订单从哪来
计费 1,000 · 分析 940八种常见的故障模式是什么?
| # | 故障 | 数据里的信号 | 常见修法 |
|---|---|---|---|
| 1 | 重复投递 | 同一个事件 ID 或订单 ID 出现两次 | 存下已处理的事件 ID,忽略重复 |
| 2 | 投递丢失 | 一边的计数偏低,且时间上有空档 | 快速响应、重试、补发缺失事件 |
| 3 | 事件乱序 | 「已退款」比「已付款」先被处理 | 不依赖到达顺序;去拉取当前状态 |
| 4 | 身份不匹配 | 按邮箱关联命中 70% 的行;按用户 ID 命中 95% | 选定一个键;先哈希并标准化再关联 |
| 5 | 时区和日界线偏移 | 每日合计不同,月合计几乎一致 | 两边用同一个报表时区 |
| 6 | 字段结构漂移 | 某个字段的空值率一夜之间跳升 | 做字段级监控;提前约定变更 |
| 7 | 定义不一致 | 只有一边的收入含税 | 在两边写下每个指标的定义 |
| 8 | 上限和截断 | 整数:正好 100,000 行或 50,000 条结果 | 了解上限;拆分加载;盯行数 |
用这些「如果—那么」规则挑第一个嫌疑对象:
- 如果月合计一致但每日合计不一致,怀疑时区或迟到数据。
- 如果一边更高,且多出来的行有相同的 ID,怀疑重复。
- 如果一边更低,且缺失的行在时间上成团,怀疑故障或投递丢失。
- 如果缺口只存在于某个平台或某个细分,怀疑身份。
- 如果每一行都差一个相近的比例,比如销售税率,怀疑定义。
后面各节按通常最值得的顺序逐个讲,从示例里最大的分类开始。
| 故障 | 数据里的信号 | 常见修法 |
|---|---|---|
| 重复投递 | 同一个事件或订单 ID 出现两次 | 存下已处理的 ID,忽略重复 |
| 投递丢失 | 计数偏低,时间上有空档 | 快速响应、重试、补发 |
| 身份不匹配 | 按邮箱关联率 70%,按用户 ID 95% | 一个稳定的键,哈希前先标准化 |
| 时区偏移 | 每日合计不同,月合计几乎一致 | 统一一个报表时区 |
| 定义不一致 | 每一行的差距比例相同 | 在两边写下定义 |
| 上限和截断 | 正好 100,000 行或 50,000 条结果 | 了解上限,对比行数 |
示例数据:关联率和计数仅作示意;故障清单列的是信号最清楚的六种模式。
重复和丢失是怎么发生的?
事件驱动的集成(webhook、服务器到服务器的调用)在设计上就会重试。Stripe 的文档说,webhook 端点「偶尔可能会不止一次收到同一个事件」,建议记录你已处理的事件 ID,并说如果你的端点没有返回成功状态,它会以指数退避尝试投递最长三天。它还说,端点必须在执行复杂逻辑之前快速返回 2xx 状态,否则投递会超时。
示例里缺口的两半都来自这种行为:
- 重复(多出 40 个订单)。发送方在响应太慢后重试,接收方把重试当成了新订单。修法是幂等:Stripe 的 API 接受最长 255 个字符的幂等键,保存第一次请求的结果并在重试时返回它,键至少 24 小时之后才会被清除。你这边用同样的思路:每次写入都以事件 ID 或订单 ID 作键。
- 投递丢失(缺失 30 个订单)。接收方当时宕机了,或者在回复之前做重活而超时。先确认收到,再用队列处理,然后每天对账,让缺口不至于存在一个月。
事件乱序来自同一个地方:Stripe 声明它不保证按事件产生的顺序投递,并且 created 时间戳精确到秒,所以不同的事件可能有相同的值。不要用到达时间或 created 来判断哪个事件更新;去源系统拉取当前对象。
为什么身份、时区和定义的错误能存在几个月?
这三种看起来都不像错误,所以才持续得久。
身份。同一个人可能表现为用户 ID、邮箱哈希、设备 ID 和账户 ID。算一下关联率:1,000 个订单里,有多少能在另一个系统里对上一个已知的人?示例数据:按邮箱关联命中了 700 个(70.0%),按用户 ID 关联命中了 950 个(95.0%)。25 个点的差距说明很多行的邮箱缺失或格式不同。哈希之前先统一大小写和空格,并按最稳定的键关联。
时区。在一个时区里 23:30 的订单,在另一个时区已经是明天。示例里,在月末最后几小时下的 15 个订单,在分析一侧落进了下个月。每日合计可能差几个百分点,月合计却看起来差不多,所以一开始要每天对账。选定一个报表时区,并在每个数字旁边写明。
定义。「收入」是个好测试。比如 Stripe 自己的 MRR 定义就不含试用、一次性发票、税和按量计费。如果分析里显示含税的订单总额,而计费里显示不含税的订阅收入,任何技术修复都不会让它们一致。在两边写下每个共享指标的定义。
上限、迟到数据和字段结构漂移是什么样?
上限和截断。停在整数上的数字值得怀疑。一次最多接受 100,000 行的文件导入,或最多返回 50,000 行的查询,如果你不对比行数,就会悄悄丢掉更大一批数据的其余部分。每一批都要记录「进多少行」「出多少行」。
迟到数据。回填常常会改写时间。比如在 TapCub 的服务端接口里,time 与服务器时钟相差超过 72 小时的事件,会被改写为接收时间并给出警告。一批较早的事件于是落到接收那天,在没有任何错误的情况下,让每日合计发生偏移。
字段结构漂移。某个字段被改名,类型从数字变成文本,或某个值出现新格式。信号是某个字段的空值率或去重值个数突然跳升。按字段按天跟踪这两个数;空值率从 2% 跳到 35%,就告诉你变更是哪一天上线的。
有没有可重复的诊断方法来排查差异?
- 选一个单位和一个窗口。一个月、一个时区、一种「订单」的定义。
- 数两边,也数缺口。像示例一样报净差异和总差异:净 −6.0%,总 14.0%。
- 按稳定 ID 关联。列出只在 A、只在 B,以及两边都有但值不同的行。
- 给每一行分类:被拦截、失败、时间窗口、测试数据、重复、定义。「其他」不要超过缺口的 5%。
- 先修最大的一类。示例里按大小:被拦截的追踪(45),然后是重复(40),然后是投递丢失(30),再然后是时区偏移(15)和测试订单(10)。
- 下一个周期重跑同样的对账。设一个阈值,比如总差异超过 3%,越线时通知你。
想了解预防这些问题的架构选择,见数据集成方式;定义见数据集成。
在 TapCub 里怎么发现这些问题?
把上面的对账套用到以 TapCub 为接收方的情形。
- 在全端分析 › 数据管理 › 数据质量查看采集警告和采集端拒收:它们按原因和日期列出,例如域名不匹配、排除规则、月度配额、频率限制、无效载荷和机器人。某个原因突然上升,就能解释一类「缺失」,时钟偏差则出现在采集警告里。
- 打开全端分析 › 数据管理 › 埋点方案,打开实时验证(24 小时)。每个计划中的事件会显示 24 小时内的命中次数和必填属性的完整度,所以不再到达的字段会表现为完整度偏低。
- 查看全端分析 › 数据管理 › 事件收件箱里到了却没人认领的事件:由字段结构漂移造成的改名事件通常落在这里。
- 对于服务端事件,发送
insert_id,并让time与服务器时钟相差不超过 72 小时。更早的历史,用全端分析 › 数据管理 › 数据导入里的日志导入或 CSV 事件,每个文件最多 100,000 行。 - 调用
tapcub.login,让网站、应用和服务端事件归到同一个人名下,然后重跑你的关联率检查。
TapCub 会告诉你它收到了什么、拒收了什么。它不会连接你的计费系统替你对账,所以请把来源系统里的订单或工单清单留作基准。
常见问题
数据集成最常见的问题有哪些?
最常见的是重复和丢失的投递、系统之间不匹配的身份、时区和定义的差异、没人通知的结构变更,以及对行数的悄悄限制。大多数表现为数字略有偏差,而不是报错。
怎么排查数据集成?
在一个窗口内于两个系统里数同一个单位,按稳定 ID 关联,把只出现在一边的每一行分类,先修最大的一类,再重跑同样的对账。同时报告净差异和总差异。
为什么两个系统的数字不一样?
通常是因为定义、时区、身份键不同,事件重复或缺失,或机器人和测试数据之类的筛选。当错误互相抵消时,6% 的净差异可能藏着 14% 的总差异。
怎么避免集成里的重复数据?
让写入幂等:每条记录以事件 ID 或订单 ID 作键,存下已处理的 ID,忽略重复。Stripe 对 webhook 和 API 请求都记录了同样的做法。
多久对账一次?
一开始每天一次,因为每日合计能暴露月合计藏起来的时区和投递问题。总差异持续低于阈值之后,改为每周一次。
资料来源
- Stripe,Receive Stripe events in your webhook endpoint:重复事件、最长三天的重试、不保证顺序、快速返回 2xx。核对日期 2026-11-21。
- Stripe,Idempotent requests:最长 255 个字符的幂等键、保存的结果、键至少 24 小时后才被清除。核对日期 2026-11-21。
- Stripe,Understanding monthly recurring revenue (MRR) and annual recurring revenue (ARR):MRR 不含试用、一次性发票、税和按量计费。核对日期 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
