混淆变量和潜伏变量都是与原因和结果相关的第三个因素;常见的区别是混淆变量被测量了,潜伏变量没有,所以只有前者能调整。两张示例表和 1973 年伯克利录取数据说明了这个区别为什么重要:下面的表里,固定住混淆变量后,落后 10.6 个点变成了领先 3.5 个点。
读完你会知道
- 同一个问题,可见度不同:混淆变量在数据里,可以分层;潜伏变量不在,除非你开始记录它(也有资料把两个词当同义词)
- 合并数字可能反转:看视频 15.0% 对没看 25.6%,在每种访客类型内部变成 +2.0 和 +5.0 个点;伯克利对女性不利的 14.1 个点差距,按院系调整后变成对女性有利 4.3 个点
- 靠测量来解决:对已测量的分层并标准化,对没测量的开始记录,无法记录时随机分配
混淆变量和潜伏变量有什么区别?
两者都是与解释变量、响应变量同时相关的第三个变量,因此可以伪造、掩盖或扭曲前两者之间的联系。通常的分界线是「是否知道它」:混淆变量是研究已经识别或测量到的变量,潜伏变量则是没人测量的混淆因素,所以无法对它做调整。Peter Dunn 的开放教材《Scientific Research and Methodology》是这样写的:混淆变量是「与响应变量和解释变量都相关的外部变量」,而「有些混淆变量也被称为潜伏变量:如果它们没有被测量、评估、描述或记录的话」。
用法并不统一。一些课程和网站把两个词当同义词,也有人把「潜伏」留给根本没被想到的变量。如果你是为课程或审稿人写作,先确认他们用哪种定义。对分析工作来说,「已测量与未测量」的区分最能改变你下一步怎么做,所以本文采用这一种。
两者并排比较是什么样?
| 混淆变量 | 潜伏变量 | |
|---|---|---|
| 同时与原因和结果相关 | 是 | 是 |
| 数据里有没有测量 | 有(至少已识别) | 没有 |
| 能不能分层或调整 | 能 | 测量之前不能 |
| 典型分析场景 | 访客类型(新访客 / 回访)在数据里,并且和谁看到某个功能混在一起 | 客户套餐规模或购买意向没有记录,却同时推动功能使用和留存 |
| 对结果的影响 | 让总数字反转或被夸大 | 同样,但你看不出原因 |
| 第一步怎么处理 | 按它拆开,在组内比较 | 开始记录它,或者随机分配谁接受处理 |
这张表说明了区分为什么在实践中有用。两列里的问题是一样的,不同的是你能不能看到分组。
| 问题 | 混淆变量 | 潜伏变量 |
|---|---|---|
| 同时与原因和结果相关? | 是 | 是 |
| 数据里有没有测量? | 有,或至少已识别 | 没有 |
| 能不能调整? | 能:分层、标准化、建模 | 测量之前不能 |
| 典型处理 | 在组内比较 | 开始记录,或随机分配 |
各教材用法不一,有的把两个词当同义词。本文采用「已测量与未测量」的区分。
营销报表里的混淆变量长什么样?
示例数据:2,000 名访客,按是否看了定价页上的演示视频、以及是新访客还是回访访客拆分。问题是看视频是否有助于购买。
| 访客类型 | 是否看了视频 | 访客数 | 购买数 | 转化率 |
|---|---|---|---|---|
| 新访客 | 是 | 800 | 80 | 10.0% |
| 新访客 | 否 | 200 | 16 | 8.0% |
| 回访访客 | 是 | 200 | 70 | 35.0% |
| 回访访客 | 否 | 800 | 240 | 30.0% |
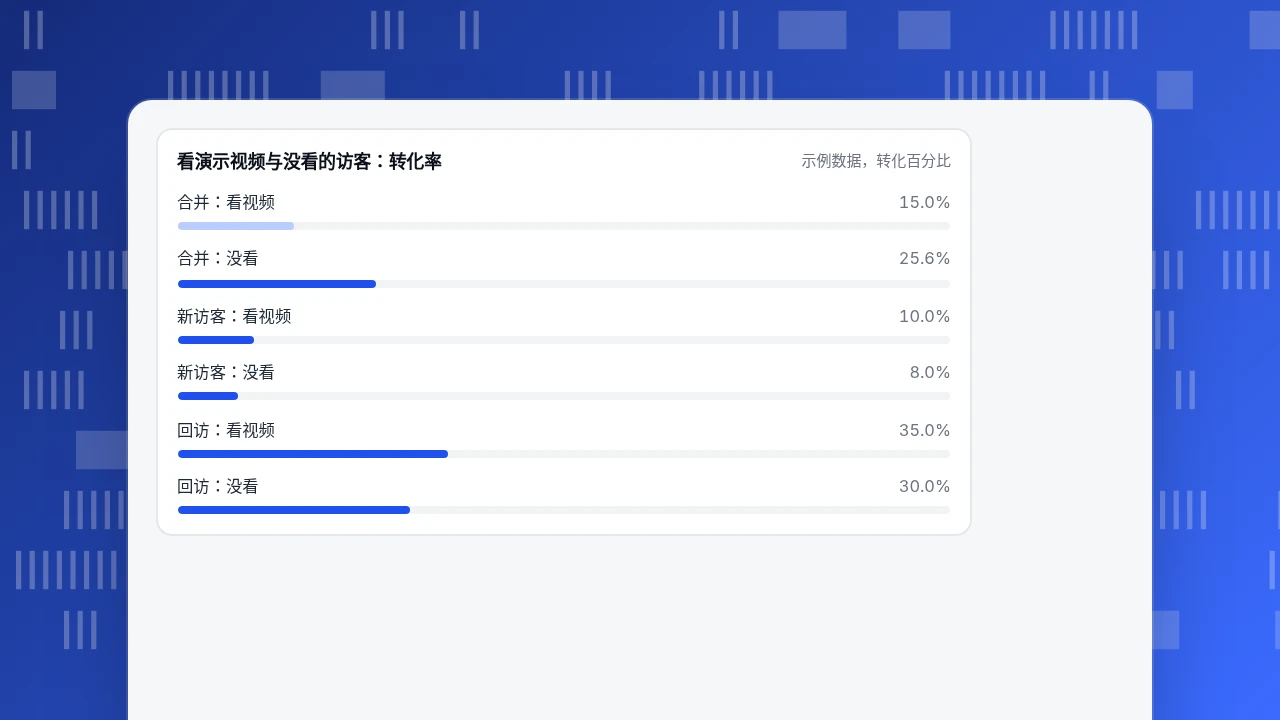
合在一起算,看视频的人 1,000 个里买了 150 个(15.0%),没看的 1,000 个里买了 256 个(25.6%)。看视频似乎让转化率少了 10.6 个百分点。可是在每种访客类型内部,看视频的人转化更高:新访客 +2.0 个点,回访访客 +5.0 个点。合并结果之所以反转,是因为看视频的人大多是新访客(1,000 里有 800 个),他们不管看什么转化率都低;没看视频的人大多是回访访客(1,000 里有 800 个),本来就更可能购买。访客类型同时与「看视频」和「购买」相关:它是混淆变量,而且在数据里,所以可以处理。
让两组有同样的访客构成(新访客 1,000、回访 1,000),比较就变成:看视频 22.5%,没看 19.0%,差 +3.5 个点。这种反转现象有个名字,叫辛普森悖论。
看演示视频与没看的访客:转化率
示例数据,转化百分比产品报表里的潜伏变量长什么样?
示例数据:1,200 名用户,按首月是否使用过某个报表功能拆分,结果指标是 90 天留存。正在看的那份报表里没有记录账户套餐。
| 分组 | 用户数 | 90 天后留存 | 留存率 |
|---|---|---|---|
| 用过该功能 | 600 | 380 | 63.3% |
| 没用过 | 600 | 216 | 36.0% |
27.3 个点的差距,看起来像是在新手引导里推这个功能的理由。现在假设有人把套餐加成了一列。
| 套餐 | 是否用过功能 | 用户数 | 留存数 | 留存率 |
|---|---|---|---|---|
| Pro | 是 | 500 | 350 | 70.0% |
| Pro | 否 | 100 | 66 | 66.0% |
| Free | 是 | 100 | 30 | 30.0% |
| Free | 否 | 500 | 150 | 30.0% |
在 Pro 内部,差距是 4 个点;在 Free 内部是 0。Pro 用户用这个功能的比例高得多(600 人里 500 人),也无论用不用都更容易留下来。把两组标准化到同样的套餐构成(Pro 占 50%)后,留存率是 50.0% 对 48.0%,差距是 2.0 个点,而不是 27.3 个点。套餐没被记录的时候,它是潜伏变量:27.3 个点的差距背后有一个谁也看不见的推手。一旦它成为一列数据,就成了混淆变量。
真实数据里也会这样吗?
会。最著名的案例是 Bickel、Hammel 和 O'Connell 在《Science》(1975)上分析的 1973 年加州大学伯克利分校研究生录取数据。1973 年秋季的数据里,8,442 名男性和 4,321 名女性申请,约 44% 的男性和 35% 的女性被录取,这个差距看起来像是对女性的歧视。作者发现这来自申请人选择的院系:女性更多申请了对所有人都更难进入的院系。
R 内置的 UCBAdmissions 数据集包含六个最大的院系(4,526 名申请人),重新计算如下:
| 院系 | 男性申请数 | 男性录取率 | 女性申请数 | 女性录取率 |
|---|---|---|---|---|
| A | 825 | 62.1% | 108 | 82.4% |
| B | 560 | 63.0% | 25 | 68.0% |
| C | 325 | 36.9% | 593 | 34.1% |
| D | 417 | 33.1% | 375 | 34.9% |
| E | 191 | 27.7% | 393 | 23.9% |
| F | 373 | 5.9% | 341 | 7.0% |
六个院系合计,男性录取率 44.5%(2,691 人中 1,198 人),女性 30.4%(1,835 人中 557 人),差 14.1 个点。六个院系里有四个对女性更有利。约 51% 的男性申请了最容易进入的 A 和 B 两个院系,女性只有约 7%。按同样的院系构成标准化后,男性是 38.7%,女性是 43.0%。院系选择是混淆变量,而且在数据里。如果录取记录里没有院系这一列,它就会变成潜伏变量,总体差距也就无法解释。
怎么发现混淆变量或潜伏变量?
对任何一个醒目的对比,按顺序问三个问题。
- 每组里的人是怎么进去的,为什么? 如果是人们自己选的处理(看了视频、开了功能、发起了聊天),那在处理之前两组就已经不同。写下可能的原因:意向、规模、使用时长、设备、流量来源。
- 这个原因会不会同时影响结果? 如果会,它就是候选。意向影响购买,套餐影响留存,院系影响录取。
- 它在数据里吗? 在,就是混淆变量,按它拆分;不在,就是潜伏变量,也要把它叫出名字,因为名字告诉你该开始记录什么。
一个快速检验:按每个候选变量拆分对比,看差距是否变号或大幅缩小。如果是,合并后的数字说的是构成,不是处理的效果。
怀疑有一个之后怎么办?
用哪种办法取决于你掌握多少。
- 已测量: 分层(像上面的表那样在每组内比较),再标准化到共同构成后合并。把这个变量作为协变量放进回归,可以一次处理很多变量。
- 未测量但说得出名字: 开始记录,再重新跑一遍。对历史数据,可以从已有字段还原(套餐来自账单,使用时长来自首次出现日期)。
- 无法记录或根本未知: 随机分配。随机分配使每个混淆因素(无论测没测量)平均地平衡到各组,这就是对照实验成为判断因果标准途径的原因。真正做测试还有两条规则:事先决定样本量,不要因为数字好看就提前停。
要提防过度调整:不要按一个本身就是处理结果的变量拆分(例如当视频正是让人去第二页的原因时,按「看过第二页的用户」拆分)。那样可能引入偏差,而不是消除偏差。关于「是规律还是因果」的相关问题见相关与因果。
在 TapCub 里怎么检查混淆?
同样的检查适用于 TapCub 记录的任何维度。假设一个活动链接带来一个流量来源,问题是这个来源是否「转化更差」。TapCub 提供分组和拆分;它不做实验,也不分配谁看到什么,所以未测量因素的修正要在你的测试工具里完成,不在这里。
- 在 全端分析 › 经营分析 › 目标 里把购买定义成目标(与 网站统计 › 目标 是同一份数据)。转化率的分母是所选日期内的独立访客。选中目标那一行,可以看到它按来源、入口页、国家和设备的拆分。
- 先读每个来源的合并转化率并写下来。这就是别人会引用的那个总数字。
- 在 全端分析 › 行为分析 › 行为分析 里,把同一个度量先按来源、再按设备拆分(拆分最多三层),在每种设备内部比较各个来源。如果差距变号或明显缩小,说明设备构成是混淆变量。
- 对 TapCub 还没记录的因素,比如账户套餐,可以把它作为事件属性发送,或者用
tapcub.login识别已登录用户,这样下一份报表就能按它拆分。匿名访客没有用户档案,按用户属性做的分析覆盖不到他们。 - 写下你的结论,并把任何前后对比都当作观察性对比:TapCub 报告发生了什么,它不做随机分配。
常见问题
混淆变量和潜伏变量有什么区别?
两者都是与原因和结果相关的第三个变量。按常见的教材用法,混淆变量是已识别或已测量的,潜伏变量是没有测量的混淆因素,所以无法调整。也有资料把两者当同义词。
潜伏变量就是混淆因素吗?
不一定。许多教材把潜伏变量称为未测量的混淆因素;也有人互换使用。实际区别在于你能不能按它拆分数据:能,就是你要处理的混淆因素;不能,在开始记录之前它就是潜伏的。
混淆变量的例子有哪些?
演示视频样本里的访客类型:新访客大多看了视频、大多没购买,回访访客很少看视频、经常购买,所以合并结果(15.0% 对 25.6%)在每种访客类型内部反转(+2.0 和 +5.0 个点)。
潜伏变量的例子有哪些?
功能与留存样本里还没人记录时的账户套餐:Pro 用户既更常用这个功能,也留得更久,所以 27.3 个点的留存差距在固定套餐后缩小到 2.0 个点。
能消除混淆变量吗?
你不能把它从现实里消除,但可以让它失效:已测量就分层并标准化,作为协变量放进模型,或者随机分配使它平均地得到平衡。第四个办法是在各组之间匹配相似的个体。
它和辛普森悖论有什么关系?
辛普森悖论是极端情形:混淆变量强到足以让合并比较的符号反转。上面的伯克利和演示视频两个例子都是这样。如果合并和分组的比较结论不一致,只有在你确定分组变量本身不是处理的结果时,才应该相信分组的看法。
资料来源
- Dunn PK. Scientific Research and Methodology, section 6.3: Extraneous variables and variation in the response(2021):混淆变量和潜伏变量的定义。2026-11-20 核对。
- Bickel PJ, Hammel EA, O'Connell JW. Sex Bias in Graduate Admissions: Data from Berkeley,《Science》187(4175),1975:1973 年秋季总体录取数据与院系分析。2026-11-20 核对。
- R Core Team. UCBAdmissions 数据集文档:六个最大院系,4,526 名申请人;男性 2,691 人(录取 44.5%),女性 1,835 人(30.4%)。2026-11-20 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
