内容追踪是记录人们在页面加载之后做了什么。对一篇文章,要同时追踪三个信号:滚动深度、阅读时长和行动号召(CTA)点击。每个单独看都会误导,所以把它们连同触发条件和属性写进追踪方案,再按「到达 CTA 的访客」而不是按浏览量算点击率。下面 2,000 次浏览的算例里,结尾 CTA 按到达者算是 7.5%,中段 CTA 是 5.0%。
读完你会知道
- 滚动深度、阅读时长和 CTA 点击要一起追踪,单个都会误导,NN/g 的 79% 扫读结论就是例子
- 先写追踪方案:事件、触发、属性和负责人,同一个动作处处用同一个名字
- CTA 点击要除以到达按钮的访客:结尾 7.5%、中段 5.0%,按浏览算两者看起来却差不多
什么是内容追踪?
内容追踪是记录人们在页面加载之后对内容做了什么:滚动到多深、页面在他们面前停留多久、有没有点下一步。浏览量只说明页面被请求过。追踪补上了区分「读过」和「跳出」的三个信号:滚动深度、阅读时长和行动号召(CTA)点击。本文给出一份文章页的追踪方案示例、一个带数字的算例,以及读结果的规则。更完整的指标清单见内容表现指标。
哪三个信号重要,各自漏掉了什么?
每个信号回答不同的问题,单独看都可能误导:
| 信号 | 回答的问题 | 漏掉的东西 |
|---|---|---|
| 滚动深度 | 页面有多少内容到过屏幕? | 有没有人读。快速划到底和慢慢读,记录一样 |
| 阅读时长 | 页面在访客面前停了多久? | 他们有没有在看。留在前台的标签页会累加时间 |
| CTA 点击 | 他们有没有走下一步? | 没点的原因。只有看到按钮的人才可能点 |
两项公开的研究说明为什么一个信号不够。Nielsen Norman Group 1997 年的研究发现,79% 的测试用户总是扫读页面,只有 16% 逐字阅读。它 2018 年对 120 名参与者的眼动研究发现,人们约 57% 的浏览时间花在首屏,约 17% 在第二屏,前两屏占了 74% 的浏览时间。所以只看滚动深度,能说明的阅读情况比看上去少。
至少一款常用工具的默认设置也很粗。Google Analytics 4 的增强型衡量,只在访客第一次到达页面底部(垂直 90% 深度可见)时触发 scroll 事件,所以你看不到人们在中间哪里停下。
文章页的追踪方案示例长什么样?
追踪方案是一份你打算采集的事件清单,写明触发条件和属性,在有人动手写代码之前定好。下面是一份博客文章页的方案。
| 事件 | 触发条件 | 属性 | 来源 |
|---|---|---|---|
| 浏览量 | 页面加载或路由切换 | 网址、标题、来源页 | 自动采集 |
| 页面停留时长 | 访客离开、切换标签或关闭页面 | 时长(毫秒) | 自动采集,页面打开超过 1 秒才发送 |
| 滚动到达 | 访客滚动页面 | 到达深度、页面路径 | 自动采集里的滚动深度开关 |
cta_click | 点击被追踪的 CTA 按钮或链接 | cta_id、placement、article_slug | 自定义事件 |
| 外链点击 | 点击指向其他域名的链接 | 链接域名 | 自动采集 |
| 文件下载 | 点击指向文档或压缩包的链接 | 文件路径 | 自动采集 |
newsletter_signup | 订阅表单提交成功 | placement、article_slug | 自定义事件 |
三条命名规则让方案可用。自定义事件用 snake_case。同一个动作无论发生在哪里都用同一个名字,事件有了数据就不要改名。属性只留你要拆分用的:placement 和 article_slug 就足以回答「哪个 CTA、在哪篇文章上」。访客输入的原始文字不要放进属性。
| 事件 | 触发 | 属性 |
|---|---|---|
| 浏览量 | 页面加载或路由切换 | 网址、标题、来源页 |
| 页面停留时长 | 访客离开或标签页隐藏 | 时长(毫秒) |
| 滚动到达 | 访客滚动页面 | 到达深度、页面路径 |
| cta_click | 点击被追踪的 CTA | cta_id、placement、article_slug |
| 外链点击 / 文件下载 | 指向其他域名或文件的链接 | 链接域名或文件路径 |
| newsletter_signup | 订阅表单提交成功 | placement、article_slug |
一篇文章页的追踪方案示例;自定义事件用 snake_case。
算例:一篇文章,2,000 次浏览
示例数据:一篇 1,800 词的文章,一个月被浏览 2,000 次。滚动区间表示停在该区间的浏览占比。
| 滚动区间 | 停在该区间的浏览数 | 占浏览比例 | 停留时长中位数 |
|---|---|---|---|
| 不足 25% | 480 | 24.0% | 12 秒 |
| 25% 到不足 50% | 480 | 24.0% | 41 秒 |
| 50% 到不足 75% | 400 | 20.0% | 118 秒 |
| 75% 及以上 | 640 | 32.0% | 310 秒 |
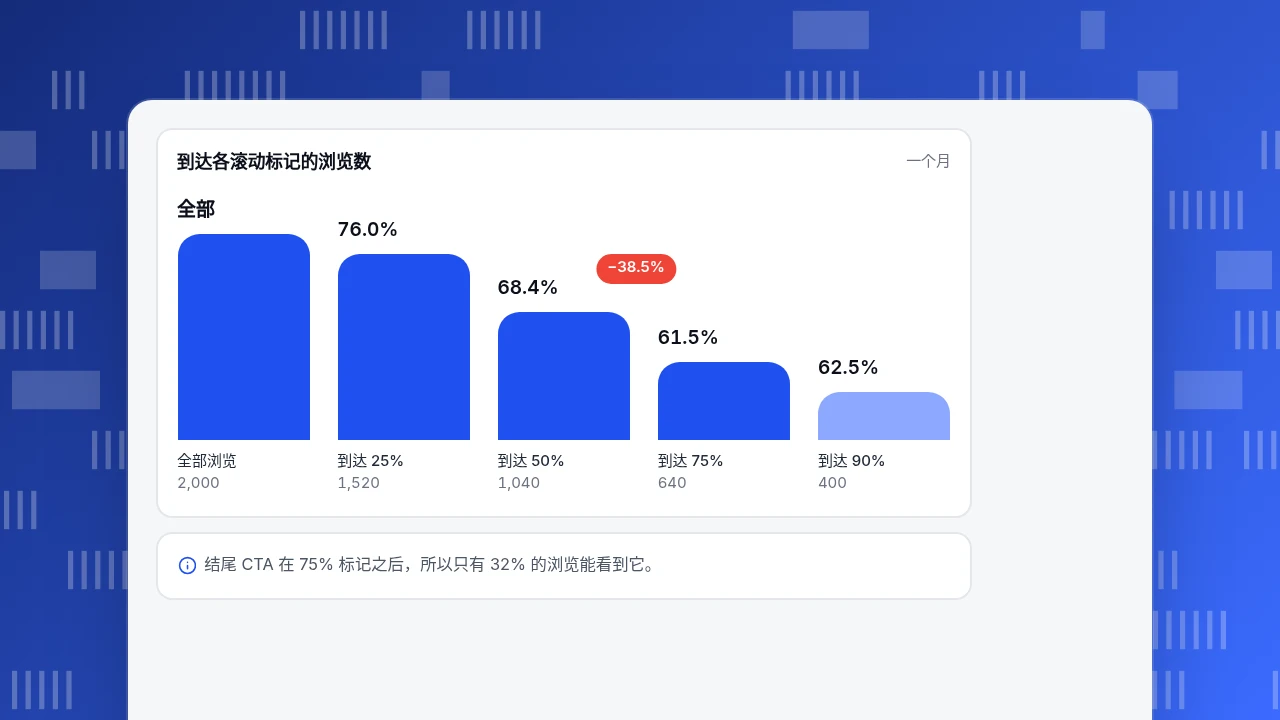
因此到达各标记位的浏览数是:25% 处 1,520(76.0%),50% 处 1,040(52.0%),75% 处 640(32.0%),90% 处 400(20.0%)。
再看阅读时长。按每分钟 250 词的编辑规划速度(示例里的假设,不是实测事实),1,800 词需要 432 秒。滚动到 75% 及以上的读者停留时长中位数是 310 秒,占 72%。停在 50% 到 75% 之间的是 118 秒,占 27%。前一组像是在读,后一组像是在判断这个页面有没有用。
到达各滚动标记的浏览数
一个月全部浏览
2,000
到达 25%
1,520
到达 50%
1,040
到达 75%
640
到达 90%
400
怎么读 CTA 点击率?
同样的点击,分母不同,点击率就不同。文章里有两个 CTA:一个在 50% 标记之后,一个在 75% 标记之后。
| CTA | 点击数 | 可能看到它的浏览数 | 按浏览计的点击率 | 按到达者计的点击率 |
|---|---|---|---|---|
| 中段 | 52 | 1,040 | 2.6% | 5.0% |
| 结尾 | 48 | 640 | 2.4% | 7.5% |
| 两者合计 | 100 | 2,000 | 5.0% | 不适用 |
按浏览算,两者差不多(2.6% 对 2.4%)。按走到能看到它的人算,结尾 CTA 高出 50%(7.5% 对 5.0%),但中段的点击更多(52 对 48),因为到达的人更多。有用的结论是:结尾 CTA 对它的受众来说优惠更强,中段 CTA 的受众更大。
把「到达该深度」当作「看到按钮」的上限。同一个页面在手机上可能很长、在桌面上很短,所以尽量在同一种设备内比较位置。
滚动标记放在哪里?
四分位标记(25、50、75、90)是初看的合理默认。之后,把一个标记挪到内容发生变化的地方:答案段落的结尾、第一个 CTA、对比表的开头。「75%」在 600 词的短文和 4,000 词的长指南上意义不同,但「到达对比表」在两者上意义相同。标记要少,四五个就能画出曲线,十个只会得到一堆几乎一样的数字。在 TapCub 里,深度区间就是「滚动到达」页签上的那些;「到达对比表」这类基于内容的标记,需要你自己的代码发一个自定义事件。
拿到数字之后怎么办?
把判断规则写进方案本身,让下一次复盘有动作可做:
| 看到 | 可能说明 | 怎么做 |
|---|---|---|
| 不足 35% 的人到达第一个 CTA | 这个页面上 CTA 位置太低 | 上移,或缩短铺垫 |
| 到达率高,按到达者计的点击率低 | 人到了,优惠或文案不行 | 改 CTA 文案或优惠,不要改位置 |
| 滚得深,停得短 | 扫读 | 在顶部加小标题和摘要 |
| 停得久,滚得少 | 标签页没关或读得慢 | 按设备检查,别算作互动 |
| 到达率在某个标记位陡降 | 那一段太密或看不懂 | 拆开或重写那一段 |
每月复盘一次,每篇文章至少有几百次浏览。2,000 次浏览里 52 次点击,得到的点击率可以比较;只有 50 次浏览时,多一次点击就会让点击率变化两个百分点。
在 TapCub 里怎么设置
沿用上面的文章方案:
- 规划事件。 在全端分析 › 数据管理 › 埋点方案里,为
cta_click和newsletter_signup加行,填写触发时机、属性(名称、类型、是否必填)、负责人和状态。埋点方案记录的是你打算采集的事件,包括还没发的。 - 打开滚动深度。 浏览量和页面停留时长由脚本默认采集。滚动深度默认关闭,要在网站统计 › 配置 › SDK 代码的自动采集里打开,自动采集需要 Pro 或更高套餐。
- 发送 CTA 事件。 在按钮的点击处理里调用
tapcub.track('cta_click', { cta_id: 'end-of-post', placement: 'end', article_slug: 'content-tracking' })。它会出现在网站统计 › 事件和全端分析 › 行为分析 › 事件分析里。 - 验证。 打开这条方案,打开实时验证(近 24 小时),能看到事件到达了多少、必填属性是否完整。
- 读结果。 全端分析 › 行为分析 › 热力图里有「滚动到达」页签:每一行是到达该深度或更深的访问占比,页面列表还给出离开时平均最大滚动深度。网站统计 › 页面给出平均停留时长。要看按到达者计的 CTA 点击率,就在行为分析里建一个从文章页到
cta_click的漏斗。
有两条限制要说明。停留时长在访客离开或标签页隐藏时发送,所以留在前台的标签页仍会累加时间。另外,TapCub 衡量的是访问本身,不改内容,也不对 CTA 文案做 A/B 测试。
内容追踪常见错误有哪些?
- 只统计浏览量。 它分不出读过和跳出。
- 一个信号就下结论。 单看滚动深度或停留时长都有歧义,上面的表已经说明。
- 给事件改名。 新名字意味着从空白历史重新开始。
- 用全部浏览量做分母。 折叠线以下的 CTA 受众更小,应当用到达者做分母。
- 什么都追踪。 十个没有对应决策的事件,只会得到一块没人看的看板。
常见问题
博客文章上应该追踪什么?
几个标记位的滚动深度、页面停留时长、带位置属性的 CTA 点击,以及你往外链的外链点击和下载。再加一个注册或目标事件,才能看到点击之后发生了什么。
怎么追踪滚动深度?
记录访客越过设定深度的时刻,例如 25、50、75 和 90%。有些工具的默认设置只记录一个深度,所以要确认你的工具采集哪些标记位。
页面停留时长能衡量阅读吗?
要结合上下文。它是在页面打开且可见时计的,所以闲置的标签页也会累加。把它和滚动深度配合,并和文章的预期阅读时长对比,就像算例里那样。
要多少浏览量,这些数字才有意义?
每次复盘,每篇文章至少几百次浏览。低于这个量,一次点击就会让点击率摆动一个百分点以上。
内容追踪和内容表现指标有什么区别?
追踪是采集,也就是事件和属性。表现指标是用它们算出来的东西,例如到达率和按到达者计的点击率。
资料来源
- Google Analytics 帮助:增强型衡量事件(scroll 在垂直 90% 深度时触发),2026-11-20 核对
- Nielsen Norman Group:滚动与注意力(2018,120 名参与者),2026-11-20 核对
- Nielsen Norman Group:用户如何阅读网页(1997),2026-11-20 核对
- Google Analytics 帮助:用户参与时长,2026-11-20 核对
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
