单页应用的每个视图都是在浏览器里生成的,所以网址、标题、状态码和页面浏览都要专门处理。本文列出七项要求,讲清 hash 和 history 路由、软 404,并走一遍一次改造:收录页面从 15 个增加到 271 个,而每次会话页面数的跳涨另有原因:终于量对了。
读完你会知道
- 用 history 路由给每个公开视图一个真实网址
- 第一次响应的 HTML 里就带上内容、标题和 canonical
- 返回真正的 404;客户端的「找不到」页面就是软 404
- 给无限滚动列表分页,让每一项都有可抓取的网址
- 每次路由切换记一次页面浏览,并标注改造上线
单页应用的 SEO 有什么不同?
单页应用(Single-Page Application,SPA)只加载一个 HTML 文档,之后用户每次切换页面,都由 JavaScript 在浏览器里替换内容,而不是每次点击都向服务器请求新页面。React、Vue、Angular、Svelte 的应用通常就是这样做的。SPA SEO 是一套做法,让这些在客户端「切出来的页面」在爬虫和统计眼里都像真正的页面:有自己的网址、自己的 HTML 内容和元数据、自己的状态码,以及自己的页面浏览。
渲染和抓取的一般问题见 JavaScript SEO。本文集中讲 SPA 特有的问题:路由、每个路由的元数据、状态码、无限列表和统计。
SPA SEO 的七项要求
| # | 要求 | 默认 SPA 里会出什么问题 | 怎么改 |
|---|---|---|---|
| 1 | 每个视图有真实网址 | 视图共用一个网址,或用 /#/ 片段 | 用 History API 路由(/pricing,不是 /#/pricing) |
| 2 | 第一次响应的 HTML 里就有内容 | 只有 <div id="root"></div> | 公开路由用 SSR、静态生成或预渲染 |
| 3 | 每个路由有独立的标题、描述、canonical | 所有路由都沿用 index.html 的标题 | 在服务端按路由设置 head(Next.js metadata、Nuxt useHead、Angular SSR 配合 Meta/Title) |
| 4 | 状态码正确 | 不存在的路由显示「找不到」,状态码却是 200 | 未知路径由服务器返回 404,迁移的返回 301 |
| 5 | 链接可以被抓取 | 导航靠 onClick 处理函数 | 用 <a href>(路由的 Link 组件会渲染成它) |
| 6 | 列表要分页,不只是无限滚动 | 第一批之后的内容永远没有网址 | 分页网址(?page=2)并从列表链接过去 |
| 7 | 每次路由切换记一次页面浏览 | 统计里一次访问只有一个页面浏览 | 把 History API 的变化记为页面浏览 |
| 要求 | 怎么改 |
|---|---|
| 每个视图有真实网址 | History API 路由 |
| 第一次响应就有内容 | SSR、SSG 或预渲染 |
| 独立的 head 标签 | 服务端按路由输出元数据 |
| 状态码正确 | 服务端 404 / 301 |
| 链接可抓取 | 元素 |
| 列表分页 | ?page=N 网址 |
| 每个路由一次浏览 | 监听 History API 变化 |
在搜索引擎看来,hash 路由(/#/)都是同一个网址。
路由:history 模式和 hash 模式
hash 路由(example.com/#/pricing)不用配置服务器就能跑,所以很多 SPA 一开始都用它。可在搜索引擎看来,# 后面的部分只是同一个文档的片段,Google 会把 /#/pricing 和 /#/features 当成同一个网址。要用 history 模式(example.com/pricing),并配置服务器对每个路径返回正确的文档和状态码。hash 路由只留给永远不需要被收录的视图(内部工具、登录后的看板)。
状态码和软 404
纯客户端的 SPA 对每个路径都返回同一个 index.html 和 HTTP 200,包括 /products/does-not-exist。应用随后显示「找不到」,但爬虫看到的是一个内容很少的 200 页面,Google 会把它报告为软 404,还会浪费抓取预算。
修复方法,按优先顺序:
- 有 SSR 时,数据查询失败就由服务器返回
404(彻底下架的商品返回410)。 - 没有 SSR 时,在服务端保留一份合法路由规则的白名单,其他路径一律返回 404。
- 实在不行,在「找不到」视图上加
<meta name="robots" content="noindex">,Google 渲染时会遵守,但对其他爬虫解决不了状态码问题。
SPA 里的跳转经常用 JavaScript 做(router.push)。长期有效的跳转要换成服务端的 301,并避免重定向链。
计算示例:一次 SPA 改造前后
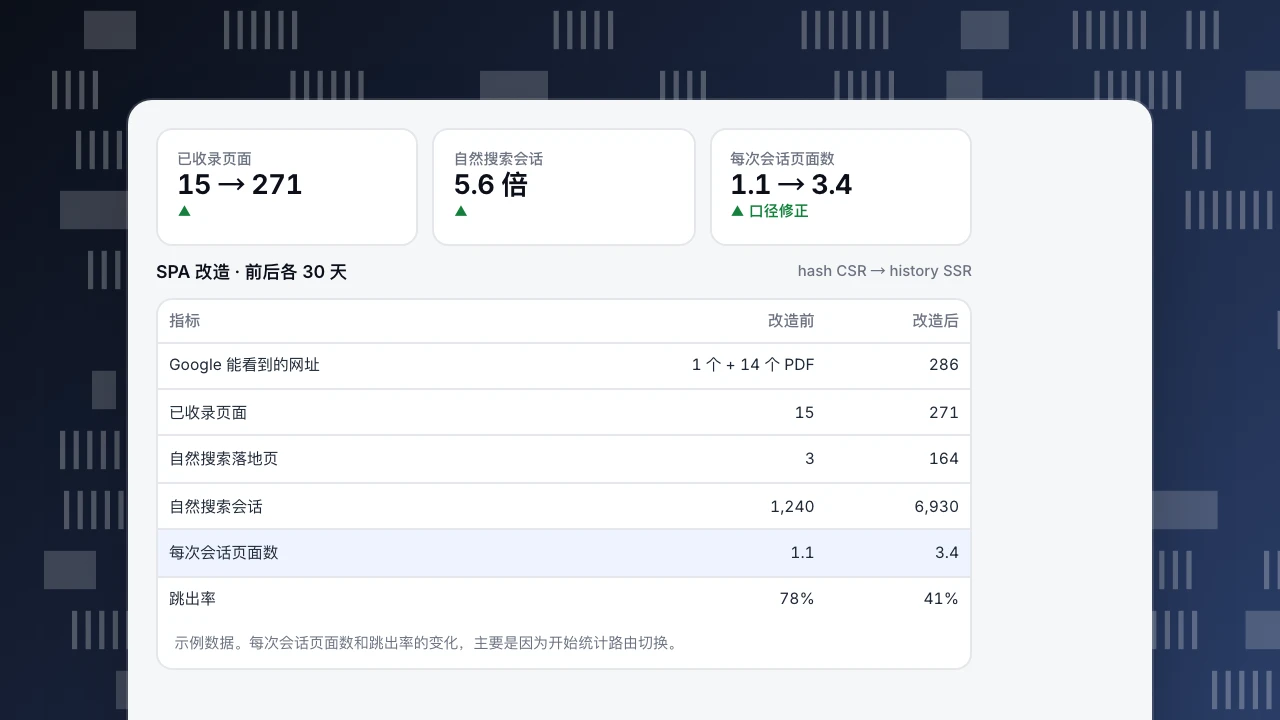
某 SaaS 的官网和帮助中心是同一个客户端渲染、hash 路由的 Vue 应用(示例数据,前后各 30 天):
| 指标 | 改造前(hash 路由、CSR) | 改造后(history 路由、SSR) |
|---|---|---|
| Google 能看到的网址 | 1 个(/)加 14 个被链接的 PDF | 286 个 |
| 已收录页面 | 15 | 271 |
| 未知路径返回 200 | 全部 | 0(改为 404) |
| 有流量的自然搜索落地页 | 3 | 164 |
| 自然搜索会话 | 1,240 | 6,930 |
| 记录到的每次会话页面数 | 1.1 | 3.4 |
| 记录到的跳出率 | 78% | 41% |
这里变了两件不同的事。SEO 上的改动产生了能被收录的网址,自然流量增长到 5.6 倍。统计上的改动(路由切换时记页面浏览)修正了衡量:以前一个访客读了五篇帮助文章,被记成一个页面浏览和一次跳出。每次会话页面数和跳出率的变化主要是因为量对了,而不是行为变了。改造时要在图表上标注发布时间,免得有人把这次跳变当成真实的改善。
已收录页面
15 → 271
▲
自然搜索会话
5.6 倍
▲
每次会话页面数
1.1 → 3.4
▲ 口径修正
SPA 改造 · 前后各 30 天
hash CSR → history SSR| 指标 | 改造前 | 改造后 |
|---|---|---|
| Google 能看到的网址 | 1 个 + 14 个 PDF | 286 |
| 已收录页面 | 15 | 271 |
| 自然搜索落地页 | 3 | 164 |
| 自然搜索会话 | 1,240 | 6,930 |
| 每次会话页面数 | 1.1 | 3.4 |
| 跳出率 | 78% | 41% |
示例数据。每次会话页面数和跳出率的变化,主要是因为开始统计路由切换。
单页应用的统计
- 每次路由切换记一次页面浏览,在路由解析完成之后带上页面标题和完整路径,而不是之前。
- 不要重复计数。 有些路由器一次导航会触发好几个 history 事件,连续相同的网址要去重。
- 保留来源链。 每个虚拟页面浏览的来源应该是上一个路由。
- 注意停留时长。 SPA 里标签页会在很多视图间一直开着,时长要在路由切换时按路由拆分。
- 按路由衡量真实用户性能。 软导航不会触发新的页面加载;首次加载的 LCP 只适用于落地路由,后续路由取决于 INP 和数据请求。
SPA SEO 检查清单
- [ ] 公开路由用 history 模式,不用
#片段 - [ ] 每个公开路由的原始 HTML 里有主要内容、标题、描述和 canonical
- [ ] 路由链接渲染成
<a href> - [ ] 未知路径返回 404;删除的内容返回 404 或 410;迁移的内容返回 301
- [ ] 站点地图列出所有可收录的路由,不含登录后的路由
- [ ] 无限滚动列表有分页网址
- [ ] robots.txt 没有屏蔽渲染所需的 JS、CSS 或接口路径
- [ ] 统计在每次路由切换时记一次、且只记一次页面浏览
在 TapCub 里统计 SPA
TapCub 的脚本在文档就绪时发送第一个页面浏览,并监听之后用 History API 做的网址变化,所以 React Router、Vue Router、Next.js 和 Nuxt 的路由不用额外代码就能统计;连续相同的网址不会重复发送。hash 路由要在脚本标签上加 data-hash="true"。想自己控制时机,就设置 data-auto-track="false",在每次路由解析完成后调用 tapcub.pageview()。见在单页应用上安装,以及 React、Vue、Next.js、Nuxt 的安装指南。路由改造上线后,用图表标注记一笔。
参考资料
- Google Search Central. Understand JavaScript SEO basics (History API, soft 404s in SPAs).
- MDN Web Docs. History API.
- Google Search Central. Fix lazy-loaded content.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。