CRO 分析就是用你的行为数据找出访客在哪里流失、形成一个原因,并判断它值不值得测试。按设备拆分漏斗找到步骤和人群,用点击、回放、错误和速度去解释,再写出带证据、人群和数字的假设。
读完你会知道
- 假设的质量取决于挂上的证据:一个步骤、一群人和一个你能指出的原因
- 示例中移动端转化率 1.4%,桌面端 4.2%;仅购物车到结算一步追平桌面端就值 +40 个订单
- 按出结论的时间给测试排序:同样 +25% 的提升,商品页要 0.7 个月,结算要 4.1 个月
什么是 CRO 分析,它到哪里结束?
CRO 分析是转化率优化里“动手之前”的那一段:用你自己的行为数据,找出访客在哪里流失,形成一个原因,再判断这个原因值不值得做一次实验。它在实验开始的地方结束。转化率优化指南讲整个体系,CRO 审计讲一次性的检查;本文讲中间这几步:从数据到假设。
整个流程有五步,每一步需要不同类型的数据:
| 步骤 | 问题 | 需要的数据 |
|---|---|---|
| 1. 定义 | 什么算转化,分母是谁? | 一个转化事件和一个分母 |
| 2. 定位 | 访客在哪里流失,是哪些人? | 按步骤的漏斗,再按设备和来源拆分 |
| 3. 解释 | 为什么在那里流失? | 点击、滚动、回放、表单事件、错误、速度 |
| 4. 提假设 | 做什么改动能解决这个原因? | 一条和证据挂钩的书面假设 |
| 5. 估量 | 以我们的流量能测出效果吗? | 基线转化率和样本量 |
这个顺序的意义在于:假设的质量,取决于你能给它挂上多少证据。“把按钮做大一点”是一个点子;“移动端访客到了购物车,但 60% 没有开始结算,而且他们点的是运费文字,不是按钮”才是假设。即使精心设计,多数点子也会失败:Bing 的一个团队报告说,他们测试的点子里,能推动预期指标的不到三分之一。证据和估量,就是把有限的测试名额花在最可能赢的点子上的办法。
分析之前,哪些数字要先定下来?
三个决定会影响之后的每个数字,所以先写下来:
- 一个转化事件。 购买、开始试用或提交线索。选业务真正靠它赚钱的那个。
- 一个分母。 会话、访客还是人。同样的流量,按访客算的转化率比按会话算的高,因为回访的人只算一次。
- 真人过滤。 爬虫和 AI 机器人会访问页面但从不转化。如果它们在分母里,你的转化率会比实际低,页面看起来比实际差。
整个分析里保持这三项不变。如果中途改了分母,前后对比衡量的就是口径,而不是网站。
怎么找到漏点?按设备拆分漏斗
全站漏斗会藏起最有用的事实:漏点通常只属于某一群人。把同一个漏斗按设备拆开,逐步对比。
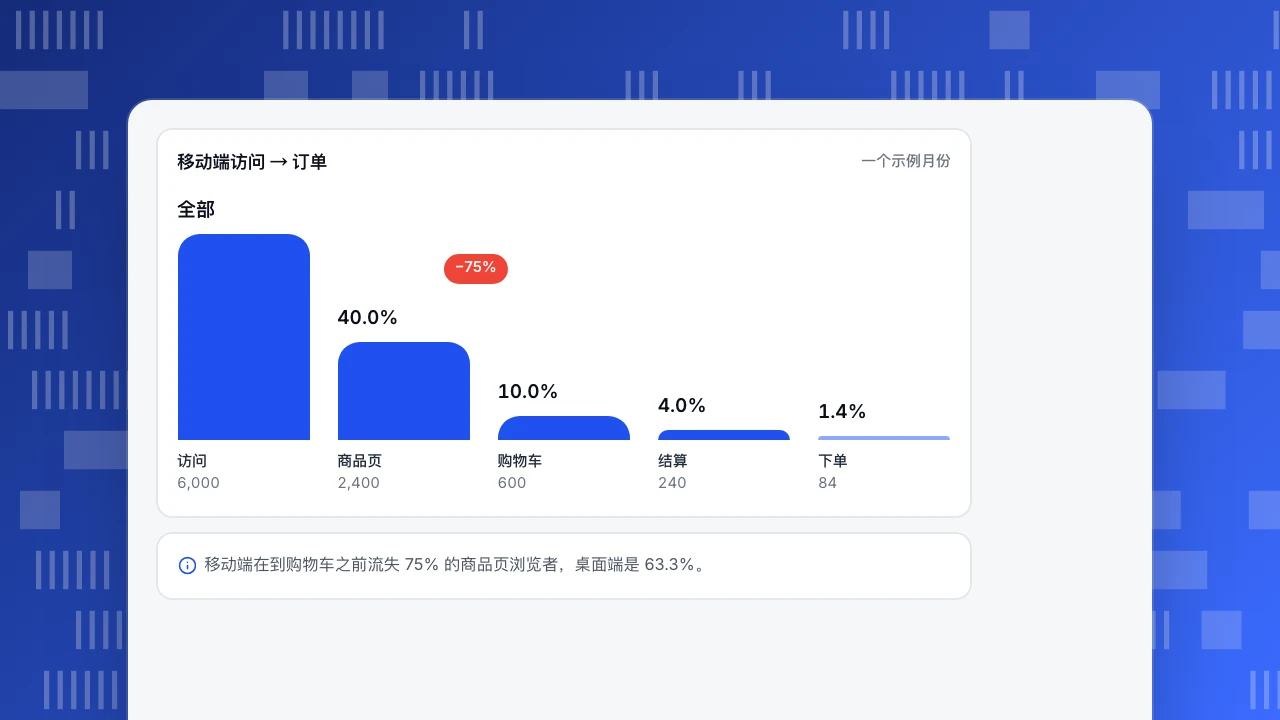
示例数据:一个月 10,000 次访问,其中移动端 6,000,桌面端 4,000。
| 步骤 | 移动端 | 相对上一步 | 桌面端 | 相对上一步 |
|---|---|---|---|---|
| 访问 | 6,000 | — | 4,000 | — |
| 商品页 | 2,400 | 40.0% | 1,800 | 45.0% |
| 购物车 | 600 | 25.0% | 660 | 36.7% |
| 结算 | 240 | 40.0% | 390 | 59.1% |
| 下单 | 84 | 35.0% | 168 | 43.1% |
| 整体转化 | 1.4% | 4.2% |
整体上,10,000 次访问带来 252 个订单,转化率 2.5%。这个数字掩盖了三倍的差距:移动端 1.4%,桌面端 4.2%。移动端占 60% 的流量,却只带来三分之一的订单(252 个里的 84 个)。
要选先改哪一步,就问:如果移动端在这一步追平桌面端、其他步骤不变,能多出多少订单:
- 商品页到购物车(25.0% → 36.7%): 6,000 × 40% × 36.7% × 40% × 35% = 123.2 个订单,+39.2。
- 购物车到结算(40.0% → 59.1%): 6,000 × 40% × 25% × 59.1% × 35% = 124.1 个订单,+40.1。
- 结算到下单(35.0% → 43.1%): 6,000 × 40% × 25% × 40% × 43.1% = 103.4 个订单,+19.4。
前两步价值差不多,第三步只有一半。光靠漏斗的数据说不清为什么,这就是下一步。
移动端访问 → 订单
一个示例月份访问
6,000
商品页
2,400
购物车
600
结算
240
下单
84
哪些数据能解释人为什么离开?
漏斗告诉你在哪里,别的数据告诉你为什么。选数据前,先把问题和证据对上:
| 如果漏斗显示…… | 去看 | 什么能确认原因 |
|---|---|---|
| 某一页损失很大 | 该页的点击图和滚动图 | 点击落在不是链接的文字上;多数访客根本没滚动到按钮 |
| 有人狂点或重复点按 | 狂点数据,再看这些会话的回放 | 按钮看起来可点却没反应,或小屏幕上被一层东西盖住 |
| 表单那一步损失 | 表单提交数和该步停留时间 | 开始的多、提交的少,在某一步停留很久 |
| 刚付款或提交就掉了 | 这些页面的错误报告 | 同样的页面和设备上错误激增 |
| 移动端远低于桌面端 | 移动端页面速度 | 第 75 百分位的最大内容绘制超过 2.5 秒、交互到下一次绘制超过 200 毫秒,或布局偏移超过 0.1 |
| 人们停下来问问题 | 该页的在线客服或客服咨询 | 同一个问题反复出现(发货时间、退货、价格) |
速度这一行用的是 Google 的核心网页指标阈值:页面要合格,最大内容绘制要在 2.5 秒内,交互到下一次绘制不超过 200 毫秒,累计布局偏移不超过 0.1,每项都取页面加载的第 75 百分位,并按移动端和桌面端分开看。只有移动端掉、而且移动端指标不合格,就应该先怀疑速度,再怀疑设计。
怎么把数据变成假设?
每个假设用一句话写成四个部分:
因为[证据],我们相信[改动]会[推动这个指标]对[这一群人]。我们会在[结果和时间窗口]得知结果。
用示例来说,假设热力图显示移动端访客在商品页上点的是配送文字,回放里他们又往上滚动去找送达日期。假设就写成:
因为到达购物车的移动端商品页会话里,有 61% 先点了配送文字(示例),我们相信把送达日期放在价格旁边,会把移动端访客的商品页到购物车转化率从 25.0% 提高到 31.3%。我们会在每个版本累计 810 位访客后得知结果。
重要的是你能指出的证据、单一的人群和要核对的数字。没有人群或数字的假设无法被证伪,也就教不会你任何东西。把假设和结果记成日志,免得重测已经失败的点子。
这个点子值得用你的流量去测吗?
测试需要足够的人,才能分清真实变化和噪声。对转化率来说,常用的双侧计算(显著性 5%、检验效能 80%)是:
每个版本所需人数 n = (1.96 + 0.84)² × [p₁(1 − p₁)+ p₂(1 − p₂)] ÷ (p₂ − p₁)²
示例数据:移动端每一步都以相对提升 +25% 为目标,按 50/50 分流。
| 步骤 | 基线 → 目标 | 每个版本所需人数 | 该步骤每月人数 | 出结论需要几个月 | 赢了多出的订单 |
|---|---|---|---|---|---|
| 商品页到购物车 | 25.0% → 31.3% | 808 | 2,400 | 0.7 | +21 |
| 购物车到结算 | 40.0% → 50.0% | 385 | 600 | 1.3 | +21 |
| 结算到下单 | 35.0% → 43.8% | 486 | 240 | 4.1 | +21 |
如果 25% 的提升是真的,三步都会多出 21 个订单,因为任何一步提升 25%,最终的 84 个订单都会乘以 1.25。它们的区别在于多久能知道结果。商品页的测试大约三周就有结论;结算的测试需要四个月的移动端流量。所以先测商品页,接着处理购物车这一步,结算则通过修复明显的问题(错误、速度)来解决,而不是靠实验。如果出结论的时间比你愿意等的时间长,要么瞄准更大的改动,要么跳过测试直接修复。
| 步骤 | 基线 → 目标 | 每个版本所需人数 | 出结论需要几个月 |
|---|---|---|---|
| 商品页到购物车 | 25.0% → 31.3% | 808 | 0.7 |
| 购物车到结算 | 40.0% → 50.0% | 385 | 1.3 |
| 结算到下单 | 35.0% → 43.8% | 486 | 4.1 |
示例数据:移动端流量,相对提升 +25%,显著性 5%,检验效能 80%,50/50 分流。
怎么确认改动有效?
实验在你的测试工具里跑,结果也在那里读;分析工具用来看它周围的护栏指标。
- 按计划的样本量看主指标。 不要因为第 4 天曲线好看就提前停;偷看就停会抬高“假赢”的概率。
- 看护栏指标。 你改动那一步的下一步、客单价、退款或投诉率。如果商品页到购物车上升,后面几步却下降,整体可能是负的。
- 看同一个人群。 假设针对的是移动端访客,就要评判移动端,而不是全站总数,因为全站总数会被没动的 40% 流量稀释。
- 标记上线日期。 在图表上标注这个日期,让之后的读者知道改了什么、什么时候改的,并且对比前后相同的星期几,因为星期分布会影响转化。
在 TapCub 里怎么跑这套流程?
还是上面的移动端数字。TapCub 衡量漏斗和背后的行为;它不做 A/B 测试,也不分流,所以实验本身在你自己的测试工具或发布流程里跑。
- 建漏斗。 在 全端分析 › 行为分析 › 行为分析 建一个从商品页浏览,经购物车、结算到下单事件的漏斗。每一步显示人数、相对上一步的比率、流失和距上一步的中位耗时,并标出最大的流失。按设备拆分,就能重现上面的表。
- 打开最大流失背后的页面。 在 全端分析 › 行为分析 › 热力图 选页面和设备。点击、狂点、滚动到达和元素几个页签,显示人们点在哪里、在哪里重复点、滚动到多深。热力图需要开启全埋点,而全埋点需要 Pro 套餐。
- 看几个会话。 会话回放默认关闭;打开之后,在 全端分析 › 行为分析 › 会话回放 打开流失人群的会话。
- 查错误和速度。 监测 › 错误 列出错误分组和受影响会话,监测 › 性能 显示真实用户的核心网页指标,可以确认或排除技术原因。
- 标记改动并对比。 在 配置 › 日期标注 里把这次发布标在图表上,再到 全端分析 › 行为分析 › 事件分析 对比前后相同的星期几,它的对比选项可以按星期对齐(漏斗本身没有对比期)。如果开了聊天组件,去读从这个页面发起的对话,看有没有反复出现的问题。
FAQ
什么是 CRO 分析?
CRO 分析就是用行为数据找出访客在哪里没有转化、形成一个原因,并决定哪个假设值得测试。它涵盖漏斗、按设备和来源拆分、点击、滚动、回放、表单、错误和速度,在实验开始的地方结束。
CRO 最该看哪些分析报表?
先看按设备和来源拆分的漏斗,找到步骤和人群,再用热力图、回放、表单事件、错误和页面速度去解释。其他报表只有在会改变你选哪个假设时才有意义。
怎么根据数据写 CRO 假设?
写一句话:因为这个证据,我们相信这个改动会推动这个指标,对这群人,并在这个结果上得知。证据、人群和数字,是让假设可测试的部分。
做 CRO 测试需要多少流量?
取决于基线和你想检测的提升幅度。显著性 5%、检验效能 80% 时,把 40% 提到 50% 每个版本约需 385 人,把 25% 提到 31.3% 约需 808 人。开始前先算出来。
每个点子都要测吗?
不用。只测那些出结论的时间在你耐心范围内、赢了又有意义的点子。对明显的故障,比如错误或很慢的移动端页面,直接修复,之后再监控漏斗。
资料来源
- web.dev,Web Vitals——核心网页指标阈值和第 75 百分位规则。核对于 2026-11-21。
- Bing Blogs,Large Scale Experimentation at Bing(2013)——不到三分之一的点子能推动预期指标。核对于 2026-11-21。
- NIST/SEMATECH e-Handbook of Statistical Methods,7.3.3 两个过程的不合格品比例是否相同——样本量公式背后的两比例检验。核对于 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
