混杂变量是第三个因素:它在你比较的两组之间不同,又会影响结果,所以让一个差距看起来像因果。处理只有一步:按怀疑的因素(渠道、设备、新老访客、套餐)把结果拆开,看差距在每一片里还在不在。下面是三个能复算的例子,以及随后的处理方法。
读完你会知道
- 相信任何差距之前,先按常见嫌疑拆开:渠道、设备、新老访客、套餐、国家、注册时间
- 混杂变量可能缩小、抹掉甚至反转效果,所以要比较两组的构成,不只比较比率
- 只有随机化能覆盖没测量的混杂变量;否则就写明调整了什么,不要说证明了因果
一个变量要满足什么条件,才算混杂变量?
比较两组时,一个变量同时满足三条,就是混杂变量:
- 两组在它上面不一样。 用了某功能的人多半是付费套餐,没用的人多半是免费套餐。
- 它自己就会影响结果。 不管有没有用这个功能,付费用户的留存本来就更高。
- 它不是原因和结果之间的一环。 套餐是在用功能之前选的,不是功能带来的。
三条都成立时,你看到的差距里有一部分属于第三个变量,而比较把它记在了你正在看的那个因素头上。统计上这叫「可交换性不成立」:就算没有这个功能,两组人的表现也会不同。正式的论述见 Greenland、Robins 和 Pearl(1999);通俗定义已经在混杂变量里写过,这篇把篇幅放在你能自己复算的例子上。
实际检验很简单:拿到差距后,按怀疑的变量拆开,看差距在每一片里还在不在。 下面所有内容都是把这一步重复几次。
例 1:用了某功能的人留存更高
示例数据:10,000 名新用户,其中 2,000 人在注册后一周内用了新上线的「保存视图」功能。第 30 天留存如下:
| 分组 | 用户数 | 第 30 天仍留存 | 留存率 |
|---|---|---|---|
| 用了该功能 | 2,000 | 1,040 | 52% |
| 没用 | 8,000 | 1,920 | 24% |
差距 28 个百分点,直觉是功能让留存翻了一倍。现在按套餐拆开,这是最明显的嫌疑:付费用户既更愿意试功能,也本来就更容易留下来。
| 套餐 | 分组 | 用户数 | 留存人数 | 留存率 |
|---|---|---|---|---|
| 付费 | 用了该功能 | 1,600 | 960 | 60% |
| 付费 | 没用 | 800 | 480 | 60% |
| 免费 | 用了该功能 | 400 | 80 | 20% |
| 免费 | 没用 | 7,200 | 1,440 | 20% |
在每个套餐内部,差距是零。付费用户留存 60%,免费用户 20%,用不用功能都一样。28 个点的差距全部来自人群构成:用功能的人里 80% 是付费用户,没用的人里只有 10%(8,000 人里的 800 人)。这正好对上上面的三条:变量在两组间不同、自己决定结果、而且发生在前。
这是为了方便心算特意取的极端情形。真实数据很少塌成零,更常见的是差距缩小到原来的一小部分。要养成的习惯是同一个:没看到拆开后的数字,就不要报原始差距。
例 2:来自邮件的访客转化更高
示例数据:一个月 20,000 次会话,其中 2,000 次来自一次邮件活动。原始数字:
| 来源 | 会话 | 订单 | 转化率 |
|---|---|---|---|
| 邮件 | 2,000 | 154 | 7.7% |
| 其他全部 | 18,000 | 540 | 3.0% |
邮件的转化率是其他来源的 2.57 倍。挪预算之前,先按新访客和回访访客拆开。邮件名单里本来就有买过的人,所以主要是回访访客。
| 访客类型 | 来源 | 会话 | 订单 | 转化率 |
|---|---|---|---|---|
| 回访 | 邮件 | 1,600 | 144 | 9.0% |
| 回访 | 其他全部 | 3,000 | 240 | 8.0% |
| 新访客 | 邮件 | 400 | 10 | 2.5% |
| 新访客 | 其他全部 | 15,000 | 300 | 2.0% |
邮件在两片里依然领先,但回访访客里领先 1 个点,新访客里领先 0.5 个点,离 4.7 个点差得很远。想用一个数字说清楚,可以问:如果非邮件组的访客构成和邮件一样(80% 回访、20% 新访客),它的转化率会是多少?0.8 × 8.0% + 0.2 × 2.0% = 6.8%。拿这个当基线,邮件的 7.7% 只高出 0.9 个点,而不是 4.7 个点。这叫直接标准化,是比较构成不同的两组时最省事的办法。
这次活动并不是没用。它的实际作用大约只有原始比较显示的五分之一,其余来自收邮件的人本身。
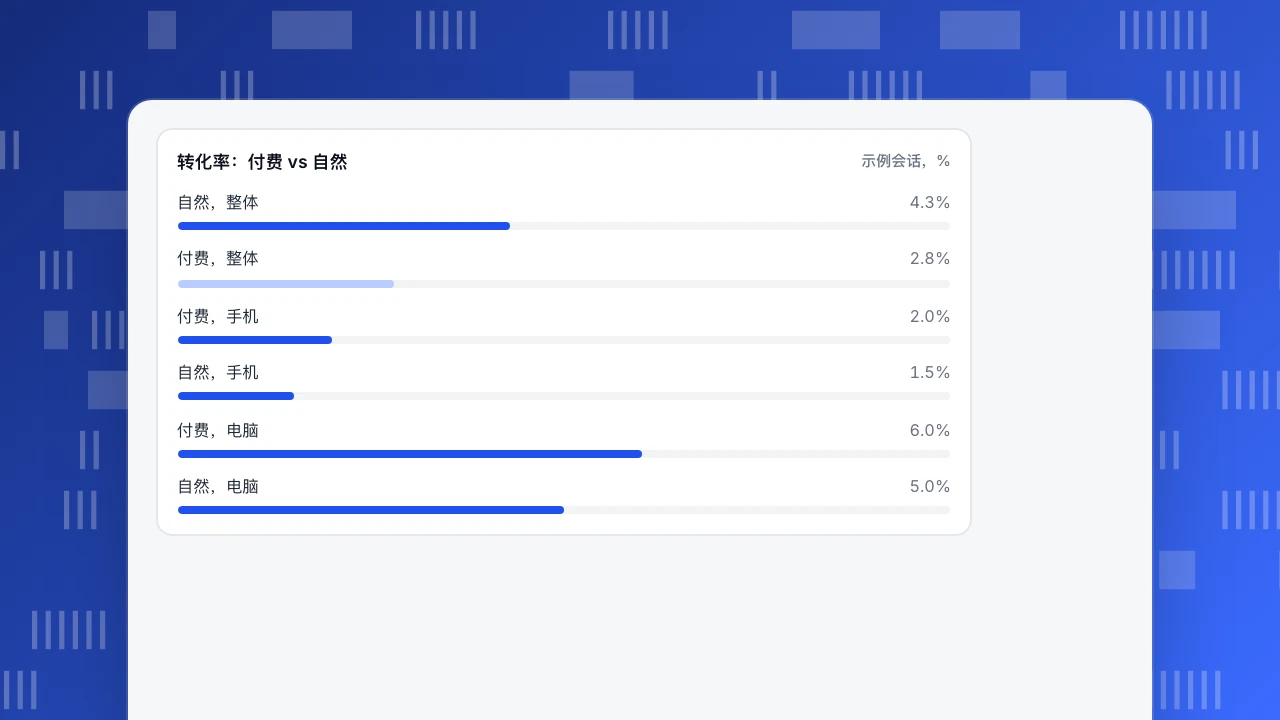
例 3:付费流量转化更差,按设备拆开就反过来了
示例数据:10,000 次付费会话和 10,000 次自然会话。
| 渠道 | 整体转化率 | 手机 | 电脑 |
|---|---|---|---|
| 付费 | 2.8%(10,000 里 280) | 2.0%(8,000 里 160) | 6.0%(2,000 里 120) |
| 自然 | 4.3%(10,000 里 430) | 1.5%(2,000 里 30) | 5.0%(8,000 里 400) |
整体上,自然比付费高 1.5 个点。但在手机上,付费高于自然(2.0% 对 1.5%);在电脑上,付费也高于自然(6.0% 对 5.0%)。看起来更差的渠道,在每一片里都更好,原因是付费会话里 80% 来自手机,而手机在两个渠道里的转化率都不超过电脑的三分之一。这种反转就是辛普森悖论,是混杂的最极端形式,更多解释见辛普森悖论。Bickel、Hammel 和 O'Connell(1975)分析过一个真实案例:大学录取的汇总数据里看似存在的偏向,按院系逐一比较后基本消失。
如果凭整体数字砍掉付费预算,你砍掉的会是在两种设备上都表现更好的渠道。正确的比较是分设备看,或标准化到同一构成:手机和电脑各占一半时,付费是 4.0%,自然是 3.25%。
转化率:付费 vs 自然
示例会话,%怎样在混杂变量造成误导之前发现它?
三个检查,按见效的先后排列:
- 问一问每个组里是些什么人。 凡是比较「自己选择了某件事」的人(用了某功能、点开了邮件、点了广告),中间都有一个选择环节。人们自己分了组,就假设他们在别的方面也不同。见选择偏差。
- 按常见嫌疑逐个拆。 产品和营销数据里嫌疑名单很短:获客渠道、设备、新老访客、套餐或客户规模、国家、注册时间(季节和版本发布)。差距在每一片里都站得住,可信度高得多。
- 比较构成,不只比较比率。 如果两组里手机、回访或付费用户的占比差得很大,嫌疑人就找到了。例 1 里构成是 80% 对 10%。
拆开后差距变化很大,缩小、消失或翻转,就是被混杂了。拆开后每一片里大致稳定,并不证明因果,但最常见的那个解释已经被排除。
发现之后能做什么?
| 方法 | 做什么 | 适用条件 | 弱点 |
|---|---|---|---|
| 分层 | 在各片(套餐、设备)里比较,各自报告 | 混杂变量少,每片用户够多 | 切片很快变薄 |
| 标准化 | 重新加权到同一构成,再比较比率 | 想得到一个可比的数字 | 掩盖各片之间的差别 |
| 匹配 | 给每个处理组用户配一个相似的未处理用户 | 有很多已测量的混杂变量 | 只能处理测量过的 |
| 随机化 | 用随机方式分配处理 | 处理由你控制 | 需要能做实验 |
只有随机化也能处理你没想到或没法测量的混杂变量,所以因果结论以它为标准。倾向得分方法(Rosenbaum 和 Rubin,1983)是做匹配的一种正式方式,但同样只能调整已记录的变量。做不了实验时,诚实的写法是「考虑套餐和设备之后,用功能的用户留存高 X 个点」,而不是「功能让留存提高了 X 个点」。更大的因果问题见相关与因果。
| 方法 | 做什么 | 弱点 |
|---|---|---|
| 分层 | 在套餐、设备等切片内比较 | 切片很快变薄 |
| 标准化 | 把各组加权到同一构成 | 掩盖各片之间的差别 |
| 匹配 | 给处理组配相似的未处理用户 | 只能处理已测量的变量 |
| 随机化 | 用随机方式分配处理 | 需要能做实验 |
只有随机化也能覆盖没测量的变量。
哪些错误会让混杂更严重?
- 控制了处理本身造成的变量。 如果功能让人更常登录,你又按登录频率做调整,就把一部分真实效果也扣掉了。只调整处理之前就确定的变量(注册时的套餐、渠道、设备、国家)。
- 切到什么都不剩。 按套餐、设备、国家、周一路拆下去,每格只剩五个用户,小格子的比率会剧烈波动。先拆一两层,并看每格人数。
- 把「我调整过了」当成「我消除了」。 你消除的只是测量过的那部分,要说清楚没测量的是什么。
- 以为混杂变量总是缩小效果。 它可能掩盖真实效果,也可能让符号反过来,例 3 就是。
- 只盯着隐藏变量。 混杂变量常常就摆在自己的表里(设备、渠道),只需要拆一下。
在 TapCub 里怎么做这些拆分?
上面三个例子,是团队最常对分析工具提的三个问题。下面把设备那个例子在 TapCub 里走一遍,只用现有的拆分和分群功能。
- 先看原始比较。 在全端分析 › 行为分析 › 行为分析里建一个从落地页到下单的漏斗,按渠道看。漏斗的拆分只用一层,并保留进入人数最多的 10 组,所以把这一层设成渠道。
- 加入嫌疑变量。 在全端分析 › 行为分析 › 事件分析里统计下单事件,拆分最多三层,比如渠道、设备、新老访客。在每种设备内部比较各渠道的转化率,就像上面的表。
- 留存要换个路。 留存分析没有拆分,所以在全端分析 › 用户 › 分群与标签里为每一片建一个分群(比如「手机」),逐个套用,或者用筛选。匿名访客不会进分群,所以这只适用于已识别的用户。
- 问一句是什么在变。 两个时期之间数字变了,全端分析 › 智能运营 › AI 助手里的「变化归因」会按渠道、来源域名、国家、设备、着陆页拆分,给出每个取值的变化占总变化的比例。它告诉你哪个维度承载了变化,不说明有没有因果。
- 检验因果在 TapCub 之外。 TapCub 不做实验和分流,只负责衡量。随机实验在你自己的工具里做,结果作为事件带回来,按分群读。
常见问题
混杂变量的例子有哪些?
功能与留存比较里的套餐类型。付费用户既更常用功能,也因为别的原因留得更久,所以比较用功能和没用功能的人,是把功能的效果和套餐的效果混在了一起。上面的示例里,28 个点的留存差距在每个套餐内部降到了零。
用简单的话说,混杂变量是什么?
混杂变量是第三个因素,它既和你以为的原因有关,也和结果有关,于是在两者之间制造或掩盖了联系。检查的办法是按这个因素把数据拆开。
混杂变量和潜在变量(lurking variable)有什么区别?
很多资料把两个词当同义词用。潜在变量通常指没人测量过的变量;混杂变量是任何扭曲比较的变量,测没测量都算。处理方式不同:测量过的混杂变量可以调整,没测量的需要随机化。
混杂变量会让真实效果消失吗?
会。混杂变量可能夸大效果、掩盖效果,或让方向反过来。在付费对自然的例子里,设备构成让付费在整体上垫底,而它在两种设备上都更好。
怎样控制混杂变量?
分层(在切片内比较)、标准化(加权到同一构成)、匹配相似用户,或随机分配。只有随机化也能覆盖你没测量的变量。
资料来源
- Greenland, S., Robins, J. M., Pearl, J. (1999). Confounding and Collapsibility in Causal Inference. Statistical Science, 14(1), 29–46.
- Bickel, P. J., Hammel, E. A., O'Connell, J. W. (1975). Sex Bias in Graduate Admissions: Data from Berkeley. Science, 187(4175), 398–404.
- Rosenbaum, P. R., Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55.
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
