Bonferroni 校正是把显著性水平除以比较的次数。一个对照加五个变体、α = 0.05 时,每次检验必须达到 p < 0.01。在我们的算例里,四个变体单独看都显著,校正后只有一个保留;Holm 方法保留两个。更严格阈值的代价是每组多约 49% 的流量。要在看结果之前就定好比较次数。
读完你会知道
- 五个变体在 α = 0.05 下,至少出现一个假赢家的概率是 22.6%;Bonferroni 把每次检验设为 0.01
- 示例里 5 个变体有 4 个是原始赢家,Bonferroni 保留 1 个,Holm 保留 2 个
- 要检测同样的提升,更严格的阈值需要每组多约 49% 的访客
Bonferroni 校正是做什么的?
Bonferroni 校正让一整组检验里「至少出现一次假阳性」的概率保持在你选定的水平上。做法是把显著性水平除以比较的次数:校正后 α = α ÷ 比较次数。Statsig 的文档给出同样的定义:实验的显著性水平除以比较次数,可用于测试组、指标,或两者同时(Statsig)。NIST 手册用区间来表达同一个思路:每个区间按 1 − α/g 的置信水平来构造,整体置信水平至少是 1 − α(NIST)。
取 α = 0.05、比较 5 次。每个检验现在必须达到 0.05 ÷ 5 = 0.01。单看显得显著的 p = 0.03,现在不算了。这个校正防的是假阳性,并不会让一个弱的结果变强。本文余下的部分是一个完整算例、你要为此付出的样本量代价,以及何时使用的规则。想先看定义,请读 Bonferroni 校正词条;显著性本身见统计显著性。
为什么测五个变体会打破 5% 的规则
5% 的显著性水平意味着:没有真实差异的检验,每 20 次仍会有 1 次显示「显著」。检验多了,这些概率会累加;单个检验本身没有任何异常,膨胀纯粹来自看的次数。对 k 个相互独立、都没有真实差异的检验,至少出现一次假阳性的概率是 1 − (1 − α)^k:
| 检验次数(k) | α = 0.05 时至少一次假阳性的概率 | Bonferroni 每次检验的 α |
|---|---|---|
| 1 | 5.0% | 0.0500 |
| 3 | 14.3% | 0.0167 |
| 5 | 22.6% | 0.0100 |
| 10 | 40.1% | 0.0050 |
| 20 | 64.2% | 0.0025 |
我们用模拟验证了 5 次检验这一行:把五个并无差异的检验重复 200,000 次,在 0.05 水平下 22.5% 的运行至少出现一个「显著」结果;在每次 0.01 的水平下只有 4.9%。所以校正把整组错误率拉回到你承诺的 5% 左右。一个对照加五个变体正是这种情形:五次比较,一个检验族。同样的算术也适用于指标:一个变体上的五个指标,同样是五次比较,都要计入同一个检验族。
| 检验次数 | 至少一次假阳性的概率 | Bonferroni 每次检验的 α |
|---|---|---|
| 1 | 5.0% | 0.0500 |
| 3 | 14.3% | 0.0167 |
| 5 | 22.6% | 0.0100 |
| 10 | 40.1% | 0.0050 |
| 20 | 64.2% | 0.0025 |
相互独立、都没有真实差异的检验,α = 0.05。概率 = 1 − 0.95^k。
算例:一个对照和五个变体
示例数据:一个落地页测试,一个对照和五个新标题,每组展示给 10,000 位访客。对照组 10,000 人中有 500 人转化(5.0%)。每个变体与对照组用双侧双比例 z 检验比较。
| 变体 | 转化数 | 转化率 | 相对提升 | 原始 p 值 | 0.05 下显著? | Bonferroni 校正后 p(× 5) | 整体 0.05 下显著? |
|---|---|---|---|---|---|---|---|
| A | 590 | 5.90% | +18.0% | 0.0051 | 是 | 0.0253 | 是 |
| B | 580 | 5.80% | +16.0% | 0.0123 | 是 | 0.0616 | 否 |
| C | 572 | 5.72% | +14.4% | 0.0238 | 是 | 0.1190 | 否 |
| D | 566 | 5.66% | +13.2% | 0.0377 | 是 | 0.1887 | 否 |
| E | 510 | 5.10% | +2.0% | 0.7468 | 否 | 1.0000 | 否 |
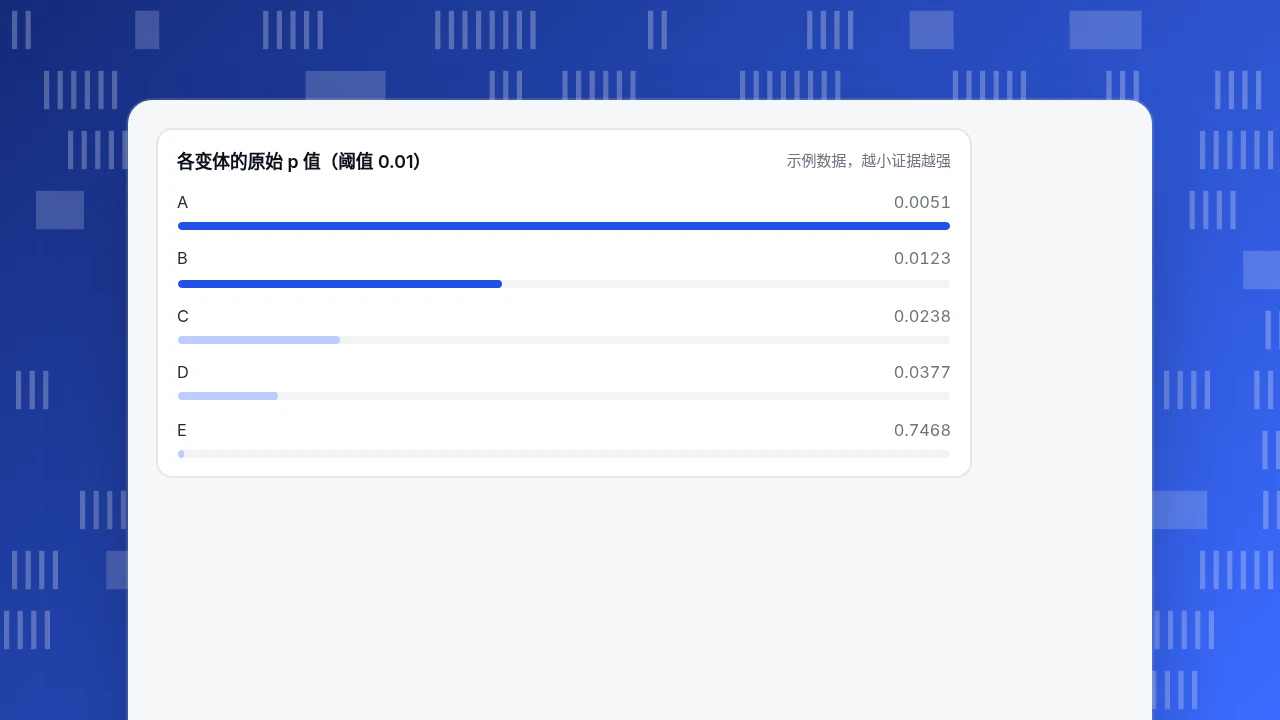
不校正的话,五个变体里有四个看上去是赢家。用 Bonferroni 校正后只有 A 过线:它的 p 值 0.0051 低于 0.01,等价地,5 × 0.00506 = 0.0253 低于 0.05。B、C、D 的提升看起来是真的,但一旦承认你看了五个变体,每一个的证据都不够强。
要谨慎地解读。「校正后不显著」不等于「没有效果」,只表示在整组层面不能排除偶然。B 的 16% 提升仍是当前的点估计,只是不能用同样的把握去宣称。
各变体的原始 p 值(阈值 0.01)
示例数据,越小证据越强校正会让样本量增加多少
阈值更严格,检测同样的提升就需要更多数据。要检测从 5.0% 升到 6.0%,检验功效 80%,双侧检验:
| 每次检验的 α | 每组所需访客 | 含对照和 5 个变体的总量 |
|---|---|---|
| 0.05(不校正) | 8,158 | 48,948 |
| 0.01(Bonferroni,5 次检验) | 12,139 | 72,834 |
每组多出 48.8% 的流量。有两个老实的办法:收集更多访客,或者少测几个变体。上线前就把多出来的流量算进预算,因为为了省时间提前结束测试,是让结果失效的最快办法。把五个变体减到两个,每次检验的 α 只收紧到 0.025,既省流量,也降低校正成本。样本量、功效和最小可检测效应的关系见统计功效和最小可检测效应。
Holm:功效更高的校正
Bonferroni 简单但保守。Holm 逐步递减法对整组错误率给出同样的保证,而且拒绝的假设不少于 Bonferroni(Holm,1979)。把 p 值从小到大排序,第 i 小的与 α ÷ (k − i + 1) 比较,遇到第一个不满足的就停:
| 排名 | 变体 | p 值 | 阈值 α ÷ (5 − 排名 + 1) | 结论 |
|---|---|---|---|---|
| 1 | A | 0.0051 | 0.0500 ÷ 5 = 0.0100 | 拒绝 |
| 2 | B | 0.0123 | 0.0500 ÷ 4 = 0.0125 | 拒绝 |
| 3 | C | 0.0238 | 0.0500 ÷ 3 = 0.0167 | 停止:不显著 |
| 4–5 | D、E | 不再检验 |
Holm 保留 A 和 B,而 Bonferroni 只保留 A。错误率保证一样,所以既然要校正,几乎没有理由不用 Holm。需要提前声明单一阈值,或者想在报告里用一句话说清楚时,再用朴素的 Bonferroni。两种方法都可以直接在表格软件里算出来,不需要专门的统计软件。
校正后的置信区间
如果你要报告区间,也用同样的逻辑校正。5 次比较时,整体 95% 的置信水平意味着每个区间按 1 − 0.05 ÷ 5 = 99% 来构造:
| 变体 | 与对照的差(百分点) | 未校正 95% 区间 | Bonferroni 99% 区间 |
|---|---|---|---|
| A | +0.90 | +0.27 到 +1.53 | +0.07 到 +1.73 |
| B | +0.80 | +0.17 到 +1.43 | −0.02 到 +1.62 |
| C | +0.72 | +0.10 到 +1.34 | −0.10 到 +1.54 |
| D | +0.66 | +0.04 到 +1.28 | −0.16 到 +1.48 |
把校正后的区间和校正后的 p 值放在一起报告,读者就能同时看到两者。区间讲的是和 p 值一样的故事,但信息更多:A 的区间始终在零以上,B 的刚好碰到零,宽度也说明数据对提升幅度的约束有多弱。
什么时候用,什么时候不用
- 看结果之前先定好检验族。 数一数你会当作发现来报告的比较:一个对照对五个变体,k = 5。看完结果再数,就能悄悄把 k 压小。
- 校正的是主结论,不是每个数字。 如果有一个主要指标和几个次要指标,给主要指标分最大的一份。Statsig 文档里的例子给主要指标 60% 的 α:2 个主要指标各得 0.6 × 0.05 ÷ 2 = 0.015,4 个次要指标各得 0.4 × 0.05 ÷ 4 = 0.005(Statsig)。
- k 很大时换方法。 有几十个指标或细分时,Bonferroni 会变得非常严格。常见替代是控制错误发现率,见错误发现率。
- 只有一个事先计划好的检验时不要校正。 一个问题,一次检验,一个阈值。
- 不要事后再拆分结果。 把一个没过线的测试按国家、设备、新老访客再切一遍,会产生新的比较;每一刀都要计入 k。
会让校正失效的四个错误
- 看了结果才选方法。 先试 Bonferroni,再试 Holm,再试不校正,留下哪个能显示出赢家的,就等于增加了比较次数。方法要在测试之前定好。
- 只算留下来的变体。 如果你上线了五个变体,汇报前砍掉两个,k 仍然是 5,因为被砍掉的两个也看过。
- 校正了 p 值,却没校正说法。 「校正后不显著」不等于「没有效果」。要像上面的表那样报告点估计和校正后的区间,并说明数据仍然允许的提升范围。
- 边看边停。 每天看结果,一个变体过线那天就停,会让假阳性高于 Bonferroni 能覆盖的程度。先按成本表定好样本量,达到后再读结果。
在 TapCub 里用你自己的数据做这件事
还是上面五个变体的例子。TapCub 不做 A/B 测试,也不分流,变体分配来自你自己的代码或测试工具;TapCub 擅长的是数清每个变体做了什么。
- 发送带变体名的事件。 每个变体各发一个曝光事件和一个注册事件,例如
exposure_a、signup_a、exposure_b、signup_b。也可以把variant作为事件属性发送,再用下面的 SQL 查询台读取。 - 每个变体建一个漏斗。 在 全端分析 › 行为分析 › 行为分析 里,建一个从
exposure_a到signup_a的漏斗,其他变体照做。漏斗默认按每个人每个会话的第一次进入计,再对人去重。 - 读每个变体的转化率。 每一步显示人数和相对上一步的转化率;可以把表导出为 CSV,也可以在 自定义指标与 SQL 的 SQL 查询台里按
variant属性汇总原始事件数。 - 自己做校正。 漏斗给出的是计数和转化率;用 α 除以变体个数,或者做 Holm,就是上面的算术,在表格里完成。分母也要干净:TapCub 把爬虫排除在转化率所用的访客数之外。
- 标注变更。 在 配置 › 日期标注 里为测试开始和结束的日期添加标注,让以后的读者能把数字和测试对上。
TapCub 衡量结果;它不分配变体,不计算校正后的 p 值,也不宣布赢家。关于显著性的更多内容,见统计显著性算例和如何解读 p 值。
常见问题
用最简单的话说,Bonferroni 校正是什么?
当你同时做几个检验时,它让结论保持诚实。把显著性水平除以检验次数:α = 0.05 且做 5 次检验,每次必须 p < 0.01。这样五个检验里出现任何一个假阳性的概率仍在 5% 左右。
Bonferroni 校正怎么算?
用 α 除以比较次数:校正后 α = α ÷ k。也可以把每个 p 值乘以 k(上限为 1),再与原来的 α 比较。5 次检验、α = 0.05 时阈值是 0.01,原始 p 为 0.00506 的结果乘以 5 后是 0.0253。
什么时候不该用 Bonferroni 校正?
只有一个事先计划好的检验时不用;k 很大时也要考虑别的方法。检验很多时它会非常保守,漏掉真实效应。Holm 提供同样的保护且功效更高,几十个指标、可以容忍少量假线索时,适合控制错误发现率。
Bonferroni 是不是太保守了?
可能是。它按检验之间依赖关系的最坏情形来设定,所以真实错误率常低于目标,也可能漏掉真实效应。算例里,4 个原始赢家它保留了 1 个,Holm 保留了 2 个。代价是额外的样本量,这里每组多约 49%。
除了多个变体,多个指标也要校正吗?
只要你会据此采取行动就要。把每个当作发现来报告的比较都算进检验族,或者在测试前先把 α 分给主要和次要指标。常见做法是主要指标得 60%、次要指标得 40%,各组内部平均分。
资料来源
- Statsig,Bonferroni correction(定义;α = 0.05 的分层指标例子)。核对于 2026-11-20。
- NIST/SEMATECH 统计方法电子手册,Bonferroni method(α/g 区间,整体置信水平至少 1 − α)。核对于 2026-11-20。
- Holm, S.(1979),A simple sequentially rejective multiple test procedure,Scandinavian Journal of Statistics 6(2),65–70。
- Bland, J. M. 和 Altman, D. G.(1995),Multiple significance tests: the Bonferroni method,BMJ 310,170(背景阅读)。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
