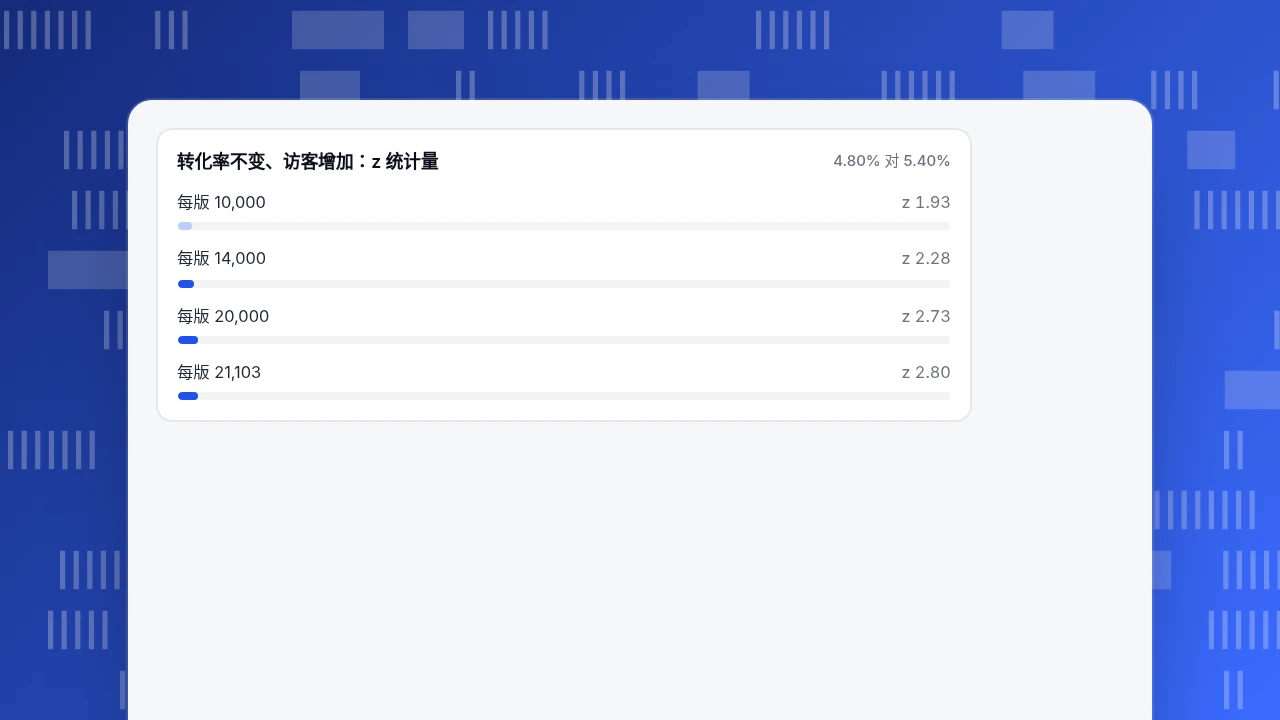
一个统计显著性的例子:对照版 10,000 名访客转化 480 个(4.80%),变体版 10,000 名转化 540 个(5.40%)。两比例 z 检验得 z = 1.93、p = 0.054,所以 12.5% 的提升在 5% 水平上不显著。下面给出这次计算的每一步、背后的区间和样本量,以及是否上线的判断规则。
读完你会知道
- 先定好假设、0.05 的水平和样本量再看数据:z = 1.93、p = 0.054 是没达到,不是差一点就赢
- 报告置信区间(−0.01 到 +1.21 个点)和功效(约 49%),不要只报结论
- 一变显著就停,会让真实的假阳性率远高于 5%
检验要回答什么问题,看数据之前先定什么?
统计显著性检验只回答一个问题:如果两个版本的转化能力其实一样,我们看到的这个差距有多出人意料?下面是一个具体的情形。结账页有对照版(A)和表单更短的变体版(B),测试工具随机分配,每个版本各展示给 10,000 名访客。
示例数据:
| 访客 | 订单 | 转化率 | |
|---|---|---|---|
| 对照版(A) | 10,000 | 480 | 4.80% |
| 变体版(B) | 10,000 | 540 | 5.40% |
B 看起来更好:高出 0.60 个百分点,相对提升 12.5%。这是真实差异还是运气,要靠检验来判断。
看数据之前先写下三件事,因为看完结果再选,结果就会左右你的选择:
- 假设。 原假设认为两个版本的真实转化率相等(pA = pB),备择假设认为不等(双侧)。
- 显著性水平。 我们取 α = 0.05:接受 5% 的概率在没有差异时误判为有差异。
- 样本量和停止规则。 先定每个版本要多少访客,不提前停止。后面讲样本量的一节说明原因。一行计划就够:双侧检验,α = 0.05,每版 21,103 名访客,只看一次。
同样的逻辑适用于任何两组比较;这个概念的完整讲解在 统计显著性,我们要算的量是 p 值。
怎样一步步算出来?
比较两个转化率的标准方法是两比例 z 检验,NIST/SEMATECH 手册里有说明。它要求每组的转化数和未转化数都足够多(常见的经验是各至少 10;这里是 480 和 9,520,没有问题)。
| 步骤 | 公式 | 计算 | 结果 | ||
|---|---|---|---|---|---|
| 1. 转化率 | p̂ = 订单 ÷ 访客 | A:480 ÷ 10,000;B:540 ÷ 10,000 | 0.0480 和 0.0540 | ||
| 2. 合并转化率 | p̂ = (x₁ + x₂) ÷ (n₁ + n₂) | (480 + 540) ÷ 20,000 | 0.0510 | ||
| 3. 标准误 | √( p̂(1 − p̂)(1/n₁ + 1/n₂) ) | √(0.051 × 0.949 × 0.0002) | 0.003111 | ||
| 4. z 统计量 | (p̂B − p̂A) ÷ SE | 0.0060 ÷ 0.003111 | 1.93 | ||
| 5. p 值 | 2 × (1 − Φ(\ | z\ | )) | 2 × (1 − Φ(1.93)) | 0.054 |
第 2 步为什么要合并?原假设认为两组共用一个真实转化率,所以对它最合适的单一估计要用上全部 20,000 名访客。手册给出的双侧检验决策规则是:|z| 大于 1.96 就拒绝原假设,1.96 是在 α = 0.05 时两侧各留 2.5% 的临界值。
我们的 |z| 是 1.93,略低于 1.96;p 值是 0.054,略高于 0.05。在 5% 水平上,结果不显著。
| 结果 | 说明什么 | 怎么做 |
|---|---|---|
| p < 0.05,整个区间高于盈亏平衡 | 大概率真实且值得要 | 上线 |
| p < 0.05,区间下端低于盈亏平衡 | 大概率真实,但可能太小 | 只在便宜且可撤回时上线 |
| p ≥ 0.05,区间很宽 | 没有结论,常常是功效不足 | 跑到计划样本量,或测更大的改动 |
| p ≥ 0.05,区间在 0 附近很窄 | 大概率没有值得要的效应 | 停下,换个思路 |
盈亏平衡提升是能收回改动成本的最小提升,测试前先算出来。
「不显著」在这里是什么意思,不是什么意思?
它不表示没有差异。它表示:在「没有差异」的前提下,这些数据还不够出人意料,达不到我们事先要求的证据强度,所以不拒绝原假设。美国统计协会 2016 年关于 p 值的声明讲得很清楚:p 值不衡量假设为真的概率,也不衡量效应的大小或重要性。
置信区间比「是 / 否」的结论说得更多。对转化率之差,用非合并标准误:√(0.048 × 0.952 ÷ 10,000 + 0.054 × 0.946 ÷ 10,000) = 0.003111(这里与合并值前四位相同)。95% 区间是 0.0060 ± 1.96 × 0.003111,即 −0.01 到 +1.21 个百分点。
两个数字要一起报告:p 值说明这个差距有多出人意料,区间说明它可能有多大。可以这样读:
- 区间刚好把 0 包含在内,所以 p 值刚好高于 0.05;两者总是一致的。
- 合理的提升范围从几乎为零到 1.21 个点,是观察到的 0.60 的两倍多。
- 不显著也是一个结果:记录下来,免得以后盲目重试。
- 所以诚实的说法不是「B 没赢」,而是「B 可能带来最多约一个点的提升,只是我们还没收集到足够的数据来判断」。
这个测试的功效也不足。假如真实转化率就是 4.80% 对 5.40%,每版 10,000 名访客的测试在 α = 0.05 时只有约 49% 的机会检出。没有人会故意选一个成功概率像抛硬币的设计。功效是测试检出真实存在的效应的概率,通常以 80% 为目标;下一节会算出达到它所需的样本。
一直收集数据直到显著,会怎样?
最诱人的做法是再等几天。假设 4.80% 和 5.40% 一直不变,同样的转化率在更大的样本下会是这样:
| 每版访客 | A / B 订单 | z | 双侧 p 值 | 在 0.05 水平显著? |
|---|---|---|---|---|
| 10,000 | 480 / 540 | 1.93 | 0.054 | 否 |
| 14,000 | 672 / 756 | 2.28 | 0.022 | 是 |
| 20,000 | 960 / 1,080 | 2.73 | 0.006 | 是 |
| 21,103 | 1,013 / 1,140 | 2.80 | 0.005 | 是 |
这张表说明:如果转化率保持不变,更多数据能解决问题。它不能说明你可以在 14,000 人时停下。Evan Miller 对重复检验的分析指出了问题:如果每来一个观察值就查看一次,第一次看到 5% 显著就停,他给的例子(50% 基准转化率,在 150 个观察值内停止)里真实的假阳性率可以达到 26.1%,是预想水平的五倍多。即使在 1% 的阈值上看 10 次,表现也大约相当于 5%。
固定样本量的检验只读一次,这是它能保证 5% 水平的代价。让测试保持诚实的规则:
- 测试开始前先定好样本量,到了再看一次结果。 在 α = 0.05、功效 80% 时,常用的估算是每组 n ≈ 16 × p(1 − p) ÷ d²,d 是你在意的最小差异。p = 4.8%、d = 0.6 个点时,是 16 × 0.048 × 0.952 ÷ 0.006² ≈ 20,300 每版。同时考虑两个转化率的完整公式给出每版 21,103。
- 一定要中途查看,就用专为此设计的方法(序贯检验,或中期查看用更严格的阈值),而不是把标准检验反复读取。
- 不要只因为第一次的答案不合心意就延长测试。
转化率不变、访客增加:z 统计量
4.80% 对 5.40%显著的结果值得行动吗?
显著性说明差距大概率不是运气,并不说明这个差距值得你花力气。再补上财务部门会算的那笔账,先从盈亏平衡提升算起:改动成本 ÷ 每单毛利 ÷ 每月访客。这里是 6,000 ÷ 24 ÷ 100,000 = 0.25 个百分点,也就是一个月内收回改动成本所需的最小提升。
| 项目 | 示例值 |
|---|---|
| 结账页每月访客 | 100,000 |
| 观察到的提升 | +0.60 个点 = 每月多 600 单 |
| 每单毛利 | 24 美元 |
| 多出的毛利 | 600 × 24 美元 = 每月 14,400 美元 |
| 改动成本(设计、开发、测试) | 6,000 美元 |
| 按观察到的提升回本 | 6,000 ÷ 14,400 ≈ 0.4 个月 |
| 按区间下端(约多 0 单)回本 | 不会回本;这个改动没有收益 |
最后一行就是要看区间的原因:是否上线可以按观察到的提升来定,风险却在下界上。
动用预算之前,用区间的下端再算一遍回本。任何测试都可以用这套简单的判断规则:
- p < 0.05,且整个区间都高于你的盈亏平衡提升: 上线。
- p < 0.05,但区间下端低于盈亏平衡: 只有改动便宜且容易撤回时才上线。
- p ≥ 0.05 且区间很宽: 没有结论。跑到计划样本量,或者测一个更大的改动。
- p ≥ 0.05 且区间在 0 附近很窄: 大概率没有值得要的效应。停下来,换个思路。
在 TapCub 里怎么衡量两组?
还是上面的结账例子。TapCub 不分流量,也不计算 p 值;把访客分到 A 或 B 的是你的测试工具或你自己的代码。TapCub 负责数清每一组做了什么,并且把机器人排除在访客基数之外。步骤:
- 事件里带上变体。 访客完成结账时,在代码里调用
tapcub.track('order_complete', { variant: 'B' }),更早的事件也带上变体,让漏斗每一步都有这个属性。 - 建漏斗。 在 全端分析 › 行为分析 › 行为分析 里,建一个从结账开始事件到
order_complete的漏斗,并按variant拆分。每一步都显示人数和相对第一步的比率;默认按去重计数,每个访客只算一次。 - 先看分母。 两组都应该接近计划的 10,000。如果有一组差得很远,说明分流有问题,修好之前结果没有意义。
- 把数字抄进公式。 每组的访客和订单就是上表里的 n 和 x。在表格或脚本里完成计算。
- 把机器人挡在外面。 TapCub 把认出的机器人和 AI 爬虫单独放在 网站统计 › 机器人 里,它们不会进入你抄走的访客和转化数。
如果看的是全站目标而不是某个漏斗,网站统计 › 目标 会按所选日期显示转化数、转化访客和整体转化率。
哪些错误会毁掉显著性检验?
- 数字好看就停。 上面讲过,会抬高假阳性。
- 做很多比较,只报告赢家。 在 α = 0.05 下测 20 个变体,其中一个因运气而显著的概率很高。用 α 除以比较次数,或事先固定你关心的那一个比较。
- 在不相等或重叠的分组上用检验。 同一个访客看到了两个版本,或者分组不是随机分配,标准误就不对。
- 把 p = 0.054 和 p = 0.046 当作对立。 它们几乎是同样强度的证据。报告区间,而不只是结论。
- 测完再切片。 把已结束的测试按设备、国家或渠道拆开,只报告其中显著的那一片,本质上还是多重比较的问题。要看哪些细分,测试开始前就定好,并且只看这几个,不要事后再挑。
- 把显著性和大小混为一谈。 样本极大时,很小的差异也会显著;一定要拿区间对照盈亏平衡提升。
常见问题
统计显著性的例子是什么?
结账测试,每版 10,000 名访客,对照版 480 单,变体版 540 单。两比例 z 检验得 z = 1.93、p = 0.054,在 α = 0.05 时不显著。如果每版是 20,000 名访客、转化率不变,则 z = 2.73、p = 0.006,就显著了。
两个转化率的统计显著性怎么算?
先算各自的转化率,用全部访客合并成一个转化率,再用差值除以标准误 √(p̂(1 − p̂)(1/n₁ + 1/n₂)) 得到 z。把 z 换算成双侧 p 值,与你的 α(通常 0.05)比较。公式见 NIST/SEMATECH 手册。
p 值多少才算统计显著?
按惯例,是 p 值低于你在测试前选定的显著性水平,最常见的是 0.05。这个水平是你愿意接受多大的假阳性风险,不是自然规律。美国统计协会提醒,不要把 0.05 当成决定真伪的分界线。报告精确的 p 值和区间,而不是只写「p < 0.05」。
不显著就代表没有差异吗?
不代表。它表示数据还不够强,不足以在你选的水平上排除偶然。看置信区间:本例是 −0.01 到 +1.21 个点,所以约一个点的真实提升仍然可能。这个测试功效不足。
A/B 测试需要多少访客?
取决于基准转化率和你在意的最小提升。基准 4.8%、提升 0.6 个点,功效 80%、α = 0.05,每版大约需要 21,100 名访客。粗略核对可用每组 n ≈ 16 × p(1 − p) ÷ d²。预期提升越小,需要的访客越多:d 减半,n 大约变成四倍。
资料来源
- NIST/SEMATECH e-Handbook of Statistical Methods,Do two processes produce the same proportion of defectives?(合并的两比例 z 检验与临界值规则)。2026-11-20 核对。
- Ronald L. Wasserstein 和 Nicole A. Lazar,The ASA's Statement on p-Values: Context, Process, and Purpose,The American Statistician 70(2),129–133,2016。
- Evan Miller,How Not To Run An A/B Test(持续查看下 26.1% 的假阳性率;50% 基准、150 个观察值内停止)。2026-11-20 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
