AI 可见度审计回答三个问题:AI 爬虫能不能抓到你的页面、AI 助手引用的是什么、这些引用带来了多少访问?把它当作五步检查清单来做,不要做成一个分数,因为爬虫访问、引用和转化是因不同的原因出问题的。下面是每一步、一个数过的爬虫示例、一张完整的检查表,以及会误导人的错误。
读完你会知道
- 把可衡量的一半(爬虫、带来的访问、转化)和要抽样的一半(助手怎么说)分开
- 抓取不等于引用:一个页面可以被抓几千次,却从没被引用
- 按用途逐个爬虫决定,因为训练、搜索和用户触发的抓取是不同的事
AI 可见度审计要检查什么?
AI 可见度审计依次回答三个问题:AI 爬虫能不能抓到你的页面、AI 助手引用的是什么、这些引用带来了多少访问? 它是一张每季度都能重复做的检查清单,不是一个分数。这个概念本身和它为什么重要,在 AI 可见度 里讲过;本文讲的是操作步骤。
审计分两半,需要不同的方法:
- 可衡量的一半在你自己的数据里:哪些爬虫抓了哪些页面、拿到什么状态码,以及哪些真人会话来自 AI 助手。
- 要抽样的一半是助手实际上怎么说你。没有任何日志能显示它。你要用一组固定的问题去问,并把答案记下来。
单一的「可见度分数」把两半混在一起,看不出是哪一半出了问题。要把它们分开:被屏蔽的页面不可能被引用,而被抓了一万次却从没被引用的页面,问题是另一种。
| 问题 | 去哪里看 | 方法 |
|---|---|---|
| AI 爬虫能抓到你的页面吗? | robots.txt、状态码、页面 HTML | 衡量 |
| 哪些爬虫真的在读你? | 爬虫日志或机器人报表 | 衡量 |
| 助手引用了什么? | 一组固定的 15 到 25 个提问 | 按计划抽样 |
| 有多少访问来自 AI? | 来自 AI 来源的真人会话 | 衡量 |
| 这些访问转化了吗? | AI 来源会话的目标 | 衡量,要有足够的量 |
五项检查里有四项来自你本来就在收集的数据;只有引用检查是手动的。
第 1 步:AI 爬虫能抓到你的页面吗?
先从控制访问的文件开始,因为其他一切都取决于它。
- 打开线上域名的
/robots.txt,读你关心的每个 AI 爬虫的规则。它们是不同的用户代理,用途也不同。OpenAI 的文档列出了 OAI-SearchBot(抓取是为了让网站出现在 ChatGPT 的搜索功能里)、GPTBot(内容可能用于训练其模型)和 ChatGPT-User(用户提问时抓取页面,robots.txt 规则可能不适用)。屏蔽 GPTBot 是训练层面的决定,而屏蔽 OAI-SearchBot 会让你不出现在 ChatGPT 的搜索回答里;要逐个爬虫决定,不要一刀切。每个爬虫在各自的文章里都有说明,例如 GPTBot,术语见 AI 爬虫。 - 确认 robots.txt 本身能打开。 按《机器人排除协议》(RFC 9309),爬虫因服务器错误访问不到 robots.txt 时,必须当作完全禁止。所以一个报错的 robots.txt 可能把所有爬虫都挡在外面。
- 检查关键页面的状态码。 浏览器访问返回 200、爬虫访问返回 403 的页面,对爬虫来说是不可见的。服务器日志或爬虫报表会显示每个机器人实际收到了什么。
- 确认内容在 HTML 里。 很多爬虫不执行 JavaScript。如果商品描述是在客户端加载的,它们可能读不到。
Robots.txt 是请求,不是锁:RFC 9309 明确写着,这些规则不是一种访问授权。把它当作意图声明,并在日志里核实爬虫的实际行为。
第 2 步:要不要发布 llms.txt?
把它当作可选项,并检查它对你有什么用。llms.txt 提案是在网站根目录放一个名为 llms.txt 的 Markdown 文件,以标题开头,后面是简短摘要和值得读的页面链接。它只是一个提案,不是每个助手都遵循的标准,所以审计要问的不是「我们有没有」,而是「它有没有用,内容准不准确」。
审计要检查:
- 文件在
/llms.txt能打开,状态码 200。 - 它只链接存在且最新的页面。
- 描述和页面内容一致。
- 你在日志里查过有没有 AI 爬虫来取它。如果一个都没有,它就是一份无害的文档,不是一个杠杆。
设置方法和取舍见 llms.txt 指南。
第 3 步:哪些爬虫真的在读你的网站?
按运营方和用途统计抓取次数。爬虫各不相同:有的为训练而读,有的为回答问题,有的为搜索。要看的不是机器人流量总数,而是谁在读、为了什么、带回了什么。
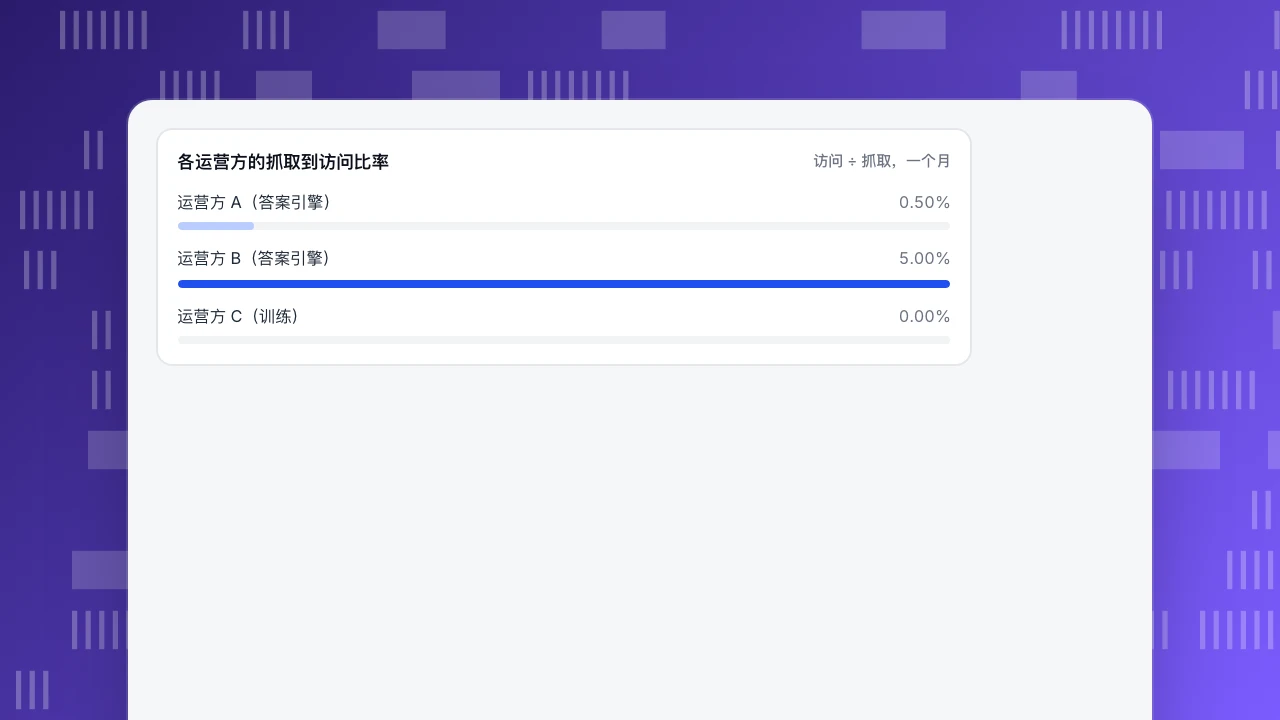
示例数据:一个月内的三个 AI 运营方。
| 运营方 | 用途 | 抓取次数 | 带回的访问 | 抓取到访问的比率 | 每个访问对应的读取数 |
|---|---|---|---|---|---|
| 运营方 A | 答案引擎 | 18,000 | 90 | 0.50% | 200 : 1 |
| 运营方 B | 答案引擎 | 3,000 | 150 | 5.00% | 20 : 1 |
| 运营方 C | 训练 | 6,000 | 0 | 0.00% | 没有访问 |
| 合计 | 27,000 | 240 | 0.89% | 112.5 : 1 |
每个比率都是访问 ÷ 抓取:90 ÷ 18,000 = 0.50%,150 ÷ 3,000 = 5.00%,0 ÷ 6,000 = 0%,240 ÷ 27,000 = 0.89%。「每个访问对应的读取数」那一列方向相反:18,000 ÷ 90 = 200,3,000 ÷ 150 = 20,27,000 ÷ 240 = 112.5。
解读:运营方 A 的读取量是 B 的六倍(18,000 ÷ 3,000),带回的访问却少得多。这是个值得调查的模式(它抓到的页面是不是人们会点的页面?),不要一上来就屏蔽它。运营方 C 是训练爬虫,本来就不指望它带来访客,所以零不算失败。按用途逐个运营方来决定。 还要看站点地图覆盖率:如果站点地图有 400 个网址,AI 爬虫抓过其中 140 个,覆盖率就是 35.0%,没被抓的 260 个页面值得做一次可抓取性检查。
各运营方的抓取到访问比率
访问 ÷ 抓取,一个月第 4 步:助手实际引用了什么?
这是要抽样的一半。建立一组固定的提问,并按计划去跑。
- 写 15 到 25 个问题,是买家真的会问的,分三组:品类问题(「怎么追踪 X」)、对比或评估类问题,以及点名你的问题。
- 每次用同样的方式跑,在你的客户会用的助手上、从干净的会话开始,并记下日期。
- 每个回答记四件事: 有没有提到你、有没有引用你的页面、描述是否准确,以及引用了哪些其他来源。
- 把回答存下来。 助手每次运行的结果会有差异,所以一个回答只是轶事;同一个问题跑十次才是数据。
然后和你自己的数据对照。对每个被引用的页面,打开你的分析,看有没有来自 AI 的真人会话落在上面。被引用却没有访问的页面,可能是引用时没有带链接,或者读了却没有点击。有 AI 访问、却从没出现在你的提问清单里的页面,会告诉你那些你没想到的问题;把它们加进去。
第 5 步:这些访问转化了吗?
访问只是输入,审计要落在目标上。取来自 AI 的真人会话,测量其中到达目标的比例,再和全部会话对比。
示例数据:当月真人会话 12,000 个,其中 240 个来自 AI 助手。目标完成数:240 个 AI 来源会话里有 9 个(3.75%),全部 12,000 个会话里有 300 个(2.5%)。
- AI 占真人会话的比例:240 ÷ 12,000 = 2.0%。
- AI 来源的转化率:9 ÷ 240 = 3.75%,整体是 300 ÷ 12,000 = 2.5%。
九次转化太少,下不了任何结论。经验规则:这一组的转化数低于约 30 时,把比率当作方向,不当作结果,再过一个月复查。如果这个比率持续高于整体,说明 AI 带来的访客比它们的占比所显示的更有价值,被引用的页面值得持续维护。
完整的检查清单是什么样?
| 检查项 | 看什么 | 通过的标准 | 不通过怎么办 |
|---|---|---|---|
| robots.txt 能打开 | /robots.txt 的 HTTP 状态 | 200,不是 5xx | 先修服务器;打不开的文件会挡住爬虫 |
| 逐个爬虫的规则 | robots.txt 里每个 AI 用户代理 | 有意识地允许或屏蔽 | 按用途决定:搜索、训练、用户触发抓取 |
| 关键页面可抓取 | 爬虫收到的状态码 | 对爬虫返回 200 | 检查防火墙和机器人规则 |
| 内容在 HTML 里 | 不执行 JavaScript 的页面源码 | 正文都在 | 把重要内容做服务端渲染 |
| llms.txt(可选) | /llms.txt 能打开,链接是最新的 | 内容准确,日志里有人来取 | 修好或不要了 |
| 爬虫日志 | 按运营方看抓取、状态码、用途 | 能说出谁在读你 | 加上服务端采集 |
| 引用 | 按计划跑的提问清单 | 你的页面被引用且描述正确 | 改进那些页面 |
| AI 来源访问 | 来自 AI 来源的真人会话 | 访问到达被引用的页面 | 检查链接和落地页 |
| 转化 | AI 来源会话的目标 | 量够大,能读出结果 | 等待,或把周期拉长 |
哪些错误会让审计产生误导?
- 把抓取当成引用。 爬虫抓了一个页面,意味着它被读过,不代表被引用或被推荐。只有提问抽样和 AI 来源的访问,才能说明引用的情况。
- 因为训练爬虫不带来访客,就把全部屏蔽。 训练和答案引擎是不同的用途;屏蔽一个不必连带屏蔽另一个。
- 只审计一个助手,就推广到所有助手。 不同助手引用不同的来源。要覆盖你的客户在用的那几个。
- 相信单一分数。 把抓取权限、提及和情感混在一起的分数,告诉不了你该修什么。要把各项检查分开。
- 不检查不执行 JavaScript 的爬虫。 只有页面脚本时,你只能看到执行脚本的机器人;其他的需要服务端采集或日志导入。
- 跑一次就下结论。 助手的结果会随运行和时间变化。要按计划重跑并对比。
在 TapCub 里怎么跑这个审计?
拿上面的示例网站来说,可衡量的那一半这样跑。
- 看谁在读你。 打开 网站统计 › 机器人。在 AI 与智能体 页签,AI 内容账本 按运营方列出读取次数(训练爬虫和答案引擎分两列)、带回的真人访客和比值。这个比值是读取 ÷ 访客,就是上面的「每个访问对应的读取数」那一列。
- 读可见度闭环。 在 AI 可见性 页签,卡片显示 AI 爬取、AI 带来的访问、抓取→访问比(访问 ÷ 抓取,和账本的方向相反)以及设置了站点地图时的 站点地图覆盖。被引用页面 列出收到 AI 带来访问的落地页。
- 数人。 打开 网站统计 › 来源 和它的 AI 来源 页签,它数的是真人会话,不是爬虫请求,口径和 AI 带来的访问 相同。
- 细看一个爬虫。 在 全部机器人 里,打开某个爬虫的页面和最常见状态码。规则遵守情况见 监测 › 爬虫合规。
- 闭环。 把 AI 来源的会话带到 网站统计 › 目标,和全部会话对比转化。
要清楚限制:只有页面脚本时,TapCub 只能看到执行 JavaScript 的机器人,所以状态码和不执行 JavaScript 的爬虫,需要服务端采集或日志导入。TapCub 统计抓取和访问;它不会替你跑提问清单,也不会记录助手怎么说你,所以第 4 步仍然要手动做。
常见问题
什么是 AI 可见度审计?
一种结构化检查:AI 爬虫能否访问你的内容、AI 助手在被问到相关问题时引用什么,以及这些引用带来多少访问。它是可重复的检查清单,每一项分别通过或不通过,不是单一分数。
怎么检查我的网站对 AI 是否可见?
检查 robots.txt 里每个 AI 爬虫的规则,确认关键页面对爬虫返回 200,查看日志或机器人报表里的爬虫统计,然后在你的客户会用的助手里跑一组固定问题,记录它们引用了什么。
AI 可见度审计多久做一次?
可衡量的检查每月做,因为它们来自你本来就在收集的数据;提问抽样每季度做一次,或在内容有大改动后做。每次都保存下来,方便按时间对比结果。
屏蔽 GPTBot 会让我的网站从 ChatGPT 里消失吗?
据 OpenAI 说明,GPTBot 关系到可能用于训练模型的内容,而 OAI-SearchBot 关系到 ChatGPT 的搜索结果。屏蔽 GPTBot 是训练层面的决定;屏蔽 OAI-SearchBot 会影响你是否出现在 ChatGPT 搜索里。
我需要 llms.txt 吗?
不一定。它只是一个提案,并不是每个助手都在用。如果你发布了,就保持内容准确,并在日志里检查 AI 爬虫是否会来取它。
资料来源
- OpenAI。Overview of OpenAI crawlers。OAI-SearchBot、GPTBot 和 ChatGPT-User 的用途,以及 robots.txt 如何适用。2026-11-18 核对。
- M. Koster、G. Illyes、H. Zeller、L. Sassman。RFC 9309: Robots Exclusion Protocol。第 1 节(不是访问授权)和第 2.3.1.4 节(无法访问的 robots.txt)。2026-11-18 核对。
- Jeremy Howard。The /llms.txt file。llms.txt 提案。2026-11-18 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
