AI 品牌可见度软件告诉你 AI 助手多常提到或引用你的品牌,但分数取决于工具怎么抽样:每个提示词运行多少次、用哪些提示词、哪个模型入口、从哪里发起。先看方法,再看看板。下面讲三类工具、为什么 35% 其实可能是 18% 到 57%、该向厂商问的问题、两份报告的算例对比,以及 TapCub 能看到什么、看不到什么。
读完你会知道
- 提示词抽样的分数是估计;要问一个数字背后有多少次运行,因为 20 次里 7 次的范围是 18.1% 到 56.7%,100 次里 35 次是 26.4% 到 44.7%
- 比较任何两个工具之前,先要提示词清单、模型入口、提及的定义和原始回答
- AI 系统在你自己网站上做了什么(爬虫读取、带来的访问)是可以观察的,不需要抽样
AI 品牌可见度软件测的是什么?
AI 品牌可见度软件报告 AI 助手多常、以什么方式提到或引用你的品牌。多数产品的做法是:用一组固定的提示词,对一个或多个模型重复运行很多次,数一数返回了什么:你的品牌被点名的频率、你的网站有没有被引用、在回答里出现在什么位置、语气是否正面。还有一小类产品测的是别的、可以直接观察的东西:哪些 AI 爬虫读了你的网站,以及 AI 助手给你带回多少访客。
这是三种不同的工具,把它们当成一种来比较,是买家最先犯的错。
| 类型 | 测什么 | 数据从哪里来 | 典型输出 |
|---|---|---|---|
| 提示词抽样追踪 | 针对选定的提示词,模型怎么说你 | 厂商对模型反复运行的提示词 | 提及率、引用率、位置、情感倾向 |
| 站点侧分析 | AI 系统在你自己的网站上做了什么 | 你自己的流量和服务器日志 | 爬虫读取、AI 带来的访问、被引用页面 |
| 内容与公关工具 | 改什么才能被更多提到 | 对页面和第三方来源的分析 | 建议、差距清单 |
本文余下部分讲怎样评判提示词抽样这一类,因为数字差异最大的就是它,而一行方法说明就能解释为什么。关于 AI 可见度该怎么办的整体问题,见 AI 可见度,逐步检查的做法见 AI 可见度审计。
为什么同一个品牌在不同工具里分数不同
每一个提示词抽样得出的数字,都是由样本得出的估计,而样本会波动。同一个问题问模型二十次,它不会给出二十次一样的回答。在可见度真正变化之前,有四件事就会让分数变动:
- 每个提示词的运行次数。 次数越少,误差范围越宽。
- 提示词清单。 本身带有品类或品牌线索的提示词,比中性提示词更常返回你。
- 访问入口。 通过开发者接口访问的模型,可能和消费者应用里的同一个模型回答不同,开不开联网搜索也不同。
- 地点、时间和模型版本。 回答会随国家、周次和模型更新而变化。
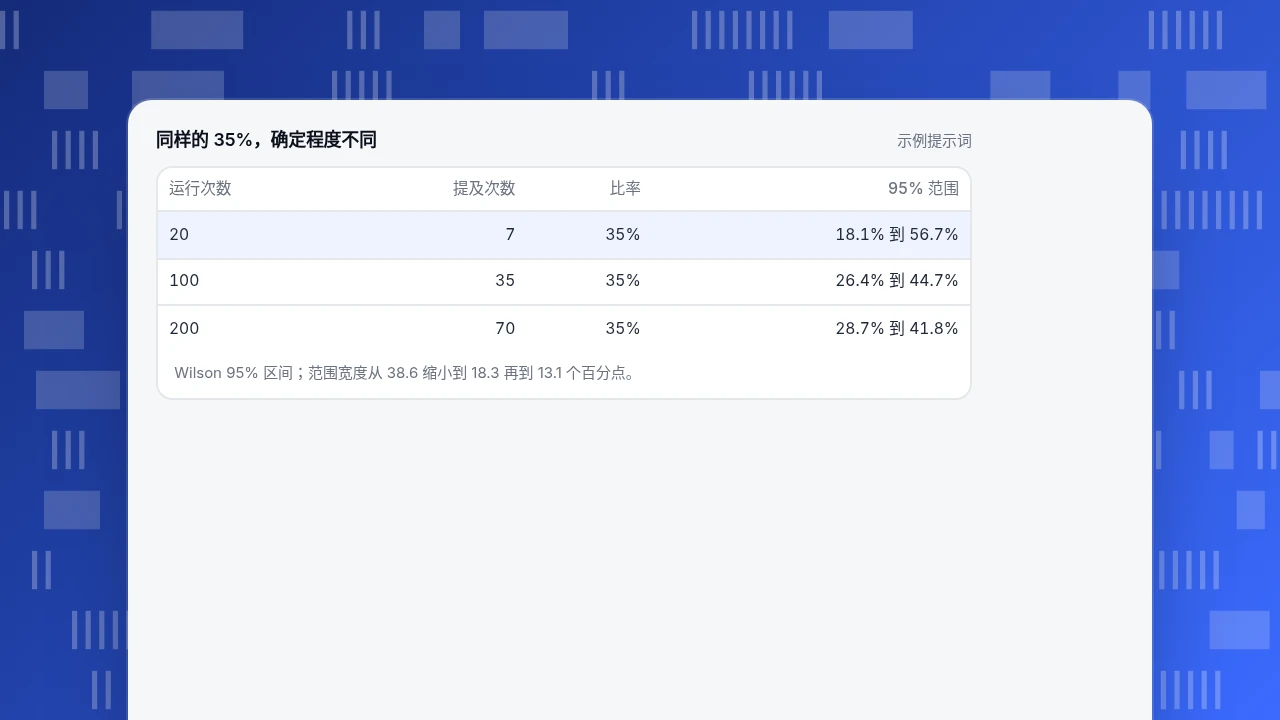
运行次数这个因素可以量化。对于运行 n 次测得的提及率 p,95% 范围的常用近似是 Wilson 区间。示例数据:同一个品牌在某个提示词的 20 次运行里被提到 7 次,即 35%。
| 运行次数 | 提及次数 | 比率 | 95% 范围 |
|---|---|---|---|
| 20 | 7 | 35% | 18.1% 到 56.7% |
| 100 | 35 | 35% | 26.4% 到 44.7% |
| 200 | 70 | 35% | 28.7% 到 41.8% |
点估计始终不变;范围宽度从 20 次时的 38.6 个百分点,缩小到 100 次时的 18.3,200 次时的 13.1。厂商只展示“35%”却不给运行次数,等于给你一个数字,却不告诉你该信几分。
向任何 AI 可见度软件厂商要问的问题
这类工具的质量大多在方法里,而方法很少放在价格页上。问下面这些问题,并留意回答是否具体。
| 问题 | 具体的回答听上去像什么 | 为什么重要 |
|---|---|---|
| 每次刷新时每个提示词运行多少次? | 一个数字,并展示区间 | 决定误差范围 |
| 提示词由谁写? | 你能看到、编辑并导出完整清单 | 中性提示词和带品牌线索的提示词分数不同 |
| 覆盖哪些模型和入口? | 点明具体模型,区分开不开搜索 | 不同入口的分数不可比 |
| 在哪里发起运行? | 国家或城市设置 | 回答随地点变化 |
| 怎么定义“提及”? | 明确的规则:名称匹配、别名、链接 | “提及”和“引用”是两个不同的数字 |
| 能看原始回答吗? | 能,已存储并可导出 | 让你能手工核对任何分数 |
| 模型更新时怎么办? | 图表上标注版本 | 能解释突然的跳变 |
| 保留历史吗? | 保留数月趋势,方法保持稳定 | 方法一改,趋势就断了 |
说不出一个数字背后有多少次运行的厂商,卖的是没有误差线的结果。
| 类型 | 测什么 | 典型输出 |
|---|---|---|
| 提示词抽样追踪 | 针对选定的提示词,模型怎么说你 | 提及率、引用率、位置、情感倾向 |
| 站点侧分析 | AI 系统在你自己网站上做了什么 | 爬虫读取、AI 带来的访问、被引用页面 |
| 内容与公关工具 | 改什么才能被更多提到 | 建议、差距清单 |
只在同一类型内比较工具,不要跨类型比较。
算例:同一个品牌的两份报告
示例数据:工具 A 报告某品牌在一个品类提示词的回答里被提及的比例是 35%。工具 B 针对类似的提示词,报告 52%。经理问哪个是对的。
首先要查运行次数:
- 工具 A:20 次运行里提到 7 次,7 ÷ 20 = 35%,95% 范围 18.1% 到 56.7%。
- 工具 B:100 次运行里提到 52 次,52%,范围 42.3% 到 61.5%。
两个范围在 42.3% 到 56.7% 之间重叠。按这个证据,你不能说两个工具互相矛盾,因为工具 A 的估计太不精确,排除不了工具 B 的数字。接下来检查方法上的差异:
- 工具 B 的提示词里带有产品品类和地区;工具 A 的是中性的。
- 工具 B 运行模型时开了联网搜索;工具 A 没开。
- 工具 A 每周运行一次;工具 B 每天运行并取平均。
三处方法差异加上重叠的范围,就解释了这个差距,谁也没错。合理的决定不是选出赢家,而是固定一份提示词清单、一个入口、每个提示词至少 100 次运行,然后长期跟踪这一个设置下的变化。
同样的 35%,确定程度不同
示例提示词| 运行次数 | 提及次数 | 比率 | 95% 范围 |
|---|---|---|---|
| 20 | 7 | 35% | 18.1% 到 56.7% |
| 100 | 35 | 35% | 26.4% 到 44.7% |
| 200 | 70 | 35% | 28.7% 到 41.8% |
Wilson 95% 区间;范围宽度从 38.6 缩小到 18.3 再到 13.1 个百分点。
怎样按用途选 AI 可见度软件
先定下你需要回答的问题,再套用对应的规则。
| 如果你想知道…… | 找什么 | 先检查什么 |
|---|---|---|
| 针对你的品类提示词,模型是否把你和竞品一起点名 | 提示词抽样追踪 | 每个提示词的运行次数、提示词清单、入口 |
| 哪些 AI 爬虫读了你的网站,读了哪些页面 | 站点侧分析 | 能不能看到不执行 JavaScript 的机器人 |
| AI 助手是否给你带来访客 | 站点侧分析 | 带来的访问是否按真人会话计算 |
| 模型引用了哪些来源而不是你 | 保存被引用网址的追踪工具 | 原始引用能否导出 |
| 该改什么内容 | 内容或公关工具 | 建议是否和测得的差距挂钩 |
给出一个混合“可见度分数”的软件最难评估,因为背后的权重很少说明。优先选能分别定义的单个数字。
如果一个工具无法展示原始回答,就把它的分数当作方向参考,不要当成能向上汇报的测量。如果它展示原始回答和明确的运行次数,你就能自己验证,这比一张精美的图表更有价值。
哪款 AI 可见度软件最准确?
没有独立的准确度基准能给厂商排名,所以任何“最准确”的说法都是厂商自己的。这里的准确度有两个方面:样本在多大程度上代表真实用户会问的问题,以及在给定样本的情况下比率测得有多精确。后一个方面可以像上面那样用算术检查。前一个方面取决于提示词是否反映你的客户真实会问的问题,这只有你自己能判断。要方法说明,用手工运行的二十个提示词样本去测试工具,并读区间。
购买 AI 可见度软件的常见误区
- 跨工具比较分数。 提示词、入口和运行次数不同,数字就不同;在同一个工具内比较变化。
- 忽略误差范围。 20 次运行里从 35% 变到 45%,仍在噪声之内,因为两个范围有重叠。
- 把提及当成引用。 一个是正文里的品牌名;另一个是指向你页面、可能带来访客的链接。
- 相信混合分数。 拆不开的分数,就没法据此行动。
- 只用中性提示词,或只用带品牌的提示词。 中性提示词反映被发现的程度;品牌提示词反映口碑。分开跟踪两者。
- 跳过自己的流量。 AI 系统在你网站上做了什么是可以观察的,而且不存在抽样误差。
TapCub 能看到哪些 AI 可见度数据
TapCub 不是提示词抽样追踪工具。它不向 AI 模型提问,也不计算提及率或情感倾向。它测的是你能直接观察到的部分:AI 系统在你网站上做了什么。
- 看谁在读。 在 网站统计 › 机器人 里打开 AI & agents。AI 内容账本按运营方列出读取次数,训练爬虫和答案引擎分两列,另有它们带回的真人访客,以及读取次数与访客数之比。
- 检查闭环。 AI 可见性 页签把 AI 爬取、AI 带来的访问和爬取到访问之比放在一起,并有按 AI 品牌的表。
- 找到被引用的页面。 被引用页面 列出收到 AI 带来访问的着陆页。网站统计 › 来源 有 AI 来源 页签,它数的是人,不是爬虫。
- 和抽样工具搭配使用。 如果追踪工具说你的品牌被提及得更多了,就来这里看看来自 AI 助手的访问是否也上升了。
- 了解限制。 只用页面脚本时,你只能看到会执行 JavaScript 的机器人;不执行的爬虫需要服务端事件或日志导入。不同的 AI 运营方会用不同的代理来做搜索、训练和用户请求,下结论前先看用途那一列。
常见问题
AI 品牌可见度软件是什么?
报告 AI 助手多常提到或引用一个品牌的软件。多数产品用一组固定的提示词对模型反复运行,报告提及率、引用和情感倾向;也有的转而测量你自己网站上的 AI 爬虫读取和 AI 带来的访问。
最准确的 AI 可见度指标软件是哪款?
没有独立基准给厂商排名,所以“最准确”是厂商的说法。按方法来判断:每个提示词的运行次数、提示词清单、覆盖的入口、提及的定义,以及原始回答能否导出。样本比率为 35% 时,基于 100 次运行的比率,误差范围约为基于 20 次运行的一半。
怎样选 AI 可见度指标平台?
从你要回答的问题出发,不要从功能清单出发。对比竞品需要带明确运行次数的提示词抽样追踪工具;爬虫读取和 AI 带来的访问需要站点侧分析。用你手工运行的二十个提示词,对比工具的输出来测试它。
AI 可见度能精确测量吗?
不能。模型的回答在不同运行、地点和版本之间会变化,所以每个数字都是由样本得出的估计。报告时附上运行次数和区间,小于区间的变化当作噪声。
资料来源
- Edwin B. Wilson。Probable Inference, the Law of Succession, and Statistical Inference,Journal of the American Statistical Association 22(158),1927,95% 范围所用的区间。核对于 2026-11-19(DOI 链接对脚本返回 403)。
- OpenAI。Overview of OpenAI crawlers,用于搜索(OAI-SearchBot)、训练(GPTBot)和用户请求(ChatGPT-User)的不同代理。核对于 2026-11-19。
- Perplexity。Perplexity crawlers,PerplexityBot 用于搜索结果,Perplexity-User 用于用户请求的访问。核对于 2026-11-19。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
