服务端测试是由你的后端选择版本、把做好的页面、接口响应或邮件发出去的实验,而客户端测试是页面加载后在浏览器里改页面。区别在于选择发生在哪里,它决定了闪烁、增加的延迟和能测什么。本文对比两者,给延迟定价(按 Bing 的敏感度,月收入 $400,000 的商店多 150 毫秒就是每月 $3,600),并说明怎么检查分流是否出现样本比例不匹配。
读完你会知道
- 真正的区别只有版本在哪里选出:闪烁、延迟、可测范围和由谁来做都由此而来
- 给延迟定一个数:每 100 毫秒 0.6% 的收入,$400,000 的月份多 150 毫秒是 $3,600;测试前先设延迟预算
- 先查分流:50/50 的测试里 10,300 对 9,700 是卡方 18,属于不匹配;10,050 对 9,950 只是噪声
什么是服务端测试,和客户端测试有什么区别?
服务端测试是由应用后端决定用户拿到哪个版本、并据此生成响应的 A/B 测试(或多变量测试)。客户端测试则是页面先加载,浏览器里的脚本随后再去修改它。真正的区别只有一条:版本是在哪里选出来的。上面对照表里的其他差别都由此而来:加载时变化有多明显、增加多少时间、能测什么、由谁来做。
服务端测试的流程是这样的:
- 请求到达。你的代码用稳定的 ID(用户 ID,或长期有效的匿名 ID)查出或算出这个用户的分组。
- 代码渲染版本 A 或 B,或者运行版本逻辑,比如不同的价格、排序、折扣规则或邮件。
- 代码记录一次曝光:这个用户在这个时间看到了版本 B。
- 之后的事件(购买、注册)与曝光匹配,计算差异。
与之密切相关的是特性开关,也就是对一部分用户打开某个版本的开关。多数服务端测试底层都用到它。开关决定谁看到什么;实验在此之上加上测量和统计。
服务端测试和服务端追踪不是一回事,后者改变的是测量事件从哪里发出。你可以用服务端追踪来做客户端测试,反过来也可以。
| 方面 | 客户端测试 | 服务端测试 |
|---|---|---|
| 在哪里选版本 | 页面加载后在浏览器里 | 在后端,先于响应生成 |
| 闪烁 | 可能出现;隐藏页面是用延迟换闪烁 | 测试本身不引入 |
| 延迟 | 脚本请求和执行 | 查分组;调用远程开关会多一次往返 |
| 能测什么 | 文案、版面、图片、颜色 | 价格、排序、结账逻辑、应用、邮件、接口 |
| 由谁来做 | 市场人员用可视化工具 | 工程师随版本发布 |
| 跨设备一致性 | 靠浏览器 Cookie | 靠用户 ID |
| 准备时间 | 短 | 较长 |
没有哪个在所有情况下都更好;按要改的内容选工具。
客户端测试为什么会闪烁,有多严重?
客户端工具加载后,找到要改的元素,在浏览器已经开始绘制之后再替换。如果页面先显示一下原来的标题、随后换掉,访客就会看到一闪而过的错误内容。常见的补救办法是在脚本跑完之前把页面隐藏起来,这是用一段空白的等待换掉了闪烁。
闪烁同时也是版面问题。Google 的核心网页指标把意外的位移衡量为累计布局偏移(CLS)。一次位移的得分是影响比例 × 距离比例:移动的内容在前后两帧中覆盖的视口比例,乘以移动的最大距离占视口的比例。在 75 分位的页面加载上,0.1 或以下算良好,到 0.25 算需要改进,再高就是差。web.dev 对原因说得很直接:页面加载后注入的内容,尤其靠近顶部的,会造成更大的位移,解决办法是预留空间或者不要插入。
举一个示例数据:一次测试替换了占视口面积 60%(两帧合计)的促销横幅,并让下方内容移动了视口高度的 20%。位移是 0.6 × 0.2 = 0.12,单这一项就落在「需要改进」的区间,还没有加上页面上其他的位移。
服务端测试绕开了这个问题,因为送达的 HTML 本身就是选好的版本,没有替换。这不等于没有版面问题(一个慢的个性化区块仍可能突然冒出来),但测试本身不增加位移。
额外的延迟要付出什么代价?
时间是取舍的另一半,很容易只看到一个方向,漏掉另一个:
- 客户端增加一次脚本请求、执行时间,如果为了防闪烁隐藏页面,还要在任何内容显示之前等待。
- 服务端增加查分组和生成版本的时间。规则放在自己进程里时这很小;要调用单独的开关服务时,每个请求都多一次网络往返。要实测,不要假设。
延迟有多重要?最有名的受控证据来自微软 Kohavi 等人(KDD 2014),他们有意让一部分 Bing 用户变慢。结果是服务端 250 毫秒的延迟使收入下降约 1.5%、点击率下降 0.25%,推算下来每 100 毫秒约 0.6% 的收入。这是一个网站的敏感度,不是定律,但它给了你一个办法来估计自己增加的时间值多少钱:
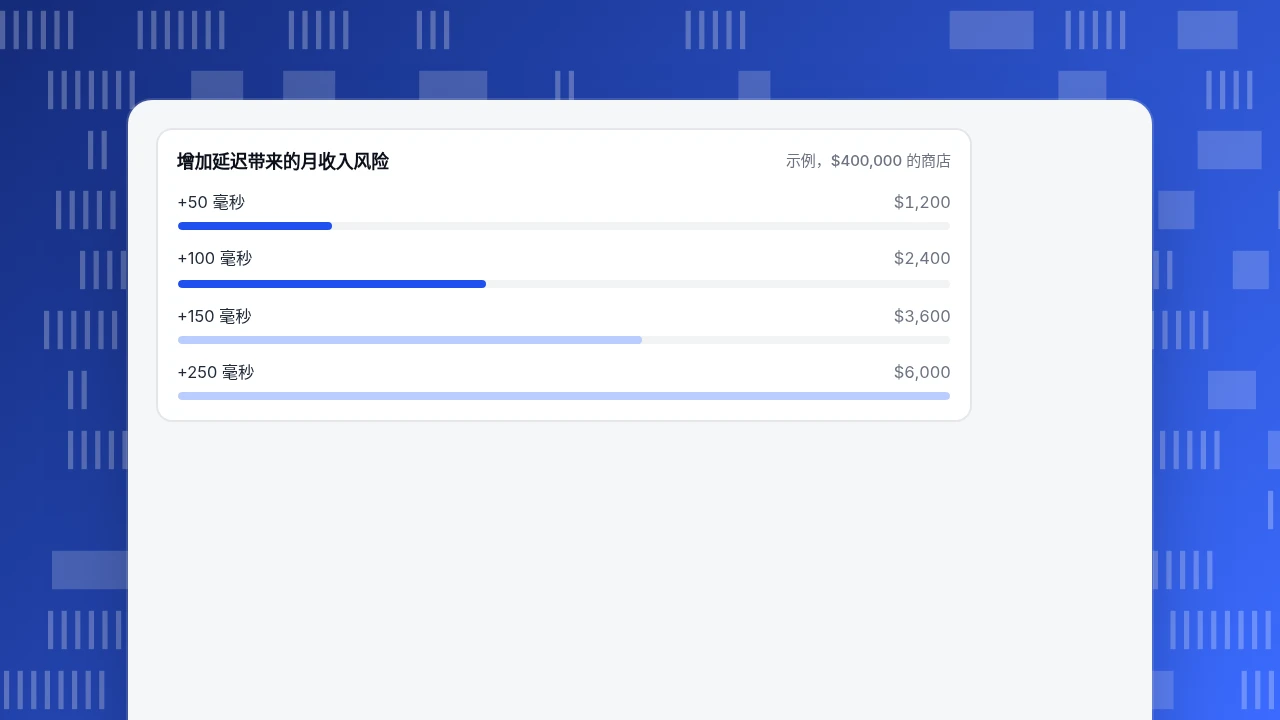
示例数据。 一家商店月收入 $400,000,假设它的敏感度与每 100 毫秒 0.6% 一致。多出 150 毫秒就是 150 ÷ 100 × 0.6% = 0.9%,每月 $3,600。到 250 毫秒,同样的算法得到 1.5%,即 $6,000。图表显示这个范围。把它当作担心的上限,而不是预测:你自己的敏感度可能更低或更高,找出它的办法是在你自己的流量上做一次受控的减速实验。
实用规则:在测试前设一个延迟预算(例如 75 分位上增加不超过 50 毫秒),测试期间把它当作护栏盯着,这样一个「赢了」却更慢的版本不会掩盖它的代价。
增加延迟带来的月收入风险
示例,$400,000 的商店什么时候需要服务端测试,而不是客户端测试?
按要改的内容选工具:
| 想测什么 | 更合适 | 原因 |
|---|---|---|
| 标题、按钮文案、图片、颜色、区块顺序 | 客户端 | 市场人员不用发版就能改 |
| 价格、折扣规则、包邮门槛、结账逻辑 | 服务端 | 逻辑在后端;需要一致性 |
| 搜索排序、推荐、排序方式 | 服务端 | 决定发生在 HTML 生成之前 |
| 移动应用的某个页面或接口响应 | 服务端 | 没有给浏览器脚本去改的页面 |
| 邮件或通知 | 服务端 | 版本由你的发送系统生成 |
| 需要跨设备、跨会话保持一致的东西 | 服务端 | 按用户 ID 而不是浏览器 Cookie 分组 |
| 没有工程时间的快速版面想法 | 客户端 | 最快得到初步答案 |
另外两个约束把测试推向服务端:涉及安全或支付的测试不应依赖浏览器脚本;必须对屏蔽脚本的访客也生效的测试,不能依赖脚本。反方向的代价是:服务端测试需要工程时间和发布流程,启动更慢,也更难交给市场团队。
怎么保证服务端测试可信?
四项检查,按这个顺序做:
- 按稳定的 ID 分组。 用户登录后用用户 ID,登录前用长期有效的访客 ID,让同一个人每次都看到同一个版本。每个会话重新随机,会把两组混在一起。
- 在做决定的那一刻记录曝光,而不是记录页面浏览。 在代码选出版本的瞬间记录版本,带上时间戳和之后的事件所用的同一个 ID。只统计到达某个后续页面的人,会让两组分析的是不同的人群。
- 先查分流,再看结果。 如果计划 50/50,两组人数应该接近相等。显著的差异叫作样本比例不匹配(SRM),用卡方检验可以发现。Fabijan 等人基于四家软件公司、超过 25 个产品的实验经验,把它描述为数据质量问题的症状;存在 SRM 的实验,在找到原因之前,结果不应采信。
- 把机器人挡在外面。 自动化请求也会被分组,而它们很少转化,会稀释两组,还可能对两组的影响不同。从曝光和结果计数里过滤掉已知的机器人。
用数字走一遍 SRM 检查,这是示例数据。计划按 50/50 做测试的 20,000 个用户里,A 组 10,300 人,B 组 9,700 人。每组的期望是 10,000。卡方 =(10,300 − 10,000)² ÷ 10,000 +(9,700 − 10,000)² ÷ 10,000 = 9 + 9 = 18。自由度为 1 时 p ≈ 0.00002,在公平的 50/50 分流下这样的结果极不可能(大约 4.5 万分之一),所以要停下来排查(某个平台上的开关判断不同、某个版本崩溃、缓存只提供了一个版本)。再看 10,050 和 9,950:卡方 = 0.25 + 0.25 = 0.5,p ≈ 0.48,这是正常的噪声,可以继续看结果。
怎么在 TapCub 里衡量服务端测试?
TapCub 不拆分流量、不提供版本,也不做特性开关。这些由你的应用来做;TapCub 衡量之后发生的事。对上面的示例测试,设置方法如下。
- 从服务器为每个用户发送曝光事件。 每个版本用不同的事件名,例如
exposure_a和exposure_b,通过服务端事件接口(POST /api/v1/track),带上相同的login_id,有的话再带上这次访问的session_id,让事件挂到正确的访问上。在 配置 › 设置 › API 密钥里创建带 Server track 权限的密钥。 - 每个版本建一个漏斗。 在 全端分析 › 行为分析 › 行为分析里,建一个第一步是
exposure_a、最后一步是purchase的漏斗;再建一个从exposure_b开始的。第一步的人数就是你的分流,可以据此做 SRM 检查;转化率是结果。 - 统计收入和目标。 在 网站统计 › 目标里定义目标,打开收入统计并填收入属性名,让总额和转化率放在一起。
- 盯住护栏。 在 监测 › 性能里,对比客户端测试上线前后的真实用户核心网页指标。在 全端分析 › 智能运营 › 监控里,给
error_rate或bounce_rate设一个监控;试运行会告诉你过去 30 天会触发几次。每次发布在 配置 › 日期标注里加一个标注,图表上就能看到变化点。 - 带着区间读结果。 TapCub 给你人数和比率。显著性检验和样本量规划留在你的实验工具或电子表格里。
FAQ
用简单的话说,服务端测试是什么?
是由你的后端选择版本、把做好的版本发给用户的实验,所以浏览器里没有替换。逻辑可以小到一个不同的价格,也可以大到不同的搜索排序。
服务端测试比客户端测试好吗?
没有哪个在所有情况下都更好。客户端适合不需要工程的快速视觉和文案改动;服务端适合逻辑、价格、排序、应用和邮件,并且避免闪烁,代价是工程时间。
服务端测试能消除闪烁吗?
测试本身不会引入闪烁,因为 HTML 送达时就是选好的版本。页面其他部分仍可能位移,所以要看累计布局偏移:在 75 分位上 0.1 或以下算良好。
什么是样本比例不匹配?
计划的分组人数和实际得到的人数之间出现显著差距,例如 50/50 的测试里是 10,300 对 9,700。用卡方检验可以发现;把它当作数据质量警报,先找原因再看结果。
服务端测试一定要用特性开关吗?
不是必须,但多数团队用一个来控制谁拿到哪个版本。开关决定曝光;实验在上面加上测量。两者的区别见特性开关术语页。
资料来源
- Kohavi 等,《网站实验者的七条经验法则》,KDD 2014:Bing 的减速实验;250 毫秒约影响 1.5% 的收入(数字读自该论文的摘要解读,核对于 2026-11-20)。
- web.dev,累计布局偏移:0.1 和 0.25 的阈值、75 分位和得分公式。
- web.dev,优化累计布局偏移:注入内容和预留空间。
- Fabijan 等,《在线对照实验中样本比例不匹配的诊断》,KDD 2019:SRM 是数据质量问题的症状;四家公司,超过 25 个产品。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
