产品分析平台把人在你的产品里做的事记录成与某个人绑定的事件,再让你分析漏斗、留存和路径。选它时先查两个地基:事件模型决定你能问什么,身份决定答案说的是人还是设备。本文给出试用清单和一个加权打分算例。
读完你会知道
- 先查事件模型和身份,再看其他功能
- 在第二台设备上登录并数人数,来测试身份
- 试用之前先写下打分权重,因为权重决定谁胜出
什么是产品分析平台?
产品分析平台把人在你的产品里做的事记录成与某个人绑定的事件,并让你把这些事件分析成漏斗、留存、路径和用户分组。它回答页面浏览报表回答不了的问题:引导的哪一步流失了人,用过某个功能的人会不会回来,用户离开之前做了什么。这个词涵盖的范围很宽,从单一的分析工具,到同时打包回放、实验和开关的整套产品。
选择它,主要是检查两个地基和几项能力。两个地基是事件模型和身份:事件模型决定你能问什么,身份决定答案说的是人还是设备。其余的一切,从看板到 AI,都建立在这两样之上。产品分析作为一门学科是什么,见产品分析;怎样决定要追踪哪些指标,见产品分析框架。本文站在买方的角度:查什么、按什么顺序查,以及怎样给查到的东西打分。
事件模型:首先要检查的东西
事件是对「发生了某件事」的记录。在 Mixpanel 的文档里,每个事件有名称、时间戳和一个把它绑定到用户的 distinct ID,还可以带上页面网址或注册类型之类的属性。这种结构在各平台上都很常见,所以有用的问题是:从「发生了某件事」到「得出答案」要花多少功夫。
试用时检查这四件事:
- 能用属性定义一个步骤吗?「新建了项目」是一个事件;「在手机上从模板新建了项目」需要事件上带属性。属性筛选如果很弱,你的漏斗就会停留在含糊的程度。
- 有地方规划事件吗? 没有一份共享的事件名、属性和负责人清单,数据就会漂移成同一件事有三个名字。看看有没有埋点方案或事件字典,以及有没有办法看到哪些事件真正到达了。
- 之后能加事件吗? 有些工具自动记录每次交互,事后再给事件命名;有些只统计你发送的。自动采集省去搭建时间,但需要治理;手动发送需要开发时间,但更干净。决定你愿意付哪种成本。
- 能拿到原始事件吗? SQL 查询、原始导出或数仓同步,是内置报表装不下某个问题时的退路。
容易上手却无法治理的平台,规模一大就是个陷阱。问问看:第十位分析师打开事件列表时会看到什么。
身份:是人,不是设备
身份决定「用户」是不是指人。Mixpanel 的身份文档描述了常见的设计:SDK 生成一个匿名设备 ID,登录之前的事件归在它名下,当你的代码识别出用户后,平台把设备 ID 与用户 ID 关联起来,让它们算作同一个人。没有这层关联,先匿名浏览、然后注册的访客就会显示成两个人。
误差有多大,很容易算。示例数据:这个月有 4,000 人登录,他们合计用了 6,000 台设备或浏览器(平均每人 1.5 个),每个都有自己的匿名 ID。他们一共发送了 240,000 个事件。
| 指标 | 按人计 | 按设备 ID 计 | 误差 |
|---|---|---|---|
| 用户数 | 4,000 | 6,000 | 高估了 6,000 ÷ 4,000 − 1 = 50% |
| 人均事件数 | 240,000 ÷ 4,000 = 60.0 | 240,000 ÷ 6,000 = 40.0 | 低估了 1 − 40 ÷ 60 = 33.3% |
| 第 7 天留存 | 1,000 ÷ 4,000 = 25.0% | 1,200 ÷ 6,000 = 20.0% | 在另一台设备上回来的人被算成流失 |
关于身份要问的问题:
- 有合并吗,由什么触发? 通常是一次登录或注册调用。检查两个人共用一台设备、以及一个人在新手机上登录时会发生什么。
- 有没有无法识别的人? 匿名访客通常没有档案。这没问题,但要看他们在报表里怎样出现。
- 人之上还有一层吗? B2B 产品需要账户(公司、工作区)。检查分析能否按账户分组。
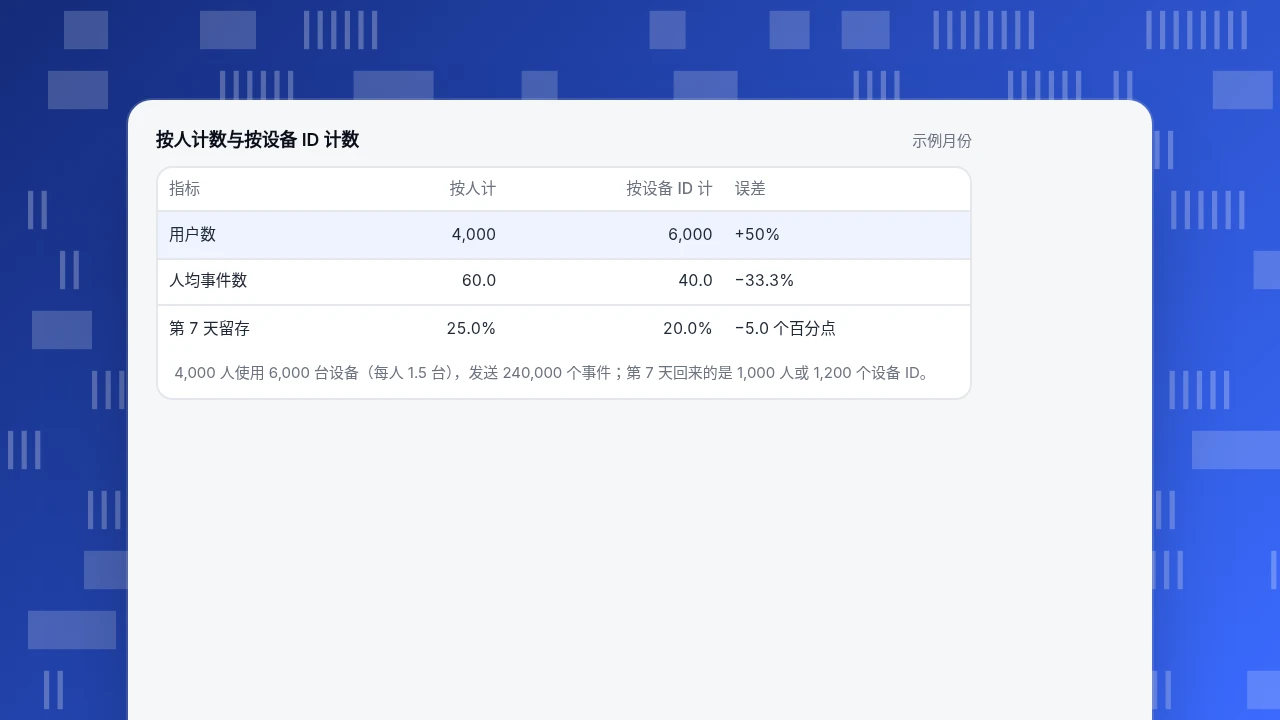
按人计数与按设备 ID 计数
示例月份| 指标 | 按人计 | 按设备 ID 计 | 误差 |
|---|---|---|---|
| 用户数 | 4,000 | 6,000 | +50% |
| 人均事件数 | 60.0 | 40.0 | −33.3% |
| 第 7 天留存 | 25.0% | 20.0% | −5.0 个百分点 |
4,000 人使用 6,000 台设备(每人 1.5 台),发送 240,000 个事件;第 7 天回来的是 1,000 人或 1,200 个设备 ID。
选型清单,以及试用时该问什么
把这张表当作试用一周的脚本。每一行都有一个通过动手就能回答的问题,而不是靠读功能介绍页。
| 能力 | 试用时要跑的问题 | 警示信号 |
|---|---|---|
| 事件模型 | 建一个第二步带属性筛选的漏斗 | 需要开发人员或导出才能做到 |
| 身份 | 在第二台设备上登录,看人数 | 被算了两次 |
| 分析深度 | 用同一批事件建漏斗、留存和路径 | 每个都要单独搭建 |
| 分群 | 保存一组用户,在两个分析里复用 | 每次都要手工重建 |
| 数据治理 | 找到计划事件清单,看哪些已到达 | 没有清单,或无法核对到达情况 |
| 数据获取 | 跑一个查询,或导出原始事件 | 只有图表截图 |
| 隐私 | 找到同意和保留期设置 | 不可配置,或没有文档 |
| 成本模型 | 估算流量翻倍时的月账单 | 无法预测 |
成本这一行,事件量按月活跃用户 × 人均事件数来估算。以上面的示例,4,000 × 60 = 每月 240,000 个事件;如果用户翻倍并加了更丰富的追踪,则是 8,000 × 90 = 720,000。定价常常与事件数或用户数挂钩,所以无法预测的模型就是风险。
算例:用权重给两个平台打分
示例数据:一个团队按六项标准给两个不具名的平台打 1 到 5 分,并按重要性给每项标准加权。加权得分 = Σ(权重 × 得分) ÷ 100。
| 标准 | 权重 | 平台 A | 平台 B |
|---|---|---|---|
| 事件模型 | 25 | 4 | 3 |
| 身份 | 25 | 3 | 5 |
| 分析深度 | 20 | 5 | 4 |
| 数据治理 | 15 | 2 | 4 |
| 数据获取 | 10 | 4 | 3 |
| 隐私与成本 | 5 | 3 | 4 |
| 加权得分 | 100 | 3.60 | 3.90 |
平台 A:(25 × 4 + 25 × 3 + 20 × 5 + 15 × 2 + 10 × 4 + 5 × 3) ÷ 100 = 360 ÷ 100 = 3.60。平台 B:(75 + 125 + 80 + 60 + 30 + 20) ÷ 100 = 3.90。
是权重决定了结果。如果团队把分析深度的权重定为 30、身份定为 15,平台 A 的得分就是 (100 + 45 + 150 + 30 + 40 + 15) ÷ 100 = 3.80,平台 B 是 (75 + 75 + 120 + 60 + 30 + 20) ÷ 100 = 3.80,打成平手。所以试用之前先把权重写下来,问问谁有不同意见,并先在权重高的标准上做试用。打分是让分歧变得可见,而不是结束分歧。
怎样做一次两周试用
- 选五个你真正有的问题,比如「新用户在哪里卡住?」和「用过功能 X 的人会回来吗?」。平台答不出这些问题,再长的功能清单也没用。
- 给一个真实流程埋点,不要用演示数据。发送带属性的引导事件,并在登录时识别用户。
- 用数据回答这五个问题,并记录每个花了多长时间。注明哪些需要别人帮忙。
- 用你信得过的数据源核对数字,比如数据库里的订单。小差距正常;大而无法解释的差距本身就是发现。
- 请团队里的另一个人在没有你帮助的情况下重做一个分析。 如果他做不到,推广就会停滞。
| 检查项 | 它决定什么 | 不过关会怎样 |
|---|---|---|
| 事件模型 | 你能问什么问题 | 没有属性筛选,漏斗就停留在含糊的程度 |
| 身份 | 用户是人还是设备 | 出现重复的人和错误的留存,却没有任何报错 |
| 数据治理 | 事件命名能否保持一致 | 同一个事件有三个名字 |
| 数据获取 | 能否走出内置报表 | 问题不合内置报表时卡住 |
| 成本模型 | 账单是否可预测 | 流量翻倍时出现意外 |
每一项都在试用时用你自己的事件来检查,而不是用演示数据集。
选产品分析平台时的常见误区
- 按功能数量选。 清单一长,就看不出核心(事件和身份)是否真的好用。
- 跳过身份测试。 重复的人是无声的:没有报错,只有错误的数字。
- 一次给所有东西埋点。 先从一个流程和一份埋点方案开始。
- 不考虑谁来用。 只有分析师会用的工具,不会改变产品决策。
- 把演示数据集当证据。 用你自己的事件来试用。
- 忘了成本会增长。 在承诺之前,估算流量翻倍时的账单。
在 TapCub 里:网站、App 和小程序事件放在一个项目里
照上面的清单来看。TapCub 这样回答其中各行,以及它没有覆盖的部分。
- 事件。 从网站脚本、iOS、Android、Flutter、React Native 或鸿蒙 SDK 发送自定义事件,或从服务端通过 HTTP 发送。脚本还默认采集外链点击和文件下载。新事件先出现在 全端分析 › 数据管理 › 事件收件箱,认领后才进入正式定义。
- 规划与检查。 在 全端分析 › 数据管理 › 埋点方案 里记录计划事件,带负责人和状态,再打开实时验证(近 24 小时),看到达情况和必填属性的完整度。属性字典 把属性含义集中在一处。
- 身份。 用户登录时调用
tapcub.login,他们之前的匿名活动就合并到 全端分析 › 用户 › 用户 里的同一个人名下,并有按天排列的时间线。匿名访客没有档案。对于 B2B,tapcub.group('company', ...)提供带 0–100 健康分的账户视图。 - 分析。 全端分析 › 行为分析 › 行为分析 包含漏斗、留存、路径、分布、生命周期和归因;分群与标签 里的分群可以带进这些分析。自定义指标与 SQL 用来定义你自己的指标,并对事件数据运行 SQL。
- 数据获取与隐私。 数据管理 › 数据导出 做异步的原始导出。配置 › 合规中心 管理采集档位、保留期和数据主体请求。
TapCub 不做 A/B 测试、特性开关和问卷;它衡量你上线之后发生了什么。产品团队怎样使用这些报表,见产品经理的数据分析。
FAQ
什么是产品分析平台?
产品分析平台把人在你的产品里做的事记录成与某个人绑定的事件,并让你把它们分析成漏斗、留存、路径和用户分组。它回答关于产品内部行为的问题,比如引导在哪里流失了人,或者某个功能能否把用户带回来。
产品分析平台应该有哪些功能?
带属性的事件模型,登录后能把匿名活动关联到某个人的可靠身份,漏斗、留存和路径分析,可复用的分群,治理事件命名的办法,以及通过 SQL 或导出获取原始数据。隐私设置和可预测的成本模型同样重要。
怎样选择产品分析平台?
按加权标准给候选者打分,然后在一个真实流程上做两周试用。在第二台设备上登录来测试身份,建一个带属性筛选的漏斗,并请同事重做一次分析。在示例里,仅权重就改变了赢家,所以要先对权重达成一致。
产品分析和网站分析有什么不同?
网站分析围绕页面、会话和流量来源。产品分析围绕产品内部的事件和人,所以能跨会话、跨设备跟踪同一个人。两者有重叠;TapCub 把网站、App 和小程序的数据放在一个项目里,用同一套事件和用户模型。
另见:数据分析平台:分层、形态与怎么选。
资料来源
- Mixpanel。Events and properties:事件有名称、时间戳和 distinct ID,并可带属性。2026-11-19 核对。
- Mixpanel。Identifying users with simplified ID merge:登录后把匿名设备 ID 与用户 ID 关联,让同一个人只算一次。2026-11-19 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
