关键词分组是把一长串搜索词分成若干组,让每一组由一个页面来承接。按搜索意图分组,也就是看 Google 是否给这些词展示同一批页面,而不是看共用的字:意图相同的一组词对应一个页面,而不是一词一页。下面讲三种方法、四个步骤,以及一个分成六组的 20 词算例,每个重叠数都列出来。
读完你会知道
- 按搜索结果重叠分组,不按共用的字:算例里 20 个词有 14 个含「heatmap」,却分进了六个不同的组
- 选一个重叠阈值(算例用 10 个网址里共有 4 个),写下来,对每个词都用同一个
- 页面上线之后,检查这一组的查询词是否出现在这个页面上,以及你的两个页面有没有共有同一个查询词
什么是关键词分组?
关键词分组(keyword grouping)是把一长串搜索词分成若干组,让每一组由一个页面来承接。分组不是看这些词共用了哪些字,而是问:输入这些词的搜索者想要的是不是同一样东西,最直接的证据,就是 Google 给它们展示的是不是同一批页面。「heatmap for website」和「website heatmap」字面相近、结果也相近;「how to make a heatmap」和这两个词共用「heatmap」,但在下面的算例里返回的是完全不同的一批页面,因为搜它的人想要的是表格教程。
你还会看到关键词聚类(keyword clustering),在大多数 SEO 文章里意思相同;有些作者把「聚类」专门留给自动化的、基于搜索结果重叠的那一种。维基百科的关键词聚类词条,把基于词本身的方法和基于搜索结果(SERP)的方法分开,本文主要用后一种,因为只有它能告诉你,一个页面能不能同时排上整组词。
本文主张的规则是:意图相同的一组词对应一个页面,而不是一个词一个页面,分组依据是结果页,而不是拼写。 方法分四步,后面跟着一个 20 个词、可以复算的算例。如果你已有的两个页面在争同一批词,那就是分组本来要避免的问题;修复办法在关键词蚕食里。
为什么按意图分组,而不是按字面?
把一份 500 个词的清单变成内容计划,会出现两种失败。
页面太多。 一词一页,会产生近似重复的页面:「heatmap for website」「website heatmap」和「heat map website」变成三个答案相同的单薄页面。它们互相分散链接和点击,是蚕食最常见的原因。
页面太少。 一个「关于热力图的一切」页面,范围宽到回答不好任何一个问题。它既要解释热力图是什么,又要讲怎么在 Excel 里做,还要列工具,结果是哪个词都排不上。
按搜索结果重叠分组,落在这两者之间。如果两个词排名靠前的页面大部分重叠,同一个页面就能回答两者,它们应该放在一起。如果几乎不重叠,Google 已经把它们当成不同的问题,单独建一个页面就有道理。这是对搜索结果的检验,而不是一种观点。
在所有这些之前,还有一个过滤:先把品牌词和其他词分开,它们通常对应首页或产品页,不需要分组。见品牌词和非品牌词。
关键词分组的三种方法
| 方法 | 按什么分组 | 优点 | 缺点 | 什么时候用 |
|---|---|---|---|---|
| 字面 | 共用的词或词干 | 快,不需要数据 | 会拆开同义词,看不出意图;「heat map」和「heatmap」被分到两边 | 对特别长的清单做第一轮粗分 |
| 主题(语义) | 词的含义,由人或语言模型判断 | 能处理同义词和语序 | 不能告诉你 Google 是否认同 | 规划一个主题领域和它的子页面 |
| 搜索结果意图 | 每个词排名靠前页面的重叠 | 直接告诉你一个页面能不能同时服务两个词 | 每个词都要有一份结果清单;结果会变 | 对重要的词决定一组一页 |
好的流程大多按顺序三种都用:字面用来清理清单,主题用来提出分组,搜索结果重叠用来确认或拆开。把搜索结果这一步花在判断出错代价高的地方,例如有真实搜索量的词,或者你马上要写的页面对应的词。
怎么分四步给关键词分组?
- 收集并清理清单。 从关键词工具、搜索表现数据和销售或客服的问题里收集词。去掉重复,合并明显的拼写变体(「heatmap」和「heat map」),把品牌词放到一边。每个词旁边保留月搜索量。
- 记录每个词的前 10 个结果。 对每个词,写下同一个国家、同一种语言下前十个自然结果的网址。所有词用同一天的数据。很多关键词工具可以导出这些;清单短的话,手动查也行。
- 测量重叠,形成分组。 取搜索量最高的词作为一组的组头。把其他每个词和组头比较,数前 10 里共有多少个网址。如果达到你定的阈值(下面的算例用 10 个里 4 个),就加入这一组。如果和任何已有的组头都不匹配,它就成为新的组头。按搜索量从高到低处理。
- 给每组分配一个页面。 判断是已有页面覆盖了这一组、需要扩充,还是要新写。把组头词定为目标,把其他词列为同一页面应当回答的次要词,用小标题或 FAQ 来回答。
阈值是一个选择,不是定律。数字低,分组更宽松,得到的页面更少、更宽;数字高,更严格,得到的页面更多。整个项目选一个数字,记下来,前后一致地用。
| 共有网址数(共 10) | Jaccard 指数 | 算例里的决定 |
|---|---|---|
| 0–2 | 0.00–0.11 | 分开成不同页面 |
| 3 | 0.18 | 分开,低于阈值;以后复查 |
| 4–5 | 0.25–0.33 | 同一组 |
| 6–8 | 0.43–0.67 | 同一组,匹配很强 |
共有 4 个网址的阈值是这个算例的选择,不是规则。
算例:20 个词分成 6 组
示例数据:围绕「heatmap」的 20 个词,每个词有一个虚构的月搜索量和一份虚构的前 10 结果,这样重叠数可以重新核对。规则就是第 3 步的规则:搜索量高的先处理,和组头共有至少 4 个网址(共 10 个)就加入这一组,否则新开一组。重叠也可以写成 Jaccard 指数:共有网址数 ÷ 两份清单里不同网址的总数,所以两份各 10 个、共有 4 个时,是 4 ÷ 16 = 0.25。
| 分组(组头词) | 组头搜索量 | 其他词,以及和组头共有的网址数 | 组总搜索量 |
|---|---|---|---|
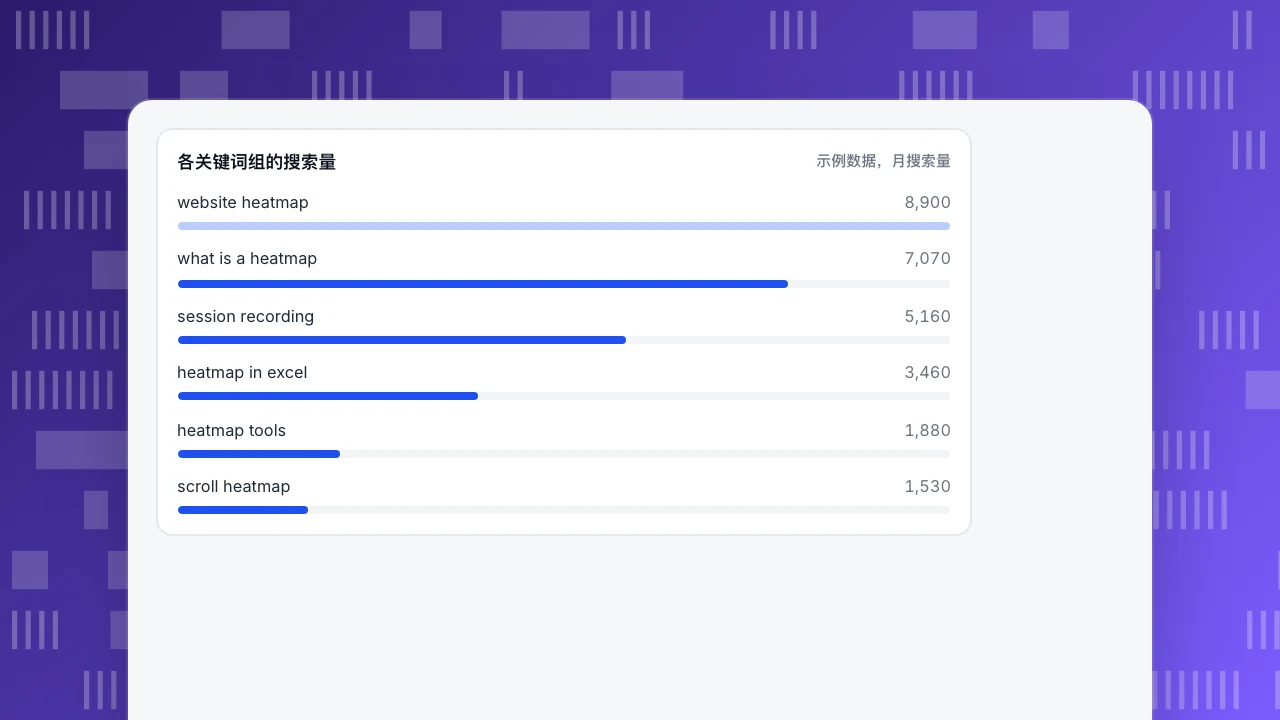
| website heatmap | 5,400 | heatmap for website(7)、heat map website(6)、click heatmap(5) | 8,900 |
| what is a heatmap | 4,400 | heatmap meaning(7)、how to read a heatmap(6)、heatmap analysis(5) | 7,070 |
| session recording | 2,900 | session replay(7)、user session recording(6)、heatmap vs session recording(5) | 5,160 |
| heatmap in excel | 1,900 | how to make a heatmap(8)、excel heat map tutorial(6) | 3,460 |
| heatmap tools | 1,400 | heatmap software(6) | 1,880 |
| scroll heatmap | 1,000 | scroll depth heatmap(7)、scroll map(6) | 1,530 |
各组搜索量相加:8,900 + 7,070 + 5,160 + 3,460 + 1,880 + 1,530 = 28,000,正好是 20 个词的总搜索量,没有漏掉任何词。例如首组是 5,400 + 1,900 + 880 + 720 = 8,900。
算例里有四个决定,说明为什么搜索结果这一步很重要。
- 「how to make a heatmap」跟 Excel 在一起,而不是跟「website heatmap」。 从字面看它像个网站热力图的词,但它和「website heatmap」共有 0 个网址,和「heatmap in excel」共有 8 个。搜它的人想要的是表格教程。
- 「heatmap tools」单独成组。 它和「website heatmap」共有 3 个网址,低于阈值 4(Jaccard 3 ÷ 17 = 0.18),因为它的结果是产品清单。它需要自己的页面类型。
- 「scroll heatmap」是单独的一组。 它和「website heatmap」只共有 1 个网址。滚动深度是它自己的问题,有自己的结果。
- 「heatmap vs session recording」归入「session recording」。 它和后者共有 5 个网址(Jaccard 5 ÷ 15 = 0.33),和「website heatmap」一个也不共有,尽管它含有「heatmap」这个词。
对比一下字面方法。按「含有 heatmap 这个词」分组,20 个词里有 14 个堆在一起,而「heat map website」和「excel heat map tutorial」仅仅因为多了个空格就被分到别处。按搜索结果分,得到六组,每组 2 到 4 个词,每组就是一份页面简报。
各关键词组的搜索量
示例数据,月搜索量阈值设在哪里,边界情况怎么办?
算例用的是 10 个里 4 个。有三种情况,要靠判断而不是公式。
结果会变。 排名会动,重叠也会动。对共有网址在 3 或 4 个上下的词,在把页面押给它们之前重新拉一遍清单;成员之间共有 5 个及以上的组,翻转的可能性更小。
意图混合的结果。 有些词返回的是多种形式的混合:几篇指南、几个产品页、一个视频。一个词的前 10 和两个不同的组重叠程度相当,说明两种意图共用一个结果页。把它分到你的页面类型匹配的那一组,并在另一组里提到它。
组头不一定是最合适的页面标题。 选搜索量最高的词当组头,简单、通常也好用,但如果它的措辞很怪,就让最清楚的词做页面标题,把组头保留为次要词。分组决定哪些词在一起;给页面起名,是另一个编辑决定。
当一组很大,超过大约 10 个词,把它里面重叠最低的成员彼此对比,而不只是和组头对比,看它是不是藏着两种意图。
关键词分组的常见误区
- 按共用的词分组。 在算例里,字面规则把 14 个词放进一组,还会把「how to make a heatmap」送到一个并不回答它的网站热力图页面。
- 用不同日期或不同国家的结果。 只有每份清单都取自同一个市场、同一天,重叠才有可比性。
- 把阈值当真理。 10 个里 4 个是这个算例的约定。选一个,写下来,全程使用。
- 忘了品牌词。 它们会扭曲搜索量,也很难分组;先过滤掉。
- 从不回头复查分组。 结果会变。页面流量下降时,或者在同一领域新增页面时,复查分组。
- 仍然一词一页。 分组只有变成一个页面、把次要词当小标题或 FAQ 来回答,才有用。
- 以为分组决定标题。 分组只说明哪些词属于一起。标题仍然要为读者来写,已有页面能不能承接这一组,由内容审计来判断:见内容审计。
怎么用搜索表现数据检查分组?
分组是一个预测:「这一个页面能排上这些词。」Google Search Console 的搜索表现数据展示实际发生了什么。表现报告列出点击、展现、点击率和平均排名,可以按查询词和页面拆开,所以每组的页面都能和它的这一组对照。
页面上线几周之后,做三个检查:
- 这一组的词,出现在这一组的页面上了吗? 看给页面带来展现的查询词。如果这一组大多数词都在,分组有效。如果某个词只出现在另一个页面上,它的意图可能属于那个页面。
- 两个页面共有一个词吗? 同一个查询词给你的两个页面都带来展现,就是蚕食的特征;合并页面,或者让它们的目标更清晰。见关键词蚕食。
- 排名不错,点击率却低? 排在前 10 的页面,点击率低于正常水平,通常需要更好的标题或描述,而不是换一个分组。正常水平大概是多少,见自然搜索点击率,把结果怎么排版见关键词表现报告。
在 TapCub 里怎么检查一个关键词分组
TapCub 不是关键词研究工具:它没有搜索量,也没有搜索结果清单,所以上面的四步要在别处完成。它补上的是之后的检查:把每个分组对照真实的搜索数据,和页面上的真实行为。
- 连接搜索账号。 打开监测 › 搜索表现,按提示连接 Google Search Console 或 Bing Webmaster。没有连接账号时,页面没有点击和展现,这不等于流量为零。百度没有点击和展现的接口,所以不能这样连接。
- 读表现报告。 它显示点击、展现、点击率和平均排名,按页面、查询词和国家拆开,数据一般晚 1 到 3 天。页面会写明数据更新到哪一天。
- 把分组和它的页面对照。 在页面拆分和查询词拆分之间切换,看这一组的哪些词给哪个页面带来了展现,以及同一个查询词是否出现在两个页面下。
- 找出最值得先调的分组。 排名分档按展现加权,把查询词按平均排名分组;散点图把每个页面画成一个点,大小是展现。排在前 10、点击率低于中位数的页面会被标出来:先改它的标题和描述。
- 加上行为。 在网站统计 › 页面里打开这个页面,看访客到达之后怎么表现。一个分组可以排名不错,却仍然让人失望,如果页面回答的是另一个问题,而不是词所暗示的那个。
- 知道边界。 TapCub 不会建议分组,不估算搜索量,也不检查搜索结果重叠;它展示你选的分组表现如何。
FAQ
SEO 里的关键词分组是什么?
关键词分组是把一长串搜索词分成若干组,每组由一个页面承接。搜索者想要同一样东西的词放在一起,可以用 Google 是否对它们返回大体相同的页面来检验。它既避免近似重复的页面,也避免一个范围过宽的页面。
关键词分组和关键词聚类有什么区别?
在大多数 SEO 文章里,两者是一回事。有些作者用「聚类」指自动化的、基于搜索结果重叠的方法,用「分组」指任何给词分类的办法,包括手动的或按主题的。重要的是你用什么检验来判断两个词属于一起。
一组里应该有多少个关键词?
没有固定数字。在算例里,每组有 2 到 4 个词。如果一组超过大约 10 个词,把重叠最低的词彼此对比,看它是不是藏着两种意图。组的大小取决于有多少词共享结果,而不是一个目标。
怎么按搜索意图给关键词分组?
对每个词列出前 10 个结果,取搜索量最高的词作为组头,数和它共有的网址。共有数达到你定的阈值(例如 10 个里 4 个)的词加入这一组,其余的新开一组。然后每组分配一个页面。
给关键词分组一定要用工具吗?
清单短的话不用。一张表格,每个词十个网址,再数共有的网址,20 或 30 个词就够了,就像算例里那样。几百个词的话,能自动拉结果并聚类的工具能省时间,但阈值仍然由你定,分组也要由你复查。
资料来源
- 维基百科。Keyword clustering:给搜索词分组的方法,包括基于搜索结果的聚类。核对于 2026-11-18。
- 维基百科。Jaccard index:两个集合的共有项数除以不同项的总数,上文用它表示重叠。核对于 2026-11-18。
- Google Search Console 帮助。Performance report (Search):点击、展现、点击率和平均排名,可按查询词和页面分组。核对于 2026-11-18。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
