数据分析计划,是在看到结果之前写下的一页说明:问题、指标、数据和时期、对比、分群、检验和决策规则。先写,能防止各个选择朝着你希望的答案漂移。下文给出八行模板,用注册下降(4.0% 到 3.2%)的例子填好并真算一遍。
读完你会知道
- 在打开数据之前写好问题、指标、对比、分群、阈值和决策规则,任何改动都要记下原因
- 提前定好分群清单:在 0.05 下检验 20 个拆分,至少一次误报的概率是 64.2%
- 每份计划都要挂一个决策;没有决策规则的分析,结局是一张图,不是一个改变
什么是数据分析计划,为什么要在看数据之前写?
数据分析计划,是在你看结果之前写下的一份简短说明:要回答哪个问题、用哪些数字、怎样比较,以及根据答案会做什么。先写很重要,因为数据一旦打开,每个选择(哪个时期、哪个分群、哪种检验)都可能被不自觉地推向你希望的答案。
美国疾控中心(CDC)的评估指南把时机说得很直白:在「实施之前」就计划好数据分析和解读,分析计划至少写明要分析的数据、要做的分析、何时做、由谁做。分析之后,它要求你检查是否遵循了计划,并「记下你在哪些地方偏离了原计划,以及原因」(CDC)。整个纪律就是这两句话:先决定,再记录偏离。
本文给出一份一页纸就能填完的计划模板,再用一个常见问题填一遍:注册掉了,为什么?分析本身的步骤,见如何分析数据;把结果写成文档,见数据分析报告。
一页纸的数据分析计划包含什么?
八行。每行回答一个问题,留空的一行就是你还没做的决定。
| 行 | 回答什么问题 | 薄弱的写法 | 扎实的写法 |
|---|---|---|---|
| 1. 问题 | 我们想弄清什么? | 「看看注册」 | 「11 月 3 日的发版之后注册率是否下降,对谁下降?」 |
| 2. 决策 | 答案拿来做什么? | 没有 | 「如果确认且集中,本迭代安排修复」 |
| 3. 指标 | 到底数什么? | 「注册」 | 「注册数 ÷ 不重复访客,同一时区」 |
| 4. 数据和时期 | 来自哪里、哪些日期? | 「最近的数据」 | 「统计数据,第 1–4 周对第 5–8 周」 |
| 5. 对比 | 和什么比? | 「之前」 | 「前四周对后四周」 |
| 6. 分群 | 现在就定好哪些拆分? | 「看起来有意思的都拆」 | 「只按设备(手机、桌面)拆,共两种」 |
| 7. 方法和阈值 | 用哪种检验,怎样才算真的? | 「看着显著」 | 「两比例 z 检验,α = 0.05 分摊到各分群」 |
| 8. 决策规则和负责人 | 谁在什么结果下行动? | 「讨论」 | 「只有手机掉了,负责人 A 开修复单」 |
第 2 行和第 8 行是人们最常跳过的,却是让计划有用的两行:没有挂决策的分析,产出的是一张图,不是一个改变。
算例:为注册下降填好的计划
示例数据:11 月 3 日发版之后,注册看起来变少了。下面是在打开任何分群之前写好的计划。
| 行 | 内容 |
|---|---|
| 问题 | 11 月 3 日发版之后注册率是否下降,对谁下降? |
| 决策 | 下降属实且集中在一种设备,本迭代安排修复;均匀分布,则先查流量质量 |
| 指标 | 时期内 注册数 ÷ 不重复访客(两边同一口径) |
| 数据和时期 | 统计数据,第 1–4 周(前)对第 5–8 周(后) |
| 对比 | 前四周对后四周,星期对齐 |
| 分群 | 只按设备:手机和桌面(共两种) |
| 方法和阈值 | 带合并估计的两比例 z 检验;总体 α = 0.05,所以两个分群各用 0.025 |
| 决策规则和负责人 | 只有手机:网站负责人开修复单。两者都掉:产品负责人复查流程。都没掉:关闭事项。 |
方法这一行沿用 NIST 手册里的大样本检验:设样本一有 n₁ 个里 x₁ 个、样本二有 n₂ 个里 x₂ 个,合并比例是 (x₁ + x₂) ÷ (n₁ + n₂),z 是差值除以 √(p̂(1 − p̂)(1/n₁ + 1/n₂))(NIST 工程统计手册,7.3.3)。正态近似适用于样本相当大时,小样本 NIST 建议改用 Fisher 精确检验。
按计划运行后,结果是什么?
计数如下,全部是示例数据:
| 分群 | 前:访客 | 前:注册 | 前:比率 | 后:访客 | 后:注册 | 后:比率 |
|---|---|---|---|---|---|---|
| 手机 | 13,000 | 468 | 3.60% | 16,000 | 416 | 2.60% |
| 桌面 | 18,000 | 772 | 4.29% | 17,000 | 640 | 3.76% |
| 全部 | 31,000 | 1,240 | 4.00% | 33,000 | 1,056 | 3.20% |
把计划里的检验逐步算一遍,先算总体。合并比例:(1,240 + 1,056) ÷ (31,000 + 33,000) = 3.5875%。标准误:√(0.035875 × 0.964125 × (1/31,000 + 1/33,000)) = 0.1471 个百分点。差值:4.00% − 3.20% = 0.80 个百分点。所以 z = 0.80 ÷ 0.1471 = 5.44,双侧 p 值约为 5 × 10⁻⁸。总体下降是真实的,而且相对幅度很大:每个访客的注册少了 20.0%。
再看预先定好的分群,各自对照 0.025 的阈值:
- 手机:3.60% 降到 2.60%,z = 4.93,p ≈ 8 × 10⁻⁷。显著。
- 桌面:4.29% 降到 3.76%,z = 2.49,p ≈ 0.013。在 0.025 下显著。
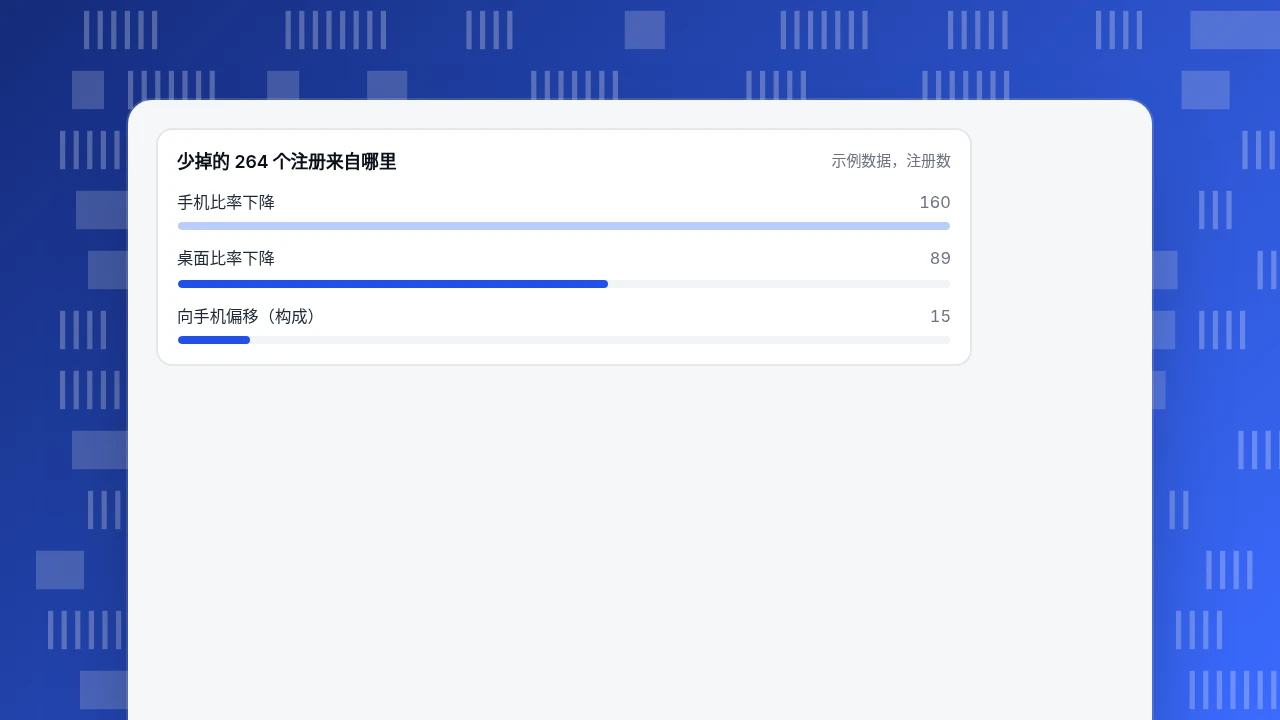
计划里没写、但细心的分析者会补的一项检查是构成。手机访客占比从 41.9% 升到 48.5%,而手机转化更差,所以下降里有一部分是构成变化。把 0.80 个百分点的下降拆开:比率效应(各分群比率变化,按后期构成加权)是 −0.755 个百分点,构成效应是 −0.045 个百分点,合计 −0.80。折成注册数:手机少了 160 个(1.00 个百分点 × 16,000),桌面少了 89 个(0.52 个百分点 × 17,000),构成约占 15 个,合计 264 = 0.80 个百分点 × 33,000。决策规则说两种设备都掉了,所以由产品负责人复查流程,先看手机,因为它少掉的注册几乎是桌面的两倍。
少掉的 264 个注册来自哪里
示例数据,注册数为什么要在看之前选好分群?
每多拆一刀,噪声被当成发现的机会就多一次。如果你在 α = 0.05 下检验 k 个独立的拆分,仅凭运气至少有一个「显著」的概率是 1 − 0.95^k:
| 检验的拆分数 | 至少出现一次误报的概率 |
|---|---|
| 1 | 5.0% |
| 5 | 22.6% |
| 10 | 40.1% |
| 20 | 64.2% |
最简单的修正是 Bonferroni:用 α 除以这一组比较的个数。美国教育统计中心(NCES)的技术文档给出同样的算术:四次比较时 α = 0.05 ÷ 4 = 0.0125,并指出比较个数从 1 增加到 4 时,临界值从 1.960 升到 2.498,提高了 27.4%(NCES)。在算例里,桌面的 p 值 0.013 通过了计划里 0.025 的阈值。如果事后切成四种拆法,它就过不了 0.0125 的阈值。同样的数据,不同的结论:这就是为什么分群清单要先写。
| 在 α = 0.05 下检验的拆分数 | 至少一次误报的概率 | 每个拆分的 Bonferroni 阈值 |
|---|---|---|
| 1 | 5.0% | 0.0500 |
| 5 | 22.6% | 0.0100 |
| 10 | 40.1% | 0.0050 |
| 20 | 64.2% | 0.0025 |
误报概率 = 1 − 0.95^k(k 个独立拆分);阈值是 α ÷ k,即 NCES 描述的 Bonferroni 方法(2026-11-20 核对)。
多少数据才够?
计划应该写明值得行动的最小变化,以及能检出它的样本量。用标准的两比例近似,在 α = 0.05、检验效能 80% 下,要检出从 4.0% 降到 3.2%,每个时期约需 8,511 个访客。算例里有 31,000 和 33,000,足够。要检出从 4.0% 降到 3.6%,每个时期约需 35,864,比两个时期的数据都多,所以这么小的下降,当时是检不出来的。把你愿意行动的最小变化写进第 7 行;数据检不出来,就在开始之前延长时期,而不是之后。
计划和数据对不上怎么办?
会遇到三种情况,计划里每种都该有一行:
- 结果明显对应决策规则的某个分支。照做,结束。
- 出现了计划之外、看起来有意思的东西。标成探索性发现,单独写下来,不要声称显著。另外计划一次有自己阈值的后续检验。
- 必须改计划。在分析之前书面修改,写明原因,并告诉将使用结果的人。CDC 的清单要求的就是这个:记下偏离及其原因,并在分析开始前共享这个变更。
数据分析计划的常见错误
- 没挂决策。没有决策规则的计划,结局是一场讨论,不是一个行动。
- 指标定义了两次。「注册率」这周用访客、下周用会话,会造出一个假的下降。
- 对比不同类的时期。节假日那周对普通那周,不是前后对比。
- 事后切分。见误报概率表。
- 忽略构成。分群占比的变化会表现得像比率变化,15 个注册的构成效应就是例子。
在 TapCub 里如何执行这份计划
上面的算例用的计数,TapCub 可以直接提供。检验本身,用上面的公式在表格里几格就能算。
- 确认事件在正常到达。在 全端分析 › 数据管理 › 埋点方案 里,检查注册事件在列表中,并且在打开实时验证后,它最近的到达数和必填属性看起来完整。事件坏了,看起来就像下降。
- 建两次漏斗。在 全端分析 › 行为分析 › 行为分析 里,分别为第 1–4 周和第 5–8 周建注册漏斗,一次一个时期,再把两个结果并排放。每次运行给出各步人数和步转化率。
- 按设备拆。给每次运行加一个设备筛选,得到表里手机和桌面的计数。
- 标记发版。在 配置 › 日期标注 里给 11 月 3 日加一条标注,让读趋势的人看到计划锚定的日期。
- 探索性部分交给 AI 助手。在 全端分析 › 智能运营 › AI 助手 里问什么变了;它的变化归因会按渠道、来源域名、国家、设备和着陆页拆解变化。除非计划里有,否则把它找到的东西当作探索性发现。
- 之后持续监控。在 全端分析 › 智能运营 › 监控 里给注册率建一个监控;试运行会告诉你近 30 天里它会触发几次。
TapCub 不替你写计划、选检验或判断什么算显著;计划是你的,TapCub 提供计数、拆分和标记。
常见问题
什么是数据分析计划?
它是在看结果之前写下的说明:问题、指标、数据和时期、对比、分群、检验和阈值,以及每种结果下你要做什么。CDC 建议在实施前计划分析,并在之后记下偏离。
数据分析计划应该包含什么?
按 CDC 清单,至少要有:要分析的数据、要做的分析、何时做、由谁做。实际中再加上指标定义、分群、阈值和决策规则。
数据分析计划和数据分析报告有什么区别?
计划写在分析之前,说明你将如何决定;报告写在之后,说明你发现了什么。把两者对照,就能看出你有没有改变方向,这正是计划的意义。
计划比较多少个分群合适?
决策需要几个就几个。如果你在 0.05 下检验 k 个独立拆分,至少一次误报的概率是 1 − 0.95^k:5 个是 22.6%,20 个是 64.2%。检验多个时,用 α 除以拆分个数。
要检出注册下降,需要多少数据?
从 4.0% 降到 3.2%,在 α = 0.05、效能 80% 下,每个时期约 8,511 个访客;从 4.0% 降到 3.6%,约 35,864。变化越小,需要的数据越多。
资料来源
- 美国疾控中心,「Step 5 Checklist」(评估框架行动指南):在实施前计划分析、最少包含的内容、记下偏离。https://cdc.gov/evaluation/php/evaluation-framework-action-guide/step-5-checklist.html (2026-11-20 核对)
- NIST/SEMATECH 统计方法电子手册,7.3.3 节,比较两个比例:合并估计、z 统计量、大样本条件、小样本用 Fisher 精确检验。https://www.itl.nist.gov/div898/handbook/prc/section3/prc33.htm (2026-11-20 核对)
- 美国教育统计中心,「Bonferroni procedure」:α 除以比较个数,四次比较为 0.0125,临界值 1.960 升到 2.498。https://nces.ed.gov/nationsreportcard/tdw/analysis/2000_2001/infer_multiplecompare_bonfer.aspx (2026-11-20 核对)
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
