聚合,是用求和、平均、计数或最大值这类函数,把许多条记录压成一个值。它让数据变得可读,但也会扔掉细节,所以聚合的粒度和聚合发生在哪一步,决定了你事后还能不能找到问题。下面讲每个函数藏起了什么、三个带数字的陷阱,以及怎么选。
读完你会知道
- 不要对比率取平均:分子、分母分别求和再相除(算例里是 4.67%,不是 6.25%)
- 相信总数之前先按设备或渠道拆开;合并分组后,赢家可能翻转
- 保留一个细到能看出某一天出问题的粒度,去重计数要重新计算,不要把每日数字相加
聚合是什么意思
聚合,就是用一个函数把许多条记录压成一个值:求和、求平均、计数、取最大。「聚合」是这个动作,「聚合数据」是结果:一行数字代表许多行。十笔订单变成「总收入:412 美元」,两百万次页面浏览变成「每日访客数」。
这个词还用来指第二件事:把来自几处的数据收集到一个存储里。那更接近数据整合,相关词汇见 数据聚合词条。本文讲的是第一种意思,也就是汇总行,以及汇总会丢掉什么。
丢掉细节正是关键。汇总有用,恰恰因为它扔掉了细节;它有风险,也是同一个原因。扔掉哪些细节、在哪一步扔,决定了事后你还能不能找到问题。本文余下的部分,是教你有意识地做这个选择。
常见聚合函数,以及各自藏起了什么
几乎所有报表都由六个函数搭起来。每个函数回答一个问题,也藏起一样具体的东西。
| 函数 | 回答 | 适合 | 藏起了什么 |
|---|---|---|---|
| 计数(COUNT) | 有多少条记录? | 订单、会话、错误 | 它们属于很少的人还是很多人 |
| 去重计数(COUNT DISTINCT) | 有多少个不同的? | 访客、客户 | 谁回来过、回来几次 |
| 求和(SUM) | 一共多少? | 收入、浏览量 | 来自一笔大单还是一千笔小单 |
| 平均(均值) | 典型值是多少? | 订单金额、页面停留时间 | 异常值和分布的形状 |
| 中位数 / 分位数 | 中间值,或慢的那条尾巴是多少? | 时长、加载时间 | 你选的那个点之上或之下的一切 |
| 最小 / 最大(MIN / MAX) | 极端值是多少? | 峰值负载、首末日期 | 它出现得有多频繁 |
实践中有两个细节容易绊人。PostgreSQL 手册写明:在 SQL 里,COUNT(*) 数所有行,包括有缺失值的行;而 COUNT(列)、SUM、AVG、MIN、MAX 会跳过缺失值,并且除 COUNT 之外,没有匹配行时返回的是空值而不是零。所以「人均收入」这个说法,如果把收入缺失的客户丢掉而不是按零算,含义就悄悄变了。请说明你用的是哪一种。
算例:简单平均与加权平均
示例数据:上个月四个渠道给一家店带来了流量。
| 渠道 | 会话数 | 订单数 | 转化率 |
|---|---|---|---|
| 邮件 | 500 | 60 | 60 ÷ 500 = 12.0% |
| 搜索 | 3,000 | 120 | 120 ÷ 3,000 = 4.0% |
| 社交 | 1,500 | 30 | 30 ÷ 1,500 = 2.0% |
| 直接访问 | 1,000 | 70 | 70 ÷ 1,000 = 7.0% |
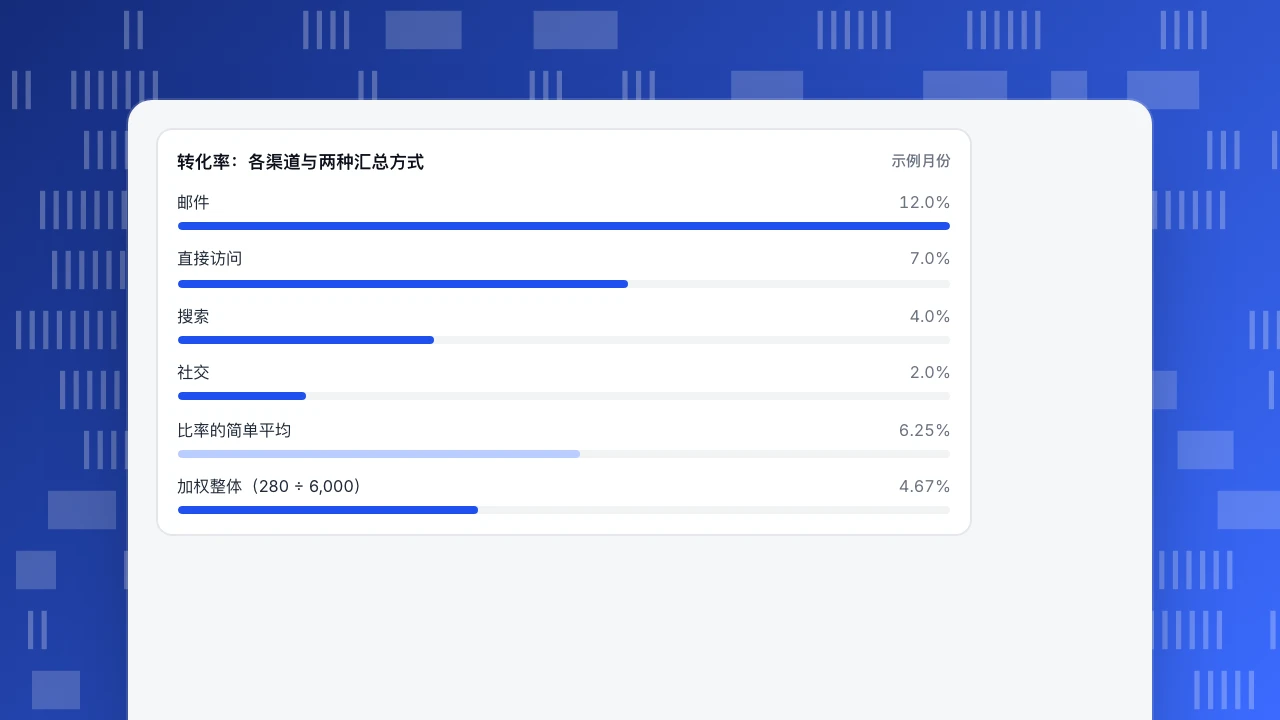
快速的汇总是把四个转化率取平均:(12.0 + 4.0 + 2.0 + 7.0)÷ 4 = 6.25%。这把只有 500 个会话的邮件渠道和 3,000 个会话的搜索渠道同等对待,规模小、转化高的渠道把数字拉高了。
诚实的整体转化率,是先把订单和会话各自加起来,再相除:(60 + 120 + 30 + 70)÷(500 + 3,000 + 1,500 + 1,000)= 280 ÷ 6,000 = 4.67%。这是加权平均,每个渠道按自己的会话数占比计入。两个数相差 6.25 − 4.67 = 1.58 个百分点,简单平均把转化率高估了约三分之一(1.58 ÷ 4.67 = 34%)。
由此得到的规则:不要对比率取平均;分子、分母分别求和,再相除。 转化率、跳出率、点击率,以及任何「每 y 的 x」类数字都适用。
转化率:各渠道与两种汇总方式
示例月份陷阱一:平均数掩盖分布
只有当数值聚在一起时,平均数才描述典型值。当一个特别大的值混在一堆小值里,它会把均值拖离大部分数据所在的位置。
示例数据:十次会话,单位为秒:12、15、18、20、22、25、30、35、40 和 1,800(一个开了一整夜没关的标签页)。
- 均值:(12 + 15 + 18 + 20 + 22 + 25 + 30 + 35 + 40 + 1,800)÷ 10 = 2,017 ÷ 10 = 201.7 秒。
- 中位数:十个值的中间是第五和第六个的平均,(22 + 25)÷ 2 = 23.5 秒。
报表上写「平均会话时长 3 分 22 秒」,样本里没有任何一次会话是这个样子。十次里有九次不到一分钟。NIST/SEMATECH 工程统计手册给出了一般原则:均值对极端值敏感,中位数不敏感,所以尾部有极端值的数据,中位数通常是对中心更好的估计。完整对比见 平均数与中位数。
处理办法:凡是有长尾的数据(时长、加载时间、订单金额),在均值旁边,或者代替均值,报告中位数和一个高分位数,比如 P90。
陷阱二:辛普森悖论,总体说的和每一组都相反
有时,在每个分组内部都成立的趋势,到合并后的总体里却反了过来。这就是 辛普森悖论。经典例子是 Bickel、Hammel 和 O'Connell(1975)分析的 1973 年伯克利研究生录取数据:总体上男生录取率更高,但没有任何一个系对女生有偏见,因为女生更多申请了录取率更低的系。
示例数据:你拿页面 A 和页面 B 做对比。两个页面各展示给 1,000 名访客,但流量构成不同。
| 页面 | 手机访问 | 手机订单 | 电脑访问 | 电脑订单 | 总体 |
|---|---|---|---|---|---|
| A | 100 | 5(5.0%) | 900 | 180(20.0%) | 185 ÷ 1,000 = 18.5% |
| B | 600 | 42(7.0%) | 400 | 88(22.0%) | 130 ÷ 1,000 = 13.0% |
页面 B 在手机上赢(7.0% 对 5.0%),在电脑上也赢(22.0% 对 20.0%),总体却输了(13.0% 对 18.5%)。没有任何计算错误。只是页面 B 收到的多是手机访客,他们在两个页面上转化都更低,所以 B 的总体转化率是被构成拖低的,不是被页面拖低的。
处理办法:从汇总数字宣布赢家之前,先按最可能改变行为的维度(设备、渠道、国家、新老访客)拆开,看方向在每一组里是否成立。如果翻转了,说明总体量到的是构成。
陷阱三:粒度太粗,以及加不起来的合计
聚合到多粗,还会带来另外两个问题。
粒度太粗会藏住一个事件。 示例数据:一家店每天 1,000 个会话。一周每天的订单是 40、41、40、0、42、41、40。第四天结账坏了。周视图显示 244 笔订单 ÷ 7,000 个会话 = 3.49%。正常日子的转化是 244 ÷ 6,000 = 4.07%。周数字比平时差约 14%,看起来像是缓慢下滑,实际是一天为零、六天正常。只有按天的粒度才看得出来。这就是 数据粒度 的问题:每一行保留到多细。
有些合计不能相加。 事件次数和金额总和可以跨天相加,不同人数不行。示例数据:每日独立访客 100、110、90,加起来是 300,但很多人来了不止一天,三天里不同的人数可能只有 180。把每日独立数相加,会让回访的人每天算一次。同样的道理也适用于「对平均数再求平均」,比如各天流量不同时取日均值的均值。
处理办法:保留一个细到能看出某一天出问题的粒度;对去重计数,要从底层记录算整个时间段的独立数,不要把每日数字相加。
| 陷阱 | 你看到的现象 | 检查办法 |
|---|---|---|
| 对比率取平均 | 整体比率偏高(6.25% 对 4.67%) | 分子、分母分别求和再相除 |
| 有异常值的均值 | 一个没有任何记录接近的「典型值」(201.7 秒,中位数 23.5 秒) | 报告中位数和 P90 |
| 混合分组 | 总体里赢家翻转(B 在两组都赢,总体却输) | 按设备、渠道或国家拆开 |
| 粒度太粗 | 一天出故障看起来像缓慢下滑(3.49% 对 4.07%) | 保留按天或按小时的视图 |
| 把去重计数相加 | 每个人每天被算一次(300,可能只有 180) | 对整段时间算去重数 |
每一行都对应本文里的一个算例。
怎么选聚合什么、什么时候聚合
按顺序问五个问题。每个问题对应一条规则。
| 问题 | 规则 |
|---|---|
| 这个数字要用来做什么决定? | 选能让人采取行动的粒度:宕机看小时,趋势看周,预算看月。 |
| 这件事变得多快? | 按变化的速度聚合。一天之内就可能坏掉的东西,需要按天或按小时看。 |
| 每个桶里有多少条记录? | 桶里只有寥寥几条时,就放宽桶。10 个会话算出来的比率会剧烈波动。 |
| 这个指标能相加吗? | 次数和总和可以相加。去重计数和比率不行,要从底层记录重新计算。 |
| 你能回到细节吗? | 在保留规则允许的时间内保留原始记录,读取时再聚合。不需要细节、或不能保留细节时,才只存聚合。 |
最后一行还有隐私的一面。只存汇总能限制可能泄露的范围,但一个很小的群体的汇总仍可能指向某个人,所以在展示拆分之前,先定一个最小群体人数。
在 TapCub 里怎么读聚合数字
拿算例里的渠道表,看 TapCub 怎么呈现同样的数字。
- 有意识地选粒度。 网站统计 › 数据报表 每行是一个时间桶,粒度可选小时、天、周、月或年;按小时看最多 7 天。先用按天的粒度抓出像结账示例第四天那样的一天,再放宽到周看趋势。
- 比率看合计行。 这份报表的合计行里,次数类指标把各行相加;比率和均值是分子、分母分别相加后再除。这正是算例里的加权算法(280 ÷ 6,000),不是对每日比率取平均。
- 记住访客合计是跨天相加的。 访客合计是各日相加,同一个人来了三天会算三次。所选范围不超过 93 天时,表下还会给出整段时间的去重访客数;想表达「有多少个不同的人」时用那个。盐每天轮换时(匿名聚合档位或严格模式),同一个人根本无法跨天对上。
- 先拆开再下结论。 在 网站统计 › 来源 里把同一时间段按渠道拆开,检查方向在每个渠道里是否成立,就像辛普森悖论那个例子。
- 选适合分布形状的度量。 在 全端分析 › 行为分析 › 自定义指标与 SQL 里,可以把指标定义成「事件 + 聚合方式」,比如去重人数、人均、中位数或 P90,这样时长报表不必只靠均值。
TapCub 不会告诉你,这个聚合对你要做的决定是不是合适的那个;粒度和度量的选择仍然在你。
常见问题
聚合数据是什么意思?
聚合数据,是把许多条记录合并成一个汇总值,比如总和、平均、计数或最大值。6,000 个会话的表变成一个转化率。聚合让数据变得可读、可存储,但也去掉了发现异常值、分组和某个出问题日子所需的细节。
什么是聚合数据?
聚合数据是聚合的输出:一个数字,或一张数字表,代表背后许多条记录,比如每日访客数、按渠道的月收入,或一个平均值。它和原始的、记录级的数据相对,后者保留每一行。
聚合数据是匿名的吗?
不一定。对几千人的合计,几乎看不出其中任何一个人;但拆分到最后,一个只有两三个人的桶,可能指向某个个人。发布拆分之前先定一个最小群体人数,并谨慎对待小桶。
聚合和求平均有什么区别?
求平均只是聚合的一种。聚合还包括计数、求和、取最小最大,以及计算中位数或分位数。对比率求平均,结果可能误导;要像上面的加权示例那样,分子、分母分别求和再相除。
什么时候不该聚合?
不要把你调查问题所需的粒度聚合掉。如果你可能需要找出某一个出问题的日子、设备或活动,就按那个层级保留记录,在读报表时聚合,而不是在存储时聚合。
资料来源
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
