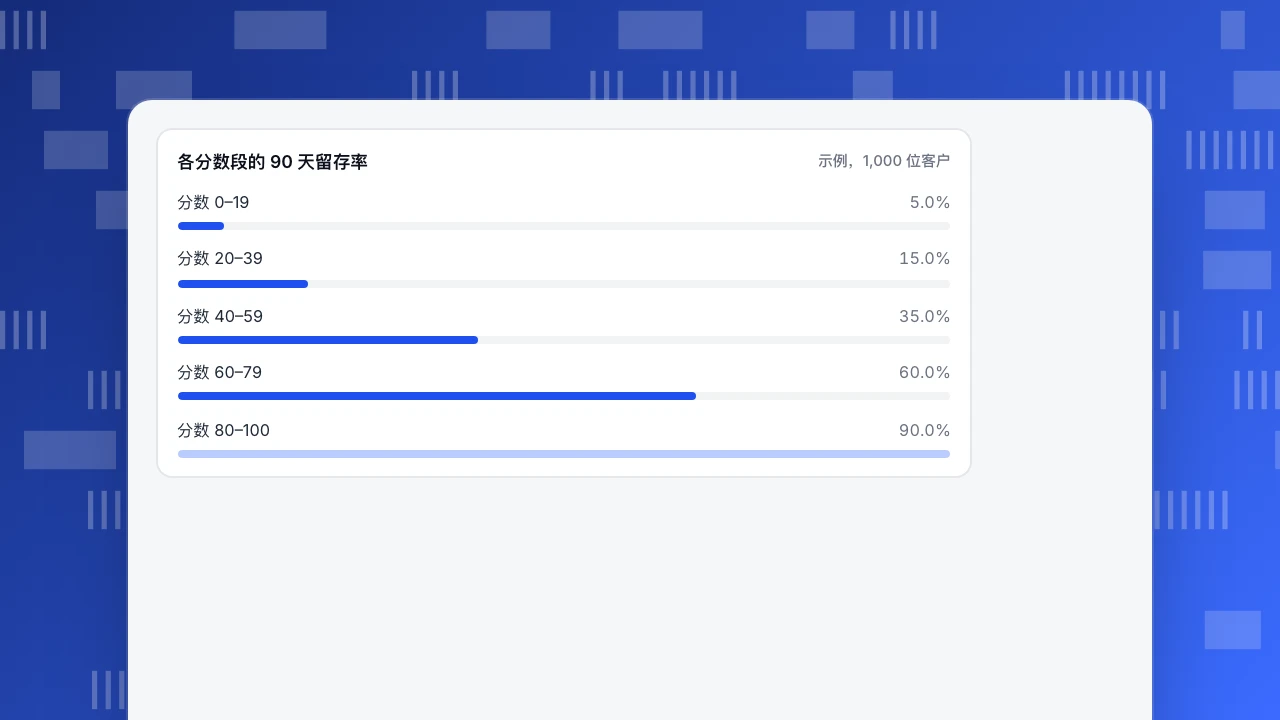
客户参与度得分是对一个人行为的加权求和:给每个有价值的事件加权,限制计入的次数,相加后缩放到 0–100。只有分数段越高留存越好,这个得分才值得使用,所以本文先搭出得分,给四个示例用户打分,再用 90 天留存检验各分数段,留存率从 5% 一路升到 90%。
读完你会知道
- 按离结果的远近给事件加权,并给每个事件设上限,避免嘈杂事件一家独大
- 加上时间衰减,让曾经活跃、后来安静下来的用户分数下降
- 用新时间段的留存来验证;不能区分结果的得分只是装饰
客户参与度得分是什么,它带来什么?
客户参与度得分把一个人的行为变成一个数字,让你能给人排序、发现正在冷淡下去的人,并对每个分数段触发不同的动作。常见模型是加权求和:选出能说明客户获得价值的事件,给每个事件一个权重,乘以它在时间窗口里发生的次数,再全部相加。
得分只有在能预测时才有用:分数越高,续约、复购或升级等结果应当越好。这恰恰是多数指南跳过的部分。它们讲完怎么把权重加起来就结束了。本文先搭出得分,再用一个结果去检验它,因为一个不能区分留存和流失客户的得分,只是装饰。如果你要的是一组参与度指标(比率、频次、深度),而不是针对个人的得分,见客户参与度指标;SaaS 里的产品使用版本见产品参与度得分。
公式是什么?
四个部分,每个都容易复算:
单个事件类型的得分 = 权重 × min(次数, 上限)
原始得分 = 窗口内所有事件类型得分之和
时间衰减(可选)= 每个事件的得分乘以 0.5^(距今天数 ÷ 半衰期)
标准化得分 = min(100, 原始得分 ÷ 基准值 × 100)
- 上限防止某一个嘈杂的事件淹没其他事件。没有上限,浏览 40 次页面的人会比下过一次单的人得分更高。
- 半衰期说明参与度消退得有多快。半衰期 14 天时,7 天前的事件算 0.5^0.5 = 71%,28 天前的算 0.5^2 = 25%。
- 基准值是"高度参与"的人的总分,例如你自己数据里前 10% 的用户。它决定 0–100 的刻度。
Google 自己对参与会话的定义,用更简单的形式体现了同样的逻辑:会话持续超过 10 秒、有关键事件,或有至少两次页面或屏幕浏览,就算参与会话(Google Analytics 帮助)。得分把这种"是或否"的规则推广成加权的分数。
怎样选事件和权重?
从体现价值交付的行为开始,再按这个行为离你关心的结果有多近来加权。下面是网店的起步表(所有权重都是假设,请换成你自己的):
| 事件 | 权重 | 窗口内上限 | 为什么是这个权重 |
|---|---|---|---|
| purchase | 10 | 5 | 结果本身 |
| checkout_start | 5 | 5 | 意向很强,但还没有价值 |
| add_to_cart | 3 | 5 | 意向 |
| chat_started | 2 | 5 | 提了问题,说明有兴趣 |
| search | 1 | 5 | 在看,投入低 |
| page_view | 0.2 | 5 | 便宜又频繁,所以接近零 |
让这张表保持诚实的规则:
- 按离结果的远近加权,而不是按好不好统计。 页面浏览很多,所以权重最低。
- 设上限,取同一事件再多也不会提供新信息的次数。
- 有负面信号就加进来(退款、投诉),给负权重。
- 事件类型不要超过约 10 种。 再多就没人能解释这个得分了。
如果你有结果数据,可以估计权重而不是拍脑袋:用次数做输入、"是否留存"做结果,拟合逻辑回归,再缩放系数(scikit-learn:逻辑回归)。把它们取整,表格才好读。
| 事件 | 权重 | 窗口内上限 |
|---|---|---|
| purchase | 10 | 5 |
| checkout_start | 5 | 5 |
| add_to_cart | 3 | 5 |
| chat_started | 2 | 5 |
| search | 1 | 5 |
| page_view | 0.2 | 5 |
网店的示例权重;用留存检验后,换成你自己的。
示例:给四个人打分
示例数据,一个 28 天窗口。用上表,得分是 权重 × min(次数, 5):
| 人 | 事件 | 原始得分(不设上限) | 设上限后的得分 | 标准化(÷ 40 × 100,最高 100) |
|---|---|---|---|---|
| A | 2 次购买、5 次加购、6 次搜索、30 次页面浏览 | 47.0 | 41.0 | 100 |
| B | 2 次加购、3 次搜索、18 次页面浏览、1 次聊天 | 14.6 | 12.0 | 30 |
| C | 40 次页面浏览、2 次搜索 | 10.0 | 3.0 | 7.5 |
| D | 1 次购买、1 次开始结账、1 次加购、9 次页面浏览 | 19.8 | 19.0 | 47.5 |
复算 A:购买 10 × 2 = 20;加购 3 × 5 = 15;搜索 1 × 5(6 次按上限算 5)= 5;页面浏览 0.2 × 5(30 次按上限算 5)= 1;合计 41。不设上限的原始得分是 20 + 15 + 6 + 6 = 47。C 就是设上限的原因:40 次页面浏览加 2 次搜索得到 10 个原始分,是 B 的 14.6 的三分之二,而这只来自浏览;设上限后 C 是 3 分。
基准值 40 分在这里是假设(这份样本里前 10% 的人);A 得到 41 ÷ 40 × 100 = 102.5,封顶后显示为 100。加上时间衰减,A 的得分会变:如果两次购买都发生在 28 天前,各算 25%,20 个购买分变成 5,A 降到 26 分(标准化 65)。这就是时间衰减的意义:曾经买得多、后来安静下来的人,分数应该下降。
怎样检验得分真的有预测力?
取期初有得分的所有人,和之后 90 天发生的事对比。示例数据,1,000 位客户:
| 分数段 | 客户数 | 留存 | 留存率 |
|---|---|---|---|
| 0–19 | 400 | 20 | 5.0% |
| 20–39 | 300 | 45 | 15.0% |
| 40–59 | 180 | 63 | 35.0% |
| 60–79 | 90 | 54 | 60.0% |
| 80–100 | 30 | 27 | 90.0% |
| 全部 | 1,000 | 209 | 20.9% |
留存率每一档都在上升(5% 到 90%),这就是有用的得分的样子。比曲线形状更重要的有两项检查:
- 单调。 如果 40–59 档的留存比 20–39 档差,说明某个权重不对。找出频率高但和结果关系弱的事件,降低它的权重或上限。
- 不只是量。 和"会话数"这类简单基准对比。如果得分对结果的区分度不比它好,就没有增加信息。
要在权重拟合时没用过的时间段上做这个检查,否则表格会美化结果。
各分数段的 90 天留存率
示例,1,000 位客户分数段拿来做什么?
只有每个分数段触发不同的动作,得分才算物有所值。按上表:
- 0–19(占客户 40%,留存 5%)。 只做低成本动作:自动发一条重新引导的消息。不要在这里花人工时间。
- 20–39(30%,15%)。 可争取的中间层:引导他们做能升到下一档的那个动作,例如把一件商品加入购物车。
- 40–59(18%,35%)。 推向购买;在他们停住的步骤提供帮助。
- 60–100(12%,60% 到 90%)。 保护:不要用他们不需要的折扣去打扰;邀请他们评价或推荐。
- 分数段下滑。 看变化而不是水平。一个人在一个窗口里从 60–79 掉到 20–39,是你能拿到的最早信号。
哪些错误会让得分产生误导?
- 没有上限。 一个高频事件一家独大,得分变成改头换面的"页面浏览数"。
- 权重凭感觉,也不检验。 得分可能看着对,却没有预测力。
- 所有细分共用一个得分。 新客户和老客户不同;在同一个生命周期阶段内比较。
- 把真人和机器人混在一起。 自动化流量会虚增次数,毁掉最高分段;只给真人访客打分。
- 匿名访客。 没有档案的访客无法长期持有得分;给已识别用户打分,其余的当作漏斗问题处理。
- 把得分当成目标。 如果团队按得分拿奖金,事件就会被刷。把结果(留存)和得分放在一起报告。
在 TapCub 里怎么搭这个得分?
TapCub 不会替你计算参与度得分,也不会触发邮件或折扣。它提供的是事件数据和分组工具,让你搭出上面的得分并检验它:
- 采集事件。 确认 purchase、加购、开始结账、搜索和聊天事件都在上报,并识别已登录用户,让行为归属于一个人;已识别的人出现在 全端分析 › 用户 › 用户,档案里有按天排列的时间线。
- 计算得分。 在 全端分析 › 行为分析 › 行为分析 打开 SQL 页签,对事件视图按人查询:给每个事件类型加权,用
CASE表达式把每个次数限制在 5,再求和。同一个视图带有subject列,对应所选的身份。常用的积木,例如每人的购买次数,可以存成 自定义指标与 SQL 里的指标。 - 划分分数段。 在 全端分析 › 用户 › 分群与标签 建规则分群,例如"28 天内至少做过一次加购"这类条件,或者把 SQL 结果里的 ID 粘贴进静态分群。分群人数保留 30 天趋势,所以你能看到分数段在变满还是变空。
- 核对结果。 在 行为分析 里把每个分数段作为群组看留存,并和上面的留存表对比。
- 加上人工核对。 打开几个低分段的档案;对聊过天的人,读一下对话:在 客服 › 客服工作台 里,访客最近的浏览就放在消息旁边。
FAQ
客户参与度得分怎么计算?
选出体现价值的事件,给每个事件一个权重,乘以它在窗口里发生的次数(设上限),再相加。把总分缩放到 0–100,如果希望消退的参与度也被计入,就用半衰期给较早的事件打折。
多少分算好的客户参与度得分?
没有通用数字;得分是相对于你自己的刻度。重要的是分数段能不能区分结果。上面的样本里,80–100 留存 90%,0–19 留存 5%,所以"好"的分数就是你的数据里留存高的那一档。
参与事件怎么加权?
按离结果的远近加权(购买高于搜索,搜索高于页面浏览)。如果有结果数据,拟合逻辑回归并使用取整后的系数;没有的话,先用简单假设,再用留存去验证。
得分多久更新一次?
多数产品每天更新就够了。窗口要和购买周期匹配:高频购买用 28 天,低频购买用 90 天。每个季度重新计算,并对照结果重新检查分数段。
参与度得分和参与度指标有什么区别?
指标描述一个群体(参与率、人均会话数)。得分给每个人排序,让你区别对待。用指标看趋势,用得分决定谁得到哪种动作。
资料来源
- Google Analytics 帮助:互动率和互动会话,核对于 2026-11-21
- scikit-learn:逻辑回归,核对于 2026-11-21
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
