用户体验测试,是观察或衡量真实的人用产品尝试真实的任务,弄清它哪里好用、哪里不行。方法在三个维度上不同:有主持还是无主持、定性还是定量、当面还是远程。行为数据告诉你人们在哪里遇到困难,测试告诉你为什么。这篇给出每种问题对应的方法、一张样本量表(五个用户能发现约 84% 的问题),以及一个从流失到修复的结账示例。
读完你会知道
- 从问题出发选方法:找位置用行为数据,找原因用有主持的会话,要衡量用无主持的测试
- 每个用户群五个参与者能发现约 84.4% 的问题;衡量任务成功率需要更多,40 次成功 28 次是 70% ± 14.2 个百分点
- 分几轮做,每轮五人,轮次之间先修:示例中游客结账(5 人中 4 人)和运费(5 人中 3 人)解释了配送步骤 48.0% 的流失
什么是用户体验测试?
用户体验测试(UX testing),是观察或衡量真实的人用产品完成真实的任务,从而弄清它哪里好用、哪里不行。它也叫可用性测试或用户测试,这三个词经常指同一件事。尼尔森诺曼集团把可用性测试描述为由三部分构成:引导参与者的主持人、参与者在真实生活中可能做的任务,以及参与者,即真实用户或背景、需求相近的人。
目的是用观察取代意见。团队可以为一个按钮清不清楚争论一个小时;五个人找不到它,争论就结束了。这篇讲的是怎样选方法、选多少人、拿到结果怎么办,以及测试和行为数据回答的是不同的问题:数据告诉你人们在哪里遇到困难,测试告诉你为什么。
UX 测试有哪几类?
方法在三个维度上不同,你在每个维度上选一个位置:
| 维度 | 选项 1 | 选项 2 | 怎么选 |
|---|---|---|---|
| 是否有主持 | 有主持:主持人现场互动,当面或屏幕共享 | 无主持:参与者独自完成书面任务,你事后查看录屏和指标 | 要追问就选有主持,要低成本触达很多人就选无主持 |
| 定性还是定量 | 定性:关于人们怎么使用的洞察;适合发现问题 | 定量:任务成功率、任务时间等指标;适合做基准 | 是发现问题,还是衡量问题 |
| 当面还是远程 | 当面:对情境观察更丰富 | 远程:招募更快,参与者在自己的环境里 | 触达范围与真实感 |
定性与定量、有主持与无主持的定义,沿用尼尔森诺曼集团的可用性测试指南。典型的首次研究是有主持、定性、远程:五个人,每人一小时,共享屏幕,边做边说出想法。
哪种方法适合哪种问题?
从问题出发选方法,不要看工具提供什么:
| 你的问题 | 适合的方法 | 你得到什么 |
|---|---|---|
| 人们在哪里流失? | 行为数据:漏斗、回放、热力图 | 问题的位置,没有原因 |
| 他们为什么卡住? | 有主持的定性会话 | 原因,用他们自己的话 |
| 新设计表现更好吗? | 无主持的定量任务测试 | 任务成功率、任务时间 |
| 人们能找到 X 吗? | 首次点击或导航测试 | 他们首先点哪里 |
| 购买前人们怎么想? | 访谈 | 情境和动机 |
| 在手机上能用吗? | 在真机上做远程有主持或无主持测试 | 手机特有的问题 |
针对移动端的方案见 移动应用可用性测试;分析和测试怎样配合,见 用户体验分析;由专家而不是用户来评审界面,见 用户体验审查。
| 你的问题 | 适合的方法 | 你得到什么 |
|---|---|---|
| 人们在哪里流失? | 漏斗、回放、热力图 | 位置,没有原因 |
| 他们为什么卡住? | 有主持的定性会话 | 原因,用他们自己的话 |
| 新设计表现更好吗? | 无主持的定量任务测试 | 任务成功率、任务时间 |
| 人们能找到 X 吗? | 首次点击或导航测试 | 他们首先点哪里 |
从问题出发选方法,不要看工具提供什么。
需要多少参与者?
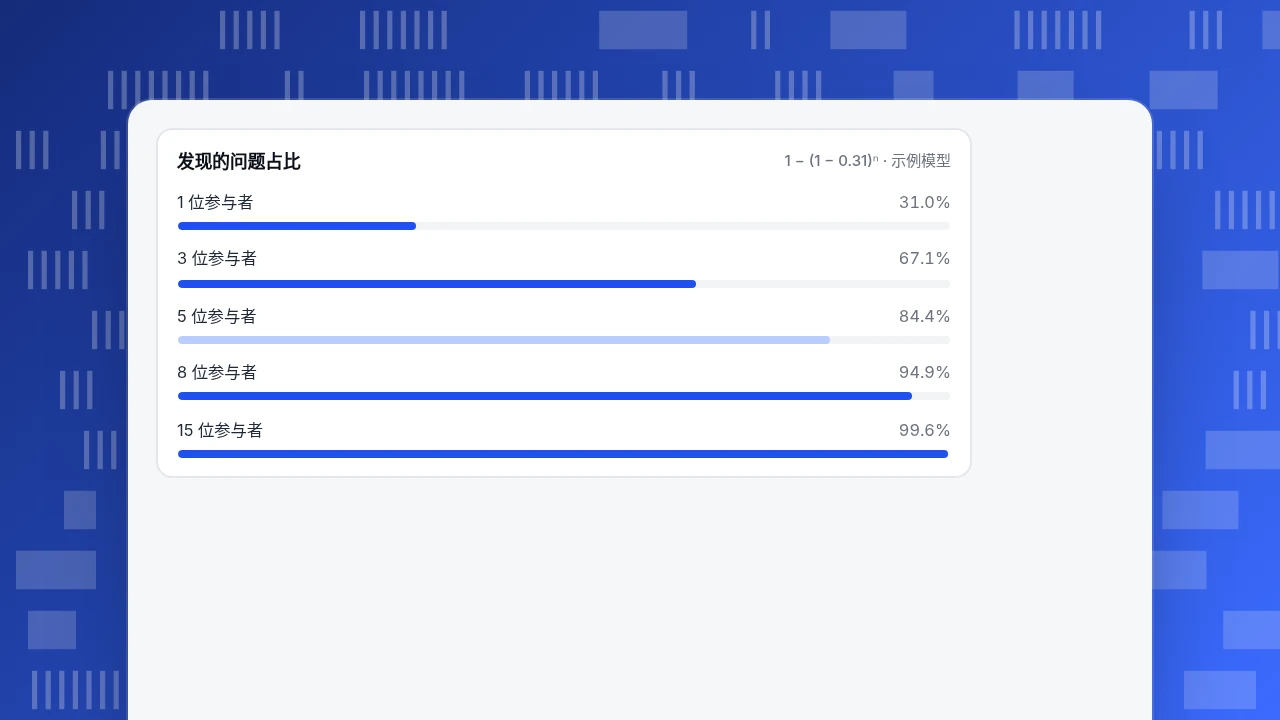
取决于你是想发现问题,还是想衡量问题。对发现问题而言,Nielsen 和 Landauer 的模型给出 n 个用户发现的问题占比为 1 − (1 − L)ⁿ,其中 L 是单个用户能发现的问题占比;在他们的各个项目中,L 的典型值是 31%。算出来:
| 参与者数 | 发现的问题占比(L = 0.31) |
|---|---|
| 1 | 31.0% |
| 3 | 67.1% |
| 5 | 84.4% |
| 8 | 94.9% |
| 15 | 99.6% |
五个用户在他们的首次研究里发现了约 85% 的问题,与公式算出的 84.4% 相符。曲线会变平:从五人增加到十五人,只多出约 15 个百分点,成本却是三倍,而且重复发现的是同样的问题。因此该指南建议把预算分成几次五人的小研究,轮次之间先修问题,而不是做一次大研究。这适用于单一用户群;如果有需求不同的几个群体,每个群体都要测。
衡量则不同。想要一个可信的任务成功率,五个人远远不够。用简单的 95% 区间公式(1.96 × √(p(1 − p) ÷ n)),5 次里成功 4 次(80%)的区间已经从约 45% 一直延伸到上限,而且这个公式在这么小的样本下本身就不可靠;而 40 次里成功 28 次(70%)给出 70% ± 14.2 个百分点,大约 56% 到 84%。
发现的问题占比
1 − (1 − 0.31)ⁿ · 示例模型算例:哪里出问题、为什么、修复有没有用?
示例数据。某个结账流程的行为数据显示:
| 步骤 | 会话数 | 继续 | 继续率 |
|---|---|---|---|
| 购物车 | 1,000 | 700 | 70.0% |
| 配送 | 700 | 364 | 52.0% |
| 支付 | 364 | 300 | 82.4% |
流失最大的是配送步骤:700 人到达,只有 364 人继续,48.0% 离开。这是「哪里」,它没有说明「为什么」。
有主持的会话。 五位参与者尝试「买下这件商品」。示例发现:5 人中 4 人找不到游客结账选项;5 人中 3 人对运费直到这一步才出现感到意外;5 人中 1 人卡在优惠券输入框。修复清单按遇到每个问题的人数排序:游客结账(4)、运费(3)、优惠券(1)。前两个问题,任何分析图表都不会告诉你。
修复后的无主持检验。 40 位参与者在修复前尝试同一个任务,40 位在修复后尝试:修复前,40 人中 21 人完成(52.5%,区间 37.0% 到 68.0%);修复后,40 人中 33 人完成(82.5%,区间 70.7% 到 94.3%)。两个区间不重叠,所以这个提升不太可能是偶然,不过每组只有 40 人,范围仍然很宽。然后观察线上的漏斗:如果配送步骤的继续率从 52.0% 向测试得到的比例上升,这个闭环就合上了。
注意这个顺序:数据 → 有主持的测试 → 修复 → 无主持的检验 → 再看数据。 每种方法做它最擅长的事。
怎样进行有主持的会话?
- 写任务,不写操作指令。「你要给一位喜欢骑行的朋友买礼物,预算 50 美元以内」,而不是「点商店,再点骑行」。
- 请参与者边做边说出想法,你保持安静。「你在找什么?」这类提示可以;「你看到右边那个按钮了吗?」就是诱导。
- 不要帮忙。 如果他们失败,记下在哪里、为什么;超过设定时间就结束这个任务。
- 经许可后录制,并记下原话。
- 按出现频率和严重程度排序。 多少人遇到,是否让任务无法完成?
- 修改后再测。 五位新参与者,同样的任务。
一份五到七个任务的会话提纲,一小时内可以完成,还留有提问时间。
无主持测试容易出什么问题?
参与者没法被追问,所以设计要承担更多。常见问题:任务措辞不清、参与者为了奖励草草完成、参与者不是你的用户。让任务简短具体,加入筛选问题和注意力检查,并抽查一部分录屏,不要只看成功率数字。报告成功率时附上区间,如上所述,免得小样本看起来像是一次测量。
怎样把测试和行为数据结合起来?
| 问题 | 行为数据告诉你 | 测试告诉你 |
|---|---|---|
| 问题在哪里? | 漏斗流失、狂点、错误页 | |
| 为什么发生? | 一个线索(例如点击了不是链接的东西) | 原因,用参与者自己的话 |
| 有多严重? | 受影响会话的占比 | 小样本说不了 |
| 修复有用吗? | 上线后的漏斗比率 | 后续测试里的成功率 |
用行为数据选择测什么、衡量问题多大;用测试解释它;再回到行为数据,在规模上确认修复。
哪些错误会削弱 UX 测试?
- 找同事来测。 他们知道得太多。
- 诱导性提问和帮忙。 结果就反映的是主持人。
- 把五个人当作一次测量。 它能发现问题,不能衡量问题多大。
- 做一次大测试,而不是分几轮。 你为重复的发现付了钱。
- 没有绑定决策。 事先定好什么结果会改变设计。
- 汇报意见而不是观察。「他们不喜欢」比「5 人中 4 人找不到游客结账」弱得多。
怎样在 TapCub 里把行为数据和测试结合起来
TapCub 提供「在哪里」和「有没有用」;它不招募参与者、不主持会话,也不投放测试。用结账的例子:
- 找到流失点。 在 全端分析 › 行为分析 › 行为分析 里建一个购物车 → 配送 → 支付 → 下单的漏斗。每一步显示相对上一步的比率、中位耗时和最大流失处;点一个步骤,可以看到在那里流失的人。
- 看点击。 全端分析 › 行为分析 › 热力图 有 点击、狂点、滚动触达 和 元素 页签(需要打开全埋点,需 Pro 套餐或更高)。狂点指 300 毫秒、50 像素内的第三次点击,常常标志着一个看起来能点、实际不能点的控件。
- 看一次会话。 全端分析 › 行为分析 › 会话回放 显示单次会话。它默认关闭,由管理员或所有者在确认隐私设置后打开,并保持输入遮罩开启;采样率起始为 10%。用它检查真实访客是否遇到了你在实验室里看到的同样的问题。
- 查错误和速度。 监测 › 错误 列出错误分组及受影响的会话,监测 › 性能 显示真实用户的页面性能,让一个「令人困惑」的步骤,不只是一个很慢或出错的步骤。
- 标注修复,并重看漏斗。 在结账改动上线当天,于 配置 › 日期标注 里添加一条日期标注,并对比改动前后相同长度的漏斗。
- 问访客。 客服 › 客服工作台 显示访客写来时正在看什么,一次对话可能揭示测试漏掉的问题。TapCub 不做 NPS 或 CES 问卷。
FAQ
什么是 UX 测试?
观察或衡量真实的人用产品尝试真实任务,找出它哪里好用、哪里不行。它也叫可用性测试或用户测试。一次测试包含主持人、任务和参与者。
有主持和无主持的 UX 测试有什么区别?
有主持的测试,主持人当面或通过屏幕共享与参与者实时互动;无主持的测试,参与者独自完成书面任务,你事后查看录屏和指标。有主持的能追问为什么;无主持的能低成本触达更多人。
UX 测试需要多少参与者?
定性研究里,每个用户群五个人就足以发现大多数常见问题:公式 1 − 0.69ⁿ 在五个用户时得到 84.4%。要衡量任务成功率则需要更多;40 次成功 28 次是 70% ± 14.2 个百分点。
UX 测试的主要类型有哪些?
有主持或无主持,定性或定量,当面或远程,另有首次点击测试、访谈和基准测试等方法族。按你要回答的问题来选。
怎样把 UX 测试和数据分析结合起来?
用行为数据找出人们在哪里流失、影响多少人,用测试了解为什么,再用行为数据确认修复。示例里,漏斗标出配送步骤 48.0% 的流失,测试解释了原因,后续测试显示成功率从 52.5% 升到 82.5%。
资料来源
- 尼尔森诺曼集团。Usability Testing 101:主持人、任务和参与者;定性与定量;有主持与无主持;典型定性研究用五位参与者。2026-11-19 查阅。
- Nielsen, J. Why You Only Need to Test with 5 Users。尼尔森诺曼集团:典型 L 为 31%,五个用户发现 85% 的问题,建议做三次五人研究,而不是一次大研究。2026-11-19 查阅。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
