好的量化研究例子要写明三件事:问题、样本和检验。缺了它们,一个百分比只是轶事。下面讲三个已发表的设计、一个问卷样本量计算(±5 个百分点需要 385 份回答)、一个同样 2 个百分点的差距可以是 p = 0.043 也可以是 p = 0.153 的两组检验,以及六步设计流程。
读完你会知道
- 一个例子只有写明问题、明确界定的群体和对照,才算研究
- 385 份样本在 95% 置信水平下约 ±5 个百分点;±3 个百分点需要 1,068 份
- 同样 2 个百分点的差距,4,000 名访客时显著(p = 0.043),2,000 名时不显著(p = 0.153)
什么是量化研究?
量化研究用数字回答问题:在一个明确界定的群体里测量某样东西,再用统计学判断这个结果能信到什么程度。先有问题(谁、什么、多少),再有样本,最后才是检验。缺了这三部分的例子,比如「我们调查了一些客户,大多数人喜欢」,只是一条带着百分比的轶事。
本文展示好的例子是什么样子,用你能复算的数字走通其中两个,并给出六步设计流程。关于数据本身,见 定量数据;什么时候该加访谈和开放式回答,见 定性数据与定量数据。
真实的量化研究例子是什么样的?
每一种设计回答的是不同类型的问题。下表把设计和已发表的或示意性的例子配在一起。
| 设计 | 它回答的问题 | 例子 |
|---|---|---|
| 随机实验 | 是这个导致了那个吗? | 俄勒冈健康保险实验:2008 年,低收入的无保险成年人通过抽签获得申请医疗补助的机会,所以是抽签产生了两组人。一年后,中签者拥有保险的可能性高出约 25 个百分点 |
| 准实验 | 变化落到的地方,与没落到的地方,各发生了什么? | Card 和 Krueger 比较了新泽西州 410 家快餐店(1992 年 4 月 1 日最低工资从 4.25 美元涨到 5.05 美元)和宾夕法尼亚州的快餐店(仍是 4.25 美元),涨价前后各调查一次。相对宾夕法尼亚州,新泽西州的就业上升了约 13% |
| 队列研究 | 什么能预测长期的结果? | 弗雷明汉心脏研究:从 1948 年起跟踪马萨诸塞州弗雷明汉的 5,209 名成年人,每两到六年检查一次,把吸烟、胆固醇和血压与心脏病联系起来 |
| 调查 | 某件事在总体里有多普遍? | 一次抽样的客户调查:「有多大比例的人每周使用功能 X?」(下面有算例) |
| 网页 A/B 测试 | 哪个版本转化更好? | 把两个页面版本随机展示给两半访客(下面作为对比算例) |
留意这三个已发表的例子的共同点。每一个都有一个问题、一个明确界定的群体和一个对照,没有一个靠「自己选择了它的人」作对照组。这才是研究和报告的区别。
哪种设计能支撑力度最大的结论?
让结论和设计相匹配,从因果证据力度最大到最弱:
| 设计 | 能支撑「X 导致了 Y」吗? | 主要弱点 |
|---|---|---|
| 随机实验 | 能,只要分配是随机的,且各组保持完整 | 成本,以及中途退出的人 |
| 准实验 | 有时能,只要对照组可信 | 变化之前两组可能就不一样 |
| 队列研究 | 很少;它显示的是随时间的关联 | 隐藏的第三个因素 |
| 调查 | 不能;它描述的是某件事有多普遍 | 谁回复了,以及人们怎样理解问题 |
如果你只有一份调查,就写「与……相关」,不要写「导致」。如果你想要强结论,一开始就要规划好分配;数据收集完之后,这件事无法补上。
怎样设计问卷并确定样本量?
示例数据:一家软件公司有 20,000 名客户,问:「有多大比例的人至少每周使用一次功能 X?」它希望答案的误差在 ±5 个百分点内,置信水平 95%。
一个比例的误差范围是 E = 1.96 × √(p × (1 − p) ÷ n)。问之前你不知道 p,所以取 p = 0.5,这会让 p × (1 − p) 取到最大(0.25),得出偏保守的样本量:
n = 1.96² × 0.25 ÷ 0.05² = 3.8416 × 0.25 ÷ 0.0025 = 384.16,向上取整为 385 份回答。
验算:n = 385、p = 0.5 时,E = 1.96 × √(0.25 ÷ 385) = 0.0499,约 ±5 个百分点。更精确的结果代价高得多:±3 个百分点需要 1.96² × 0.25 ÷ 0.03² = 1,067.1,即 1,068 份回答,接近三倍。
再看回复率。很少有人回复。如果受邀客户里有 25% 作答,385 份回答需要 385 ÷ 0.25 = 1,540 份邀请。更大的风险不在数量,而在谁回复:如果热心的用户回复得更多,使用功能 X 的比例就会被高估,而公式里的 ±5 个百分点并不覆盖这种偏差。把回复者的构成(套餐、使用时长、地区)和客户总体对照,或者对没回复的人抽样追访。
| 误差范围 | 需要的回答数 | 回复率 25% 时的邀请数 |
|---|---|---|
| ±10 个百分点 | 97 | 388 |
| ±5 个百分点 | 385 | 1,540 |
| ±3 个百分点 | 1,068 | 4,272 |
95% 置信水平,p = 0.5,简单随机抽样;向上取整。
怎样比较两组,为什么样本量决定结果?
示例数据:一次页面测试把版本 A 展示给随机选出的 2,000 名访客,把版本 B 展示给另外 2,000 名。A 转化 200 次(10.0%),B 转化 240 次(12.0%)。
问题是:如果两个版本其实完全一样,2 个百分点的差距会不会只是偶然出现?从零假设「没有差异」出发,做一次两比例 z 检验:
- 合并比率:(200 + 240) ÷ 4,000 = 11.0%。
- 标准误:√(0.11 × 0.89 × (1/2,000 + 1/2,000)) = 0.00989。
- z = (0.12 − 0.10) ÷ 0.00989 = 2.02。
- 双侧 p 值约 0.043,低于通常的 0.05 门槛。
- 差异的 95% 置信区间(非合并):2.0 ± 1.96 × 0.989 个百分点,即 0.06 到 3.94 个百分点。
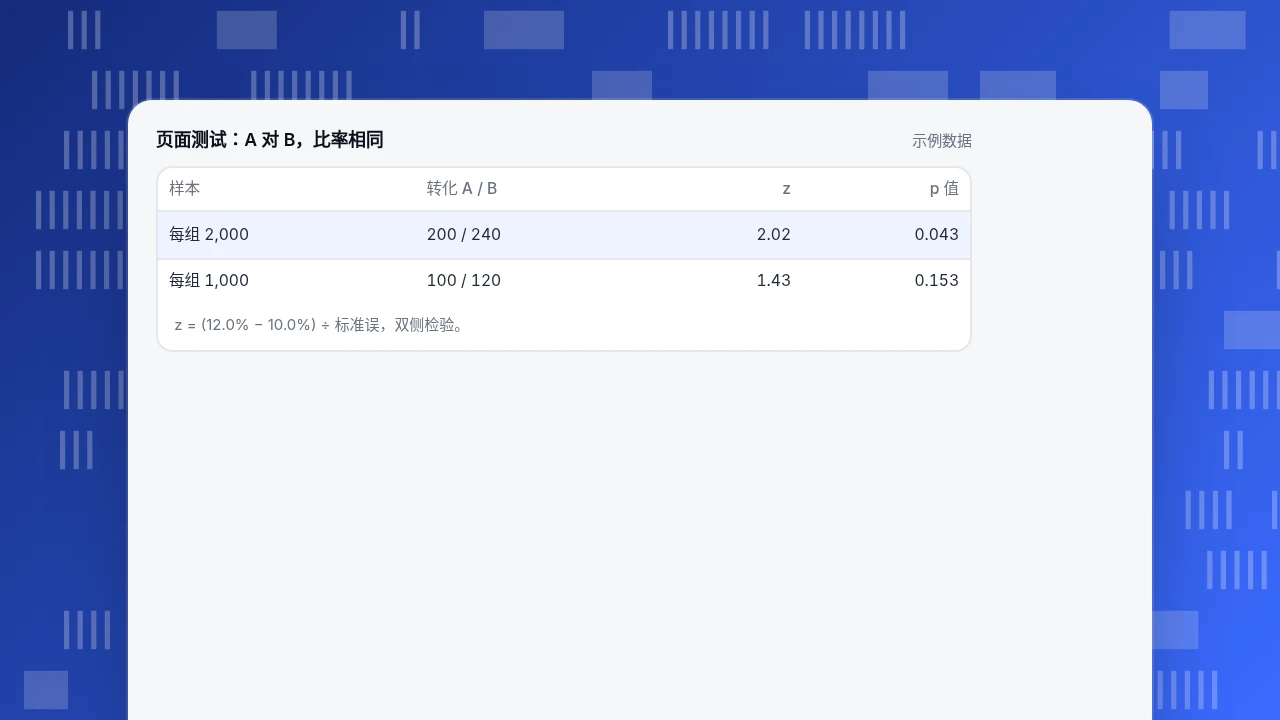
现在保持比率不变,把样本减半:每组 1,000 名访客,转化 100 次对 120 次。标准误升到 0.0140,z 降到 1.43,p 升到 0.153。同样的观测差距,却没有证据。教训是:「B 胜过 A」取决于你数了多少人,而区间 0.06 到 3.94 个百分点,比「B 好 2 个百分点」更诚实。相关概念见 假设检验、p 值 和 统计功效。
页面测试:A 对 B,比率相同
示例数据| 样本 | 转化 A / B | z | p 值 |
|---|---|---|---|
| 每组 2,000 | 200 / 240 | 2.02 | 0.043 |
| 每组 1,000 | 100 / 120 | 1.43 | 0.153 |
z = (12.0% − 10.0%) ÷ 标准误,双侧检验。
怎样分六步设计一项量化研究?
- 写出问题,让它能用一个数字来回答:「版本 B 会不会提高开始试用的访客比例?」,而不是「B 更好吗?」。
- 界定总体以及怎样抽样。 谁算数,你怎样才能接触到其中公平的一部分?
- 精确定义每一个度量。 「活跃」到底指什么:一次会话、一个事件,还是七天?收集之前就写下来。
- 从例子表里选设计:能分配人群就做实验,不能就找对照组,需要知道普遍程度就做调查。
- 先写分析计划:用什么检验、什么门槛、最小样本量。看到数据之后再选检验,容易找到你希望找到的结果。
- 列出威胁,以及你对每一项打算怎么办。
| 威胁 | 它的样子 | 怎么办 |
|---|---|---|
| 选择偏差 | 选择了这个功能的人和没选的人本来就不同 | 随机分配,或拿同类比同类;见 选择偏差 |
| 无回应 | 热心的用户回答,其他人沉默 | 提高回复率,把回复者和总体对照 |
| 混杂 | 第三个因素同时驱动原因和结果 | 控制它,或在子群内比较 |
| 样本太小 | 真实的差距看起来像偶然 | 事先算好样本量 |
| 做了很多检验,只挑一个赢家 | 测二十件事,总有一件靠运气通过 | 事先定好要做哪些检验,并按做的次数校正 |
哪些错误会削弱量化研究?
- 只报百分比,不报基数。 「60% 同意」,如果没有「共 12 位回复者」,意义不大。
- 把相关当成因果。 使用某个功能的人,可能只是本来就更活跃。
- 看了数据再选检验。 先固定分析计划。
- 把 p < 0.05 当成证明。 示例里,同样 2 个百分点的差距,4,000 名访客时 p = 0.043,2,000 名时是 0.153。
- 不管是谁回复的。 样本量公式覆盖的是偶然,不是偏差。
- 结果一看着不错就停。 样本量要事先定好。
怎样把 TapCub 的数据用在量化研究里?
TapCub 不做显著性检验、实验或问卷。它给你的是行为的观察性计数,适合队列式的问题。以这个为例:「第一周使用功能 X 的访客,是否更常回来?」
- 精确定义事件。 约定什么算使用功能 X,并确保它作为事件被记录,例如在 全端分析 › 数据管理 › 埋点方案 里。
- 比较两组。 在 全端分析 › 行为分析 › 行为分析 里用留存,看每一组人在之后各期有多少回来,两组按有没有做过这个事件来划分。
- 查组的大小。 小组波动很大;在读差异之前,先用上面的样本量推算。
- 把计数取出来做检验。 用 全端分析 › 行为分析 › 自定义指标与 SQL 查出数字,或者用 全端分析 › 数据管理 › 数据导出 里的导出,再到统计工具里做检验。
- 说明局限。 人们是自己选择使用这个功能的,所以差距可能反映的是他们是谁,而不是功能起了什么作用(选择偏差)。要确立因果,需要把功能随机分配;TapCub 不做流量分流,也不做 A/B 测试。
常见问题
量化研究有哪些例子?
随机实验,比如俄勒冈健康保险实验;准实验,比如 Card 和 Krueger 的最低工资研究;队列研究,比如弗雷明汉心脏研究;抽样调查和网页 A/B 测试。它们都有一个问题、一个明确界定的群体和一个对照。
量化研究的主要类型有哪些?
实验设计由研究者把人分到各组;准实验设计比较受变化影响和未受影响的群体;观察性设计,如队列研究和调查,测量已经存在的情况。你对分配控制得越多,关于因果的结论就越有力。
样本量应该多大?
取决于你想要的误差范围和置信水平。对一个比例,n = 1.96² × 0.25 ÷ E²:95% 置信水平下,±5 个百分点需要 385 份回答,±3 个百分点需要 1,068 份。除以预期回复率,就得到邀请数。
问卷调查算量化研究吗?
算,只要它用固定的选项或数字量表、明确的总体和抽样方法,并报告计数或比例。开放式回答的调查属于定性研究,除非把答案编码后再计数。
量化研究和定性研究有什么区别?
量化研究测量一个明确界定的群体里「有多少」,并对结果做统计检验;定性研究通过访谈或观察探索「为什么」和「怎么样」。许多研究两者并用:用数字发现规律,用交谈解释它。
资料来源
- Amy Finkelstein 等。The Oregon Health Insurance Experiment: Evidence from the First Year。NBER 工作论文 17190,2011。抽签设计,以及约 25 个百分点的保险覆盖率提升。
- David Card、Alan B. Krueger。Minimum Wages and Employment: A Case Study of the Fast Food Industry in New Jersey and Pennsylvania。NBER 工作论文 4509,1993。410 家餐厅,前后对照设计。
- 美国国家心肺血液研究所。Framingham Heart Study。1948 年开始,5,209 名参与者,每两到六年检查一次。
- 麦克尤恩大学。Margin of Error and Sample Size Calculation for Proportion。公式,以及 p = 0.5 的保守取值。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
