营销组合模型(MMM)是建立在汇总数据(比如每周销量和各渠道花费)上的统计模型,估算各渠道的贡献、效果能持续多久,以及再多花钱会在哪里不再划算。和归因不同,它不需要个人级追踪,可以纳入线下渠道和基线销量。下面讲输入数据、带数字的 adstock 与饱和、怎么读输出,以及什么时候值得搭建。
读完你会知道
- MMM 回答预算在渠道之间怎么挪;归因回答转化访客经历了哪些触点
- 检查观测数和参数数:104 周、21 个参数,平均每个参数只有约 5 个观测
- 从响应曲线读下一块钱的回报,重新分配之前先用实验校准
营销组合模型做什么
营销组合模型(MMM,英文也写作 marketing mix modelling)是拟合在汇总时间序列上的统计模型。你给它每个周期的业务结果(比如每周销量),以及每个周期的营销投入(比如各渠道的花费或曝光量),它会估算每个渠道解释了多少结果、效果消退得多快、再多花钱会在哪里不再划算。它从不追踪个人,所以能把电视、平面媒体和促销一起纳入,也因此在 Cookie 和设备 ID 失效时仍然有效。
Google 开源的 Meridian 文档把输入列为:目标 KPI(通常是销量)、每个渠道的媒体数据、可选的控制变量、可选的地区级数据,以及可选的触达和频次数据。Google 研究人员 Jin 等人(2017)提出,模型必须抓住广告的两个特征:延续效应(广告在投放那一周之后还在起作用)和形状效应(多花的每一块钱买到的比上一块钱少)。本文其余内容都由这两点展开。
MMM 回答的问题是:「下个季度把预算在渠道之间挪动,结果会怎样?」多触点归因回答的是另一个问题:「完成转化的访客经历了哪些触点?」后面的对比一节会把两者并排放;术语本身见媒体组合模型。
它需要什么数据?
| 输入 | 粒度 | 容易出的问题 |
|---|---|---|
| 结果(销量、订单、注册) | 每周(或每天)一行 | 不同时期口径混用,比如退款只在某几个月计入 |
| 各渠道媒体投入 | 花费或曝光量,行与上面对齐 | 花费记在与广告实际投放不同的那一周 |
| 控制变量 | 价格、促销、节假日、季节性、竞品事件,相关时加天气 | 漏掉某个驱动因素,于是渠道被算了不属于它的功劳 |
| 地区(可选) | 各地区同样的变量 | 地区之间不可比 |
| 实验结果(可选) | 提升实验或地区实验的估计值 | 把实验结果用在错误的时期或人群上 |
开工前先数一数观测数和参数数。算例(示例数据):104 周数据、5 个渠道、每个渠道 3 个参数(效果消退多快、曲线多陡、在哪里变平),再加 6 个控制项,共 5 × 3 + 6 = 21 个参数。也就是 104 ÷ 21 ≈ 5.0 个观测对应 1 个参数。这个比值越小,答案就越取决于建模者的假设而不是数据,所以假设需要写下来并检验。
花费总是一起变动的渠道(比如搜索和社交每逢黑五一起加码),模型分不开。如果希望之后得到可用的答案,就在几个星期里有意让花费错开变化。
它怎样刻画延续效应和边际递减?
每个渠道的花费在进入回归之前,要做两种变换。Meta 开源的 Robyn 文档列出了常见选择:几何衰减的广告存量(adstock,单参数的指数衰减)和用于饱和的 Hill 函数。
延续效应(adstock)。 衰减率为 0.5 时,每一周保留上一周一半的效应。示例数据:第 1 周花 100,之后不再花,得到的存量序列是 100、50、25、12.5、6.25……总效应是 100 ÷ (1 − 0.5) = 200,是当周花费的两倍。衰减更快(0.2)时总效应是 125,更低也更早结束。
饱和(边际递减)。 Hill 曲线把存量花费换算成效应:效应 = x^a ÷ (x^a + g^a),形状 a = 1.5,半饱和点 g = 50(每周千美元)。换算成完全饱和时每周 1,000 个订单:
| 每周花费 | 该渠道带来的订单 | 再多花 1 万美元多带来的订单 |
|---|---|---|
| 2 万美元 | 202 | |
| 4 万美元 | 417 | +82.9 |
| 6 万美元 | 568 | +55.6 |
| 8 万美元 | 669 | |
| 10 万美元 | 739 | +26.6 |
从 4 万美元加到 5 万美元多带来 82.9 个订单;从 10 万美元加到 11 万美元只多带来 26.6 个。所以平均回报最高的渠道,不一定是该加码的渠道:挪预算时看的是下一块钱的回报,这要从响应曲线上读,简单平均算不出来。
输出长什么样?
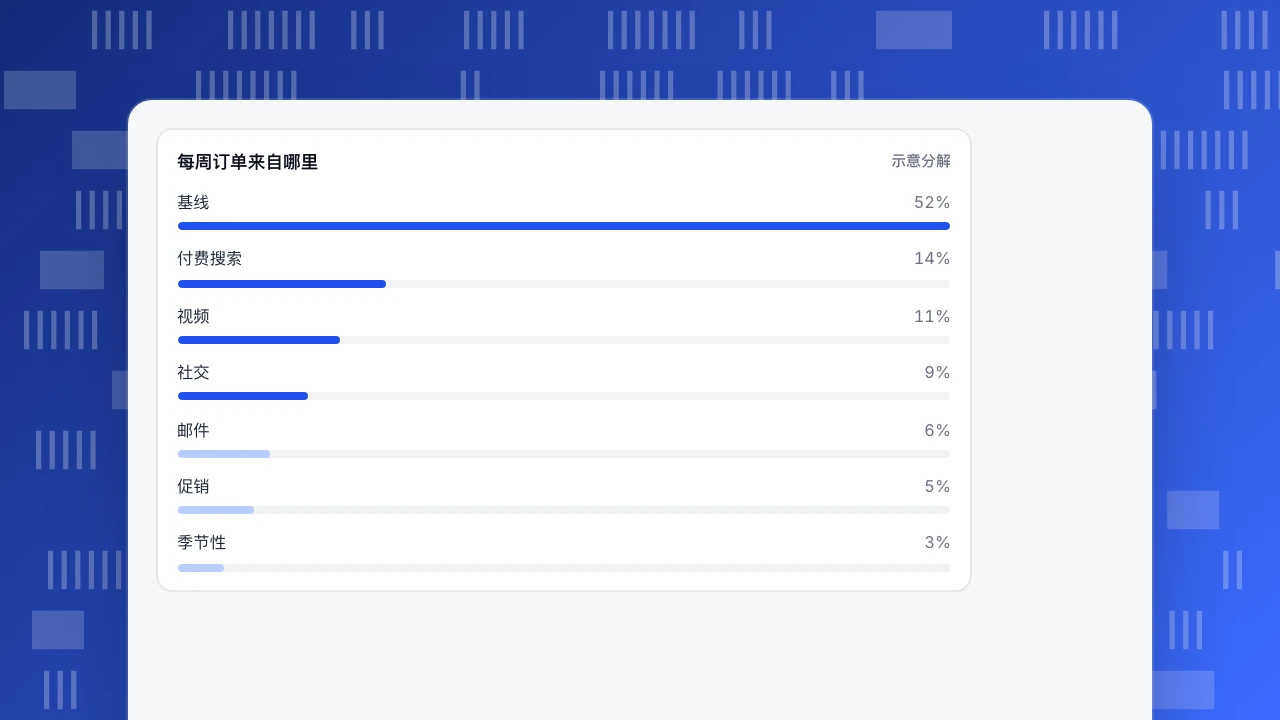
MMM 给出两样东西:把结果拆成基线和各渠道贡献的分解,以及每个渠道的响应曲线。下面是一年的示例分解(示意,不是基准):
| 组成部分 | 占每周订单的比例 |
|---|---|
| 基线(品牌、口碑、老客户) | 52% |
| 付费搜索 | 14% |
| 视频 | 11% |
| 社交 | 9% |
| 邮件 | 6% |
| 促销 | 5% |
| 季节性 | 3% |
各项占比合计为全部。三个习惯能让这张表用起来更稳妥:
- 要区间,不要点估计。 像 Meridian 那样的贝叶斯模型给出的是后验分布;显示「11%」的渠道,实际可能在 6% 到 15% 之间。如果两个渠道的区间大量重叠,不要凭点估计在它们之间挪大额预算。
- 看响应曲线,不只看占比。 占比大但曲线平的渠道已经饱和;占比小但曲线陡的渠道,是值得多测试加投的地方。
- 重新分配前先换算成下一块钱的回报(如上表)。
每周订单来自哪里
示意分解MMM 和归因:各适用于什么时候?
| 营销组合模型 | 归因 | |
|---|---|---|
| 数据 | 汇总时间序列(每周花费和结果) | 转化之前的用户级路径 |
| 需要个人级追踪 | 不需要 | 需要 |
| 线下渠道和促销 | 可以纳入 | 只有触点被记录时才行 |
| 基线销量(本来就会发生的) | 明确估算 | 不估算:每个转化都有功劳要分 |
| 速度 | 建模要几周;按月或按季度刷新 | 每天 |
| 粒度 | 渠道、地区 | 活动、来源、着陆页 |
| 强项 | 在渠道之间分配预算 | 哪些来源和页面出现在转化路径上 |
| 弱项 | 需要花费有变化,且历史足够长 | 功劳规则(首次、末次、线性)是约定,不是对因果的测量 |
两者是互补的。归因能很快告诉你哪些活动出现在转化的旅程里;MMM 稍慢,但能告诉你整个组合值多少。两者不一致时,常见原因是只助攻的渠道(出现在路径里,但自己带不来销量)和归因看不到的渠道。要用实验来裁决,比如地区对照;Robyn 的文档把模型与因果实验校准也列为功能,原因就在这里,并引用一份第三方白皮书的发现:未校准的模型平均偏离真实值约 25%。
| 问题 | 更合适的工具 | 原因 |
|---|---|---|
| 哪些活动出现在转化旅程里? | 归因 | 用户级路径,每天更新 |
| 电视和促销带来了多少? | MMM | 基于汇总数据,不需要追踪 |
| 下一个 1 万美元投在哪里增量最大? | MMM 响应曲线 | 刻画了边际递减 |
| 这个渠道的效果是真的吗? | 实验(地区或提升实验) | 能隔离因果;也用来校准 MMM |
两者配合使用:调活动用归因,在渠道之间分预算用 MMM。
什么时候值得做 MMM,什么时候不值得?
按这几条规则来判断。
- 值得做: 你在三个或更多渠道投放,其中一些没有点击级追踪;你有至少两年口径一致的周数据;并且你真的会根据结果挪预算。
- 还不到时候: 一个渠道几乎占了全部花费(简单的前后对比或对照实验更便宜);历史不到一年;或每个渠道总是一起加码。
- 先用更简单的模型: 参数数量接近周数时。把渠道合并成更少的几个,比拿 52 个数据点去拟合 12 个渠道要好。
- 规划好刷新。 组合变了却不重新拟合的模型,说的是去年的事。
怎么检验模型对不对?
三项检查,按成本从低到高。
- 留出最后 13 周(或类似长度),用其余数据拟合再去预测它们。平均百分比误差(MAPE,对每周误差取绝对值后平均)= |实际 − 预测| ÷ 实际 的平均值。示例数据,留出 6 周:实际订单 520、540、510、560、600、580;预测 500、555、530、540、570、610。误差:3.85%、2.78%、3.92%、3.57%、5.00%、5.17%,平均 4.05%。对过去拟合得好是必要条件,不是充分条件:很多种不同的渠道拆分都能拟合同一段历史。
- 和实验对比。 如果地区实验说搜索让订单增加了 8%,而模型说是 14%,那么两者中有一个是错的。信它的分配之前,先校准或排查。
- 检查符号。 贡献为负的渠道,几乎总是漏了控制变量或存在共线性,而不是这个渠道在毁掉销量。
常见错误
- 把基线当成零。 没有基线,每一笔销量都会被算给某个渠道。
- 用太少的数据拟合太多的渠道。 见上面的每个参数对应的观测数。
- 把一次拟合出的拆分当作真相。 要看区间,以及对先验的敏感度。
- 日期对不上。 花费按开票日而不是广告实际投放日记录,会让延续效应的估计发生偏移。
- 把输出用在错误的决策上。 MMM 用来在渠道之间分配预算,不是用来决定该投放哪条标题。
- 忘了结果里的机器人。 如果结果是网站转化,要排除自动化流量,否则模型拟合的是噪声。
在 TapCub 里准备 MMM 的输入
还是示例的一年。你在搜索、视频、社交和邮件上投放,想得到一张给模型用的周表,外加一个交叉检查。
- 按周取结果。 在 网站统计 › 目标 里定义目标,然后在 网站统计 › 来源 里按渠道和 UTM 活动读取每天的转化。认出来的机器人单独记在 网站统计 › 机器人 里,不计入访客和转化。
- 加上花费。 在 全端分析 › 经营分析 › 渠道 ROI 里按天、渠道、来源和活动导入花费(CSV 或逐条)。页面随后按渠道给出单次点击成本和单次获客成本,在建模之前先有一个快速的视图。
- 导出给模型用。 用 全端分析 › 数据管理 › 数据导出 异步导出底层数据,再在你自己的工具里汇总成周。
- 标出变化。 用 配置 › 日期标注 标出上线、促销和调价,让模型里的控制变量与实际发生的一致。
- 做交叉检查。 在 全端分析 › 行为分析 › 行为分析 里,并排比较首次、末次、线性、位置和时间衰减的功劳。只助攻的渠道会表现为各列功劳差别很大,这些正是该到模型响应曲线里重点看的渠道。
清楚边界:TapCub 不拟合营销组合模型,也不做实验。它提供渠道级的结果表和花费表,以及归因视图;建模在你自己的统计工具里完成。
常见问题
什么是营销组合模型?
营销组合模型是建立在汇总数据(比如每周销量和各渠道花费)上的统计模型。它估算每个渠道的贡献、效果能持续多久,以及再多花钱会在哪里不再划算,帮你在渠道之间分配预算。它不需要个人级追踪。
做 MMM 需要什么数据?
一个结果(比如每周销量)、同样几周里各渠道的花费或曝光量,以及价格、促销、节假日和季节性这类控制变量。地区和实验结果是可选的,但能让模型更可靠。要检查观测数是否明显多于参数数。
MMM 和归因有什么区别?
归因使用转化之前的用户级路径,每天运行;它显示哪些来源和页面出现在转化旅程里。MMM 使用汇总时间序列,包含线下渠道和基线销量,按月或按季度刷新。调活动用归因,在渠道之间分预算用 MMM。
做一次 MMM 要多久?
搭建和检验一个模型通常要几周,时间主要花在数据清洗和验证上,而不是拟合。之后按月或按季度刷新,或在组合发生剧烈变化时刷新。
adstock 和饱和是什么?
adstock 是延续效应:衰减率为 0.5 时,第 1 周花的 100 在随后几周留下 50、25、12.5 的效应。饱和是边际递减:示例曲线里,每周 4 万美元时再多花 1 万美元能多带来 82.9 个订单,每周 10 万美元时只多带来 26.6 个。
资料来源
- Google Developers,Meridian 文档:项目简介。输入:KPI、各渠道媒体数据、可选的控制变量、地区数据和触达频次数据;输出贝叶斯后验分布。核对于 2026-11-21。
- Meta,Robyn 文档:功能。几何衰减 adstock、Hill 饱和、用因果实验校准、第三方白皮书关于未校准模型平均偏离约 25% 的发现。核对于 2026-11-21。
- Yuxue Jin、Yueqing Wang、Yunting Sun、David Chan 和 Jim Koehler,Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects,Google Research,2017。核对于 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
