相关性的例子:每周邮件量与注册数一起上升(r = +0.971),页面加载时间与转化率朝相反方向变化(r = −0.958),博客字数与注册数几乎没有直线关系(r = +0.13)。本文给出每个例子背后的原始数字,你可以自己复算;接着说明同一个 r 为什么可能藏着四种完全不同的形状,以及相信一个系数之前该怎么检查。
读完你会知道
- r 衡量直线关系的强度,范围 −1 到 +1;正负号是方向,r² 是直线能解释的波动比例,「弱」「强」只是经验分档,不是定律
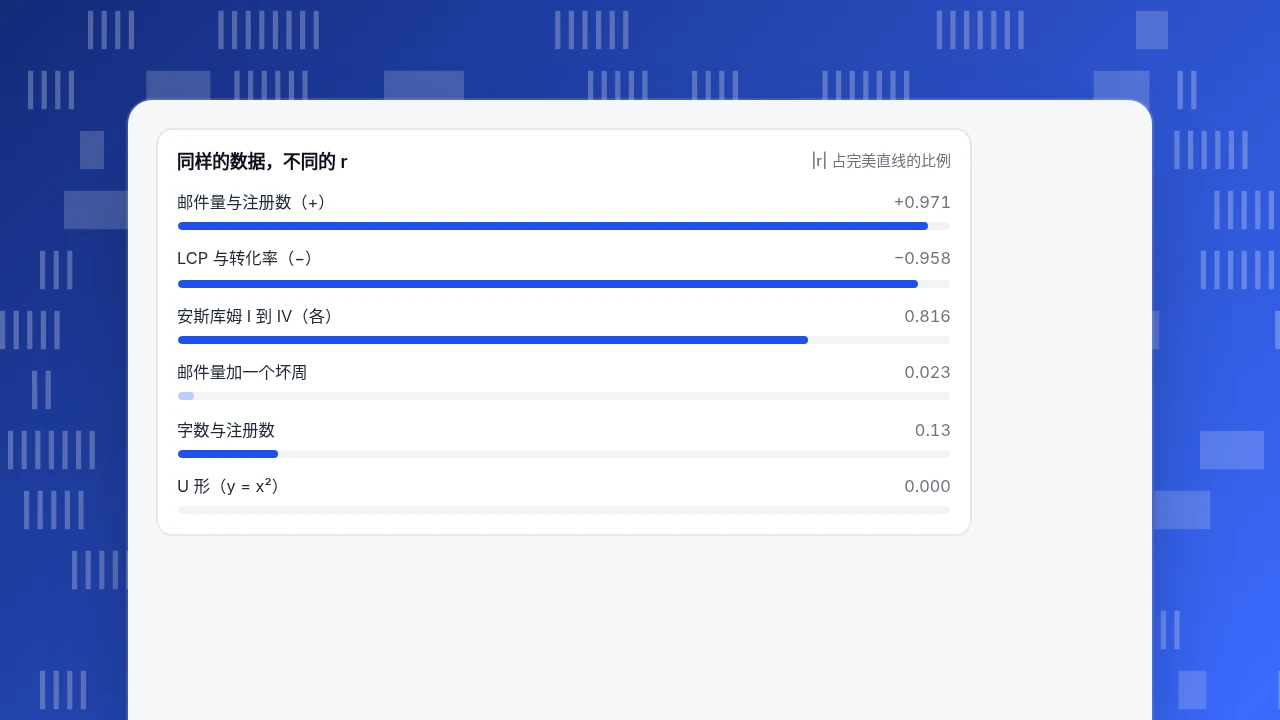
- 同一个 r 可以对应完全不同的数据:安斯库姆四组数据的 r 都是 0.816,一个离群点能把 0.971 拉到 0.023,精确的 U 形关系的 r 是 0.000
- 相信 r 之前:先画图、去掉离群点重算、用 n 对照阈值(10 个点是 0.632)、检查取值范围、找有没有第三个因素
相关系数到底在衡量什么?
皮尔逊相关系数 r 衡量两个数值变量有多贴近一条直线。取值从 −1(完美的下降直线)经过 0(没有直线规律)到 +1(完美的上升直线)。算法是:把每一对数据到两个均值的距离相乘并求和,再除以两个离散程度的乘积:
r = Σ(x − x̄)(y − ȳ) ÷ √[Σ(x − x̄)² × Σ(y − ȳ)²]
平方后得到 r²,表示 y 的波动里有多大比例能由 x 的一条直线解释。算法是确定的,怎么给数值贴标签却没有定论。《Anesthesia & Analgesia》上的一篇教程指出,多数研究者会把小于 0.1 的系数称为可忽略、大于 0.9 称为非常强,中间的数值有争议:0.39 算「弱」、0.40 算「中等」本身就是武断的划分。读 r 要结合你要回答的问题,不要套一把固定的尺子。
下面所有算例只有 10 或 11 个点,用表格软件的 CORREL 就能复算。
分析数据里的正相关长什么样?
正相关指两个数一起变大。示例数据:十周的邮件发送量与注册数。
| 周 | 发送邮件(千封) | 注册数 |
|---|---|---|
| 1 | 2 | 31 |
| 2 | 4 | 40 |
| 3 | 5 | 52 |
| 4 | 7 | 55 |
| 5 | 8 | 71 |
| 6 | 10 | 70 |
| 7 | 11 | 88 |
| 8 | 13 | 86 |
| 9 | 14 | 104 |
| 10 | 16 | 99 |
均值是 9.0 千封邮件和 69.6 个注册。代入公式得到 r = +0.971,r² = 0.943:邮件量的一条直线可以解释注册数逐周波动的约 94%。拟合直线为 注册数 ≈ 22.4 + 5.25 × 邮件千封数,也就是每多发 1,000 封,大约多 5 个注册。
两点提醒。其一,「伴随」不等于「导致」:如果你在有产品发布的周发更多邮件,发布本身可能同时推高两者。其二,十个点不多;n = 10 时要在 5% 显著水平(双侧)下站住脚,需要 |r| ≥ 0.632,这组数据轻松越过。因果问题有单独一篇:相关与因果。
负相关长什么样?
负相关指一个数变大时另一个变小。示例数据:十个页面模板的最大内容绘制时间(LCP,主要内容出现所需的时间)与转化率。
| 模板 | LCP(秒) | 转化率(%) |
|---|---|---|
| 1 | 1.2 | 4.1 |
| 2 | 1.6 | 3.6 |
| 3 | 2.0 | 3.9 |
| 4 | 2.4 | 3.2 |
| 5 | 2.8 | 3.4 |
| 6 | 3.2 | 2.8 |
| 7 | 3.6 | 2.9 |
| 8 | 4.0 | 2.4 |
| 9 | 4.5 | 2.5 |
| 10 | 5.0 | 1.8 |
结果:r = −0.958,r² = 0.917。越慢的模板转化越低,而且斜率很陡:每慢 1 秒大约少 0.55 个百分点的转化率。Google 的 Core Web Vitals 指南把 2.5 秒定为 LCP 的「良好」阈值,按页面加载的第 75 百分位衡量;在这份样本里,LCP 低于 2.5 秒的四个模板平均转化 3.7%,其余六个平均 2.6%。
负号只是方向,不是评价。这里它对业务是坏消息;而「客服工单数」与「版本质量」之间的负相关则是好消息。要结合每根轴的含义来读正负号。
| 类型 | 例子(示例数据) | r | 说明什么 |
|---|---|---|---|
| 正相关 | 10 周发送邮件量与注册数 | +0.971 | 两者一起上升;每 1,000 封邮件约多 5 个注册 |
| 负相关 | 10 个模板的 LCP 秒数与转化率 | −0.958 | 页面越慢转化越低;每慢 1 秒约少 0.55 个百分点 |
| 接近零 | 10 篇文章的字数与注册数 | +0.13 | 没有直线关系;低于 0.632 的噪声阈值 |
| 零但关系很强 | 价格变动与工单数,U 形 | 0.000 | r 识别不了曲线;下结论前先画图 |
示例数据,每个例子 n = 10(U 形为 n = 11);n = 10 时 5% 水平的临界 |r| 为 0.632。
零相关长什么样?
系数接近 0 表示 x 的直线几乎说明不了 y。示例数据:十篇博客文章,字数与各篇带来的注册数。
| 文章 | 字数 | 注册数 |
|---|---|---|
| 1 | 600 | 22 |
| 2 | 900 | 35 |
| 3 | 1,200 | 18 |
| 4 | 1,500 | 30 |
| 5 | 1,800 | 41 |
| 6 | 2,100 | 20 |
| 7 | 2,400 | 33 |
| 8 | 2,700 | 19 |
| 9 | 3,000 | 38 |
| 10 | 3,300 | 27 |
结果:r = +0.13,r² = 0.017,完全落在 n = 10 时分不清与噪声差别的 |r| < 0.632 范围内。字数只解释了不到 2% 的注册波动。实际含义是:长短不是这里拉开差距的原因,应该去看主题、位置或流量来源。也要注意结果没说什么:它没说字数在任何地方都不重要,只说这份样本里看不到直线关系。
同样的数据,不同的 r
|r| 占完美直线的比例两组数据能不能 r 相同,长相却完全不同?
能,经典证明是安斯库姆四重奏:四组各 11 个点的已发表数据(F. J. Anscombe,《The American Statistician》,1973)。下面的数值是他的原始数据,r 为本文重新计算。
| 数据集 | 画出来的形状 | r |
|---|---|---|
| I | 带噪声的上升直线 | 0.816 |
| II | 先升后降的平滑曲线 | 0.816 |
| III | 一条完美直线加一个离群点(x = 13,y = 12.74) | 0.816 |
| IV | 除一个 x = 19 的点外,其余全在 x = 8 | 0.816 |
四组还共享 x̄ = 9.0、ȳ ≈ 7.5 和拟合直线 y = 3 + 0.5x。数字完全一样,背后却是四个不同的故事。数据集 III 用数字演示离群点的作用:去掉 x = 13 的那个点,r 从 0.816 跳到 1.000。数据集 IV 正相反:整个相关性都靠一个点撑着,去掉它之后 x 变成常数,r 根本算不出来。
这种脆弱性在日常分析数据里同样会出现。拿前面的邮件样本,加上第 11 周:发了 30,000 封,只有 20 个注册(那次发送落到了一个坏掉的落地页)。相关系数从 0.971 一下掉到 0.023。一个坏周就抹掉了清晰的规律,所以引用数字之前一定先画图。
关系很强,r 也可能为零吗?
可以,因为 r 只能识别直线。示例数据:价格变动从 −5% 到 +5%,每步 1 个点;工单数随变动幅度(不论涨跌)上升(工单数 = 变动²:25、16、9、4、1、0、1、4、9、16、25)。
这个关系是精确的(每个工单数都由价格变动完全由价格变动决定),然而 r = 0.000,因为左半边向下、右半边向上,两边互相抵消。前面讲阈值的那篇教程同时警告,相关系数「无法充分描述非线性或非单调的关系」,建议始终检查散点图。对于弯曲但方向单一的规律(一直上升、逐渐走平),用斯皮尔曼这类基于秩的系数更合适;对于这种 U 形,把 x 分档后比较各组均值。
引用 r 之前怎么检验它?
按顺序做下面五项检查,哪一项没过就停下。
- 先画图。 散点图(见散点图)能显示曲线、聚类和离群点,而这些都藏在一个数字后面。没有它,安斯库姆的四组数据根本无法区分。
- 测试离群点。 去掉最极端的点重算。如果 r 变化超过约 0.2,两个值都要报告。
- 用 n 对照阈值。 10 个点需要 |r| ≥ 0.632 才能在 5% 水平上和噪声区分;30 个点大约是 0.361。只有几个点支撑的大 r 说明不了什么。
- 检查取值范围。 只截取 x 的一小段(只看低于 2 秒的模板页),算出的 r 会比完整范围弱。
- 问还有什么在同时推动两者。 发布、季节性或流量来源都可能同时推动两个变量。能按这个因素拆分数据就拆;拆不了,就写明。
相关系数还假设每一对数据彼此独立。同一访客的十条日读数,或者每天都依赖前一天的 30 天指标,都会破坏这个假设,让 r 看起来比实际更有说服力。
在 TapCub 里怎么处理相关性?
假设你想拿自己的数据复现上面的邮件样本。TapCub 提供计数,系数本身要在外面算:TapCub 不计算相关系数,也不画散点图。
- 打开 全端分析 › 行为分析 › 行为分析,加入要比较的两个度量(比如一个营销点击事件和你的注册事件),把粒度设为按天或按周。趋势页签会在同一时间范围内显示两条序列。
- 切到表格页签,把结果导出为 CSV。
- 在表格软件里并排放两列,用
CORREL和散点图。把上面五项检查都做一遍,包括离群点测试。 - 标记异常的那一周。如果是发布或故障,就在 配置 › 日期标注 里加一条,让下一个看图的人知道它为什么在那里。
- 相信这个规律之前,在同一份报表里按来源或设备拆分这两个度量,看规律在每个分组里是否还成立;只在一个分组里成立的规律是合并造成的效应,不是普遍关系。
常见问题
正相关的例子有哪些?
上面样本里的每周邮件量与注册数:两者一起上升,r = +0.971。日常常见的例子是身高与体重、学习时长与考试分数。正相关并不说明哪个变量推动了另一个,或者有没有这回事。
负相关的例子有哪些?
页面加载时间与转化率:十个模板的样本里 r = −0.958,页面越慢转化越低。海拔与气温是另一个熟悉的例子。负号只表示两个变量朝相反方向变化。
零相关的例子有哪些?
样本里十篇博客文章的字数与注册数(r = +0.13)。零相关指没有直线规律,不是没有关系:价格变动与工单数的 r = 0.000,却存在精确的 U 形关系。
相关系数 0.5 算强吗?
按多数经验规则是中等,并且解释了 25% 的波动(r² = 0.25)。但这些分档本来就带武断成分,所以要报出数值和 r²,而不是只给标签,还要看清它背后有多少个点。
相关能证明因果吗?
不能。相关只说明两个变量一起变化,不能说明一个导致另一个,因为第三个因素或反方向的作用也会产生同样的规律。检验因果要靠对照实验,或者仔细的分层比较。
资料来源
- Schober P, Boer C, Schwarte LA. Correlation Coefficients: Appropriate Use and Interpretation,《Anesthesia & Analgesia》126(5),2018 年 5 月:阈值、离群点、非线性关系。2026-11-20 核对。
- Anscombe FJ. Graphs in Statistical Analysis,《The American Statistician》27(1),1973:四组数据;数值于 2026-11-20 对照 Duke STA 290 讲义核对。
- Google. Web Vitals:LCP「良好」阈值为 2.5 秒(第 75 百分位)。2026-11-20 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
