大数据分析案例有一个共同点:一个有人会据此行动的具体问题,用本来就存在的数据拼出答案。零售商预测库存,银行给欺诈打分,能源公司预测故障。数据大是手段,不是重点。下面是按行业整理的八个案例、它们的四个共同点,以及一个估算规模的算例,帮你判断自己的数据到底用不用得上大数据工具。
读完你会知道
- 每个站得住的案例,都从一个很窄的问题和一个决策出发,而不是从数据或平台出发
- 先做算术:每月 1,000 万个事件,一年约 120 GB,一台机器就能处理
- 不需要集群时,保留问题、缩小数据,而不是放弃这个想法
怎样的案例才算大数据分析案例?
美国国家标准与技术研究院(NIST)的大数据框架把大数据描述为体量、种类、速度或多变性很高、需要可扩展架构才能高效存储、处理和分析的数据集。关键词是“需要”。对你来说,数据集算不算大,要看一台配置良好的机器是不是已经装不下,或者回答问题要等很久。很多听上去惊人的数据集通不过这个检验,也有很多日常业务问题能通过。
把一个项目称作大数据案例之前,先过四项检查:
- 体量。 原始数据一台机器放不下,或者一次查询要跑几个小时。
- 种类。 答案需要把几类数据拼在一起:点击、文本、传感器读数、交易。
- 速度。 记录持续到达,答案只有在几秒或几分钟内才有用。
- 决策。 有人因为结果改变了做法。没有这一条,只是存储,不是分析。
“决策”这一项是下面所有案例的共同点,也是多数“大数据”项目漏掉的一项。分析的几种类型(描述、诊断、预测、规范)见数据分析的类型。
| 检查 | 要问的问题 | 通过的条件 |
|---|---|---|
| 体量 | 原始数据一台机器放得下吗? | 放不下,或者一次查询要跑几个小时 |
| 种类 | 需要把几类数据拼在一起吗? | 点击、文本、传感器或交易必须合并 |
| 速度 | 答案很快就会过期吗? | 记录持续到达,价值几分钟内就会下降 |
| 决策 | 会有人根据结果行动吗? | 有明确负责人去改订货、拦截或排检修 |
没通过“决策”这一项,不管数据多大,都只是存储,不是分析。
按行业看大数据分析案例
每一行都先写问题,因为让案例成立的正是问题。表里没有点名任何公司:这些是在很多组织里反复出现的模式。
| 行业 | 要回答的问题 | 拼在一起的数据 | 为什么需要规模 |
|---|---|---|---|
| 零售 | 下周哪些商品该放进哪家门店? | 收银明细、天气、本地活动、库存 | 成千上万种商品、成千上万家门店,每天数百万行明细 |
| 电信 | 哪些基站快要过载? | 网络计数器、通话记录、终端型号 | 每个基站持续产生数据流,几分钟内就要决策 |
| 物流 | 哪条路线排序能赶上更多送达时间窗? | GPS 定位、路况、订单数据、仓库容量 | 每辆车每隔几秒一个定位点,可比较的路线很多 |
| 医疗 | 哪些患者有再入院风险? | 入院记录、化验、用药、病历文本 | 每位患者有多种记录;隐私规则限制了数据能放在哪里 |
| 银行 | 这笔刷卡是不是欺诈? | 交易历史、设备、位置、商户 | 要在几毫秒内对照多年历史完成评分 |
| 能源 | 这台风机什么时候需要检修? | 振动和温度传感器、维修记录 | 成千上万个传感器每秒采样多次 |
| 媒体 | 下一步该给每位观众推荐什么? | 观看历史、搜索、评分、片库元数据 | 观众数量巨大,片目数量也巨大 |
| 制造 | 哪一批货可能通不过检验? | 设备参数、传感器曲线、供应商批次 | 产线每道工序都产生高频数据 |
注意表里没有写什么。没有一行写的是“分析我们所有的数据”。每一行都是一个很窄的问题,背后有明确的负责人,会根据答案采取行动。
这些案例的共同点
把各行连起来读,同样的四个特点反复出现,没有一个和技术有关。
- 数据收集之前,问题就已经很具体。 “哪些患者有再入院风险?”能回答,也可能答不了。“从患者数据里找洞察”则无从回答。
- 数据本来就存在,是业务的副产品。 收银机、GPS 设备和传感器不管有没有人分析,都在产生记录。项目是把它们拼起来,而不是从零开始采集。
- 难点是把数据源拼起来。 价值来自把天气和销量拼在一起,或把传感器和维修记录拼在一起。大部分功夫花在匹配标识和修正格式上,这个问题见数据管道。
- 结果能闭环。 预测改变订货,欺诈评分拦下支付,维护告警预约工程师。衡量成败的是决策,不是看板。
如果你自己的项目缺“问题具体”这一点,规模帮不上忙;缺“结果闭环”这一点,你是在建档案库。这些特点怎样放进整体规划,见数据策略。
怎样判断你要不要用大数据工具
先做算术。估算每月事件数、每个事件的字节数,再算一年的存储量。
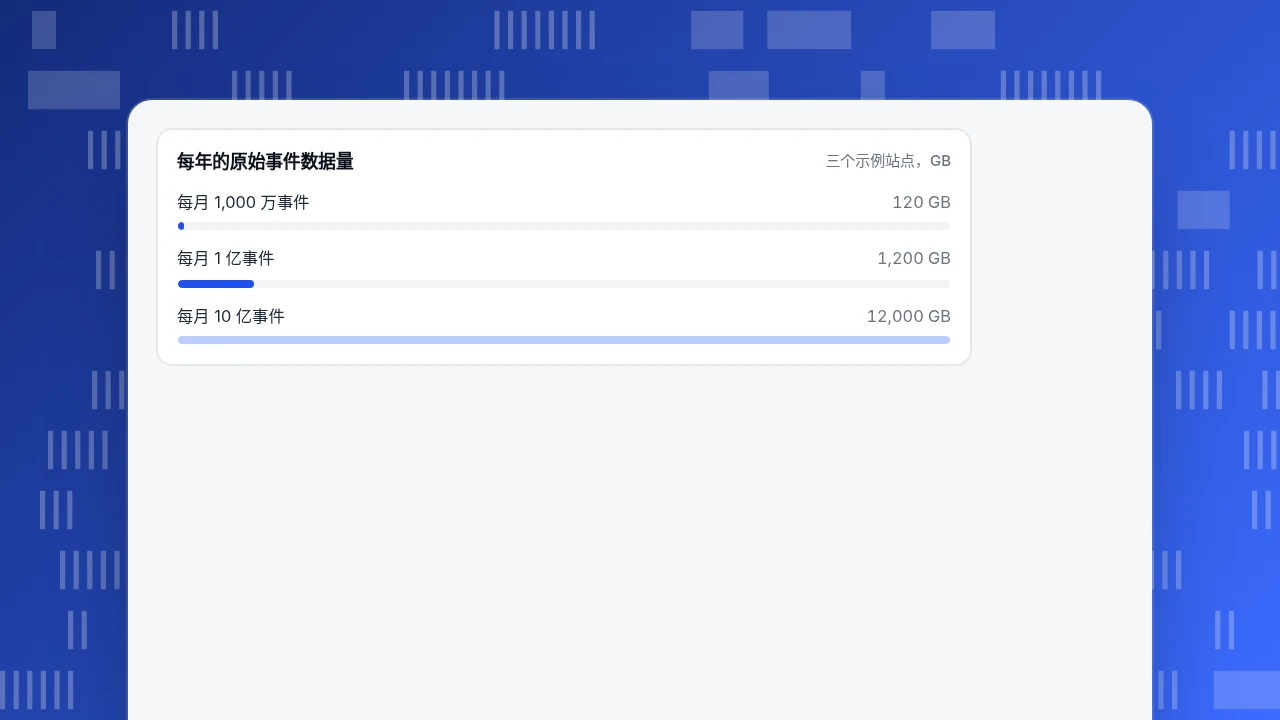
示例数据:一家网店每月 400,000 次会话,每次会话约 25 个被记录的事件,每月 400,000 × 25 = 10,000,000 个事件。按偏宽的每个原始事件 1,000 字节算,每月 10 GB,一年 120 GB。一块笔记本硬盘可以装下很多倍。下表展示同样的算术放大后的结果:
| 每月事件数 | 每月原始大小 | 每年原始大小 | 答案在哪里改变 |
|---|---|---|---|
| 1,000 万 | 10 GB | 120 GB | 一个数据库或一台机器绰绰有余 |
| 1 亿 | 100 GB | 1.2 TB | 仍是一台机器,但要规划索引和汇总表 |
| 10 亿 | 1 TB | 12 TB | 数据仓库或分布式引擎开始划算 |
每个事件 1,000 字节和表里的分界线都是工作假设,不是标准;压缩后的列式存储往往小好几倍。请用你自己的事件大小重算一遍。
有两处修正能让估算更诚实。其一,只算你打算保留的部分:如果只保存最近 13 个月的明细、其余做汇总,存储量就不会逐年增长。其二,按最忙的一个月算,不要按平均值算。如果旺季流量是平时的三倍,就按那个月 3,000 万个事件来规划,同样的事件大小是 30 GB。对多数网站,这两处修正不会改变结论,但能避免把一次性的高峰误当成长期需要集群。
模型更小。一个流失预测模型有 50,000 个账户、40 个数值特征,每个数用 8 字节存,共 50,000 × 40 × 8 = 16,000,000 字节,也就是 16 MB,现在任何一台笔记本都能装进内存。
分布式也有代价。McSherry 等人一篇被广泛引用的论文定义了“COST”,指分布式系统要用多少硬件才能超过一个写得好的单线程程序;在他们报告的负载上,几个已发表的系统需要数百个核心,有的始终赢不了。买集群之前,先在一台机器上试一下这个问题。
每年的原始事件数据量
三个示例站点,GB大数据案例的小数据版本
多数中等规模的团队,可以把每个案例按一个数据库装得下的规模做一遍。做法是保留问题,缩小数据。
| 大数据案例 | 小数据版本 | 典型规模 |
|---|---|---|
| 给每位观众的下一项推荐 | 用最近 12 个月订单统计“买过这个的人还买了” | 一张订单明细表 |
| 对多年历史做欺诈评分 | 按订单金额、收货地不一致、同一张卡反复失败设规则,每周复核 | 每天几千笔订单 |
| 成千上万传感器的预测性维护 | 某个读数持续超过上限一段时间就告警 | 几台设备,每台一个读数 |
| 按门店和商品做需求预测 | 取去年同一周的销量,再按近期趋势调整 | 每个商品的周合计 |
| 对全部用户事件做漏斗分析 | 统计 30 天窗口内到达每一步的用户数 | 几千万个事件 |
最后一行是多数网站团队最先遇到的,它不需要特殊平台:产品分析工具本来就能存储并查询这个规模的事件数据。
大数据分析的常见误区
- 从平台开始。 还没想好要支持哪个决策就买基础设施,结果是一套昂贵的系统没人用。
- 把数据量当成价值。 上面 120 GB 的数据,能回答的业务问题可能比一份没人关联订单的 12 TB 日志还多。
- 忽略关联键。 如果访客、订单和客服工单没有共同的 ID,加再多数据也只是加噪声。
- 忽略时效。 每天跑一批对规划库存够用,对拦截欺诈毫无用处。选工具之前先定答案要多新。
- 把预测当成目标。 能预测流失却不触发任何行动的模型,不会改变任何数字。
- 忘记隐私。 关联的数据源越多,识别出个人的可能性越大;只收集问题需要的数据。
TapCub 能帮上什么
还是用前面那家店:每月 1,000 万个事件,问题是“购物者在商品页和付款之间从哪里离开”。这个规模不需要数据团队,TapCub 就能处理。
- 采集事件。 装上脚本,发送需要的事件(浏览商品、加入购物车、开始结账、购买)。在 全端分析 › 数据管理 › 事件与属性 里定义它们。
- 回答问题。 在 全端分析 › 行为分析 › 行为分析 里建漏斗,再按设备或渠道拆开,看漏在哪一步。
- 需要时用 SQL。 漏斗不够用时,全端分析 › 行为分析 › 自定义指标与 SQL 可以直接查询事件数据,也能定义自己的指标。
- 规模超出时导出。 全端分析 › 数据管理 › 数据导出 会异步导出原始明细,交给你自己的数据仓库。导出的是保留期内的事件。
- 了解边界。 TapCub 不做分布式计算,不训练机器学习模型,也不替你关联财务和客服系统。它衡量网站、应用和聊天里的行为;其余留在你自己的技术栈里。
常见问题
大数据分析有哪些例子?
零售商按门店预测需求,电信运营商预测哪些基站会过载,银行给刷卡支付做欺诈评分,能源公司根据传感器预测设备故障,医疗机构估计再入院风险。每个例子都从一个具体问题开始,拼接多个数据源,最后落到订货、拦截或排检修这样的决策上。
怎么判断自己的数据算不算大数据?
拿它和一台机器比。如果原始数据放得进一块硬盘,查询几分钟就跑完,那对你来说就不算大,不管数字本身是多少。用每月事件数乘每个事件的字节数再乘 12 估算;每年几十到几百 GB,仍属于普通数据库的范围。
小企业需要大数据分析吗?
一般不需要那套工具,但需要这个习惯:具体的问题、拼起来的数据、一个决策。每月 1,000 万个事件的店铺,用标准的分析产品就能做漏斗、留存和分群,其余用表格补充。
大数据和数据分析有什么区别?
大数据说的是数据的规模和形态;分析是把数据变成答案的工作。小数据也能做分析,大数据也可以只存不分析。一个大数据分析案例两者都要有。
资料来源
- NIST。NIST 大数据互操作框架第 1 卷:定义(SP 1500-1r2),按体量、种类、速度和多变性给大数据下的定义。
- Frank McSherry、Michael Isard 和 Derek Murray。Scalability! But at what COST? HotOS XV,2015,分布式系统的 COST 度量。
- Jeffrey Dean 和 Sanjay Ghemawat。MapReduce: Simplified Data Processing on Large Clusters,Google,2004,跨机器处理超大数据集的编程模型。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
