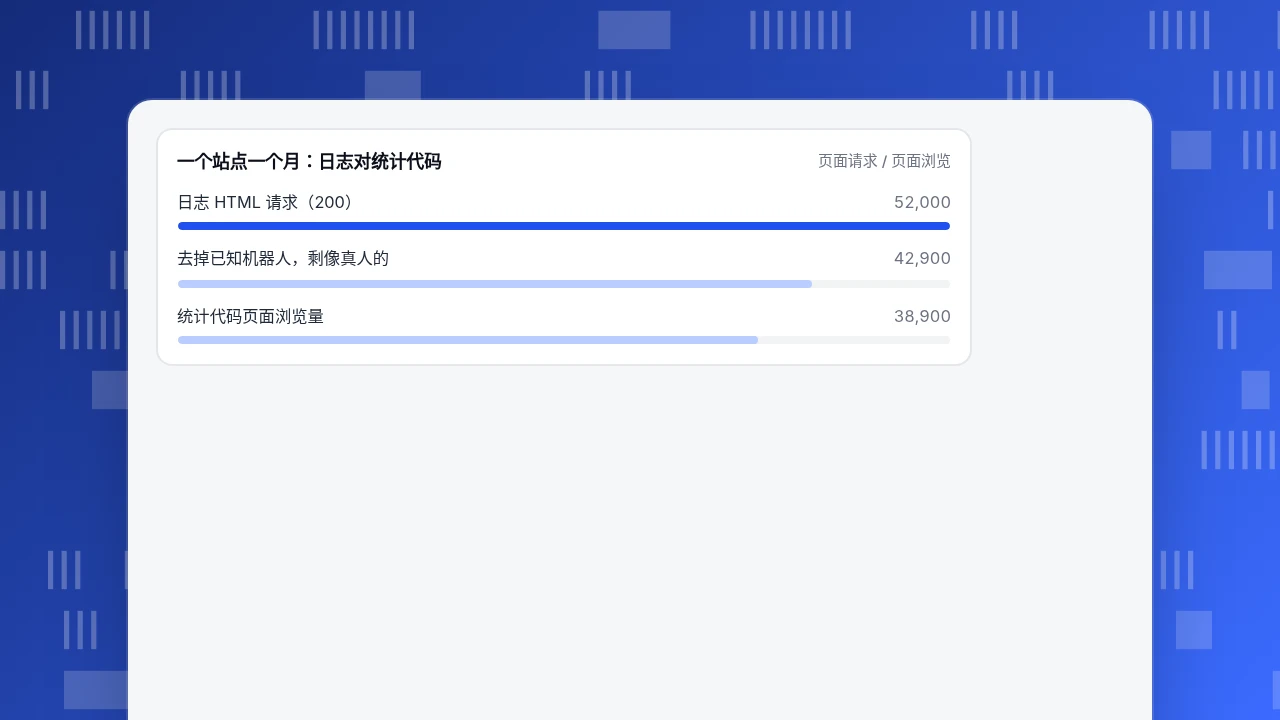
网站流量分析工具分四类,每类数的东西不同:站内统计数浏览器上报的内容,服务器日志数每一个请求,搜索数据数搜索展现和点击,样本估算工具则给别人的网站建模。按问题选类型,然后核对。下面的示例里,52,000 个日志请求去掉已知机器人后剩 42,900 个,对应统计代码里的 38,900 个页面浏览。
读完你会知道
- 按问题选工具类型:自己的访客需要自有数据,竞争对手只有估算
- 先拿一周的数据把日志、统计代码和搜索数据核对一遍,再相信其中任何一个
- 样本估算只用来比较竞争对手彼此,不要用在自己的报告里
网站流量分析工具有哪几类?
网站流量分析工具分四类,它们回答的问题不同,因为数的东西不同:站内统计代码数的是它在浏览器里能看到的访问;服务器日志数的是服务器收到的请求;搜索数据数的是你的页面在搜索结果里的展现和点击;基于样本的估算工具则为不属于你的网站建模估计流量。没有哪一类是另一类的升级版。如果其中两类对不上,通常恰恰说明同时用两类是有道理的。拿到工具之后怎么读数字,见网站流量分析;想看分析产品的长篇对比,见网站分析工具。这篇讲的是先选类型。
| 类型 | 数的是什么 | 需要你的网站代码吗 | 能看竞争对手吗 | 典型盲区 |
|---|---|---|---|---|
| 站内统计(代码或脚本) | 浏览器里看到的访问、页面、来源、事件和目标 | 需要 | 不能 | 被拦截的脚本、拒绝同意的访客、没有 JavaScript 的访客 |
| 服务器日志 | 服务器处理的每一个请求 | 不需要,但要能拿到日志 | 不能 | 机器人和静态资源混在一起;不配置就没有来源页和用户代理 |
| 搜索数据 | 你的页面在搜索里的展现、点击和排名 | 要验证站点 | 不能 | 只有搜索;有些查询被省略;有延迟 |
| 样本和建模估算 | 任意域名的建模访问量 | 不需要 | 能 | 是估算;小站点不准 |
| 类型 | 数的是什么 | 典型盲区 |
|---|---|---|
| 站内统计 | 浏览器里看到的访问、来源、事件和目标 | 被拦截的脚本、拒绝同意 |
| 服务器日志 | 服务器处理的每个请求 | 机器人和资源混在一起;没有转化 |
| 搜索数据 | 搜索里的展现、点击和排名 | 被省略的查询;有 2 到 3 天延迟 |
| 样本和建模估算 | 任意域名的建模访问量 | 是估算;小站点不准 |
每类回答的问题不同,见文中的矩阵。
每类工具能回答什么问题?
按问题选类型,不要按品牌选。下面这张矩阵把九个常见问题对应到能如实回答它的类型。
| 问题 | 站内统计 | 服务器日志 | 搜索数据 | 样本估算 |
|---|---|---|---|---|
| 上周有多少人来过? | 能(代码看到的) | 只有请求数,不是人数 | 不能 | 只有估算 |
| 哪个渠道带来了转化的访客? | 能 | 不能(没有转化事件) | 只限搜索 | 不能 |
| 访客从哪些页面进、从哪些页面走? | 能 | 只有请求 | 只有来自搜索的落地页 | 不能 |
| 哪些搜索词带来了点击? | 不能 | 不能 | 能(有省略) | 不能 |
| 我的流量里有多少是机器人? | 只有识别出的 | 能(有日志用户代理的话) | 不能 | 不能 |
| 爬虫访问了哪些页面? | 爬虫不运行脚本就看不到 | 能 | 不能 | 不能 |
| 流量下降是统计丢了,还是真的降了? | 和日志对照 | 能 | 对照搜索点击 | 不能 |
| 竞争对手的网站有多大? | 不能 | 不能 | 不能 | 能(粗略) |
| 一次活动带来转化了吗? | 能,用 UTM 和目标 | 不能 | 不能 | 不能 |
表里有两个规律:你自己的问题要用自有数据源,竞争对手的问题只有估算。用对的来源回答对的问题,不要把它们的数字画在同一张图里。
为什么这些工具的数字对不上?
对不上是因为它们数的东西不同,出错的方式也不同。三个事实可以框住差距。
- 相当大比例的请求不是真人。 Imperva 的 2025 年恶意机器人报告给出的数字是:自动化流量占全部网络流量的 51%,恶意机器人占 37%。日志会记下这些请求,而统计代码大多不会为它们触发。
- 日志只有服务器写下的东西。 在 Apache 的通用日志格式里,一行只有客户端地址、时间、请求行、状态码和响应大小;来源页和用户代理只出现在组合格式里,或需要你自己加。
- 搜索数据不全,还有延迟。 Google 的 Search Console 文档说,为保护隐私有些查询会被省略,表格最多显示 1,000 行,数据通常在 2 到 3 天后可用。
示例数据:对一个站点核对一个月的数据。
| 来源 | 读数 | 核对 |
|---|---|---|
| 服务器日志,状态码 200 的 HTML 请求 | 52,000 | |
| 其中按用户代理识别为已知机器人 | 9,100(17.5%) | 52,000 − 9,100 = 42,900 个像真人的请求 |
| 统计代码的页面浏览量 | 38,900 | 42,900 − 38,900 = 差 4,000(占 42,900 的 9.3%) |
| Search Console 点击 | 7,800 | 统计里自然搜索会话 7,100;7,100 ÷ 7,800 = 0.91 |
| 基于样本的访问量估算 | 31,000 | 代码显示 21,400 个会话;31,000 ÷ 21,400 = +45% |
怎么读:去掉已知机器人,就解释了日志和统计代码之间的大部分差距;剩下的 4,000 个请求(9.3%)就是被拦截的脚本、拒绝同意、缓存页面、不跑 JavaScript 的客户端和没识别出来的机器人所在的范围。Search Console 点击和统计里的自然搜索会话很接近(0.91),这个差距合理,因为有些搜索点击不会变成一次被记录的访问(脚本被拦或页面被关掉)。样本估算比代码计数高 45%,所以样本数字只拿来给竞争对手排名,绝不要用在你自己的报告里。
一个站点一个月:日志对统计代码
页面请求 / 页面浏览有什么规则决定该信哪个数字?
按这个顺序:
- 自己的访问量信统计代码,但先和日志对照:如果代码在像真人的日志请求的大约 10% 以内(这是对示例的工作规则,不是行业基准),它就是健康的。如果低得多,说明代码在某些页面坏了或被拦了。
- 机器人信日志,因为日志能看到不运行脚本的请求。
- 搜索词信搜索数据,并预期会有省略和 2 到 3 天的延迟。
- 竞争对手用估算,标明是估算,比较比例而不是绝对值。
写下哪个来源回答哪个问题,这样一个月后就没人把日志数和代码数放在同一张图里了。
统计代码少算了,原因怎么逐项查?
当统计代码低于像真人的日志请求时,按下面的顺序查原因,先查成本最低的:
| 原因 | 怎么查 | 怎么改 |
|---|---|---|
| 某些模板上没有代码 | 按页面类型看差距;某个模板差距为全部,就是没装代码 | 加到共用的布局里 |
| 单页应用没有上报路由切换 | 日志里 HTML 请求很多,但代码里每次访问只有一个页面浏览 | 每次路由切换时发一个页面浏览 |
| 脚本被浏览器或扩展拦截 | 装了拦截工具的桌面浏览器上差距更大 | 接受这个差距,或为关键动作加一个服务端事件 |
| 访客拒绝了同意 | 差距出现在横幅改动之后,或只出现在需要同意的地区 | 弄清你的同意设置让你落在哪个档位,并如实报告差距 |
| 日志计数里有没识别出的机器人 | 看日志里的用户代理和每个 IP 的请求频率 | 扩充机器人名单并重新计数 |
每一行都有可观察的症状,这样你能用证据解释差距,而不是猜。
第一步该选哪一类?
按你的处境选类型,不要四类都买。
| 处境 | 先用 | 再加 |
|---|---|---|
| 新站点,没有数据 | 站内统计 | 搜索数据 |
| 流量下降,不知道为什么 | 搜索数据和日志 | 统计代码,用来对照 |
| 机器人或爬取流量很多 | 服务器日志 | 能把机器人分开的统计工具 |
| 付费投放 | 带 UTM 和目标的站内统计 | 花费导入(如果有) |
| 给方案做竞争对手基准 | 样本估算 | 你自己网站的自有数据 |
| 受众对隐私敏感 | 不记 IP 的站内统计 | 日志,如果服务器是你的 |
一个合理的默认做法:站内统计加搜索数据,就能回答大多数问题,日志用来在两者对不上时当裁判。哪个问题需要,再加其他的。
估算到底能告诉你什么?
样本和建模估算融合了几类输入。某厂商的数据说明页列出了:来自自有统计的直接测量、安装在设备上的软件提供的匿名数据、公开数据和合作伙伴数据,并说它把这些信号外推成对线上活动的描述。这是一个模型,所以每个数字都要当成一个范围。
实际用法:先把估算和你自己的实际数据对比一次。如果估算工具说 31,000 次访问,你的代码说 21,400,你就知道它对你这类站点大约偏高 45%。这个比例只能用在同一体量的竞争对手上,作为粗略的合理性检查;不要把结果当事实引用。
一个下午怎么检查自己的设置?
一次简短的核对能发现大部分统计错误:
- 选一周和一类页面(例如文章页)。
- 数出这一周像真人的日志请求,先去掉已知机器人的用户代理。
- 和同一批 URL 的统计页面浏览量对照。 把差距记成百分比。
- 把同一周的 Search Console 点击和统计里的自然搜索会话对照。
- 统计代码、同意横幅或 CDN 有任何改动后再查一次。
把百分比连同日期记在一张表里。下个月的差距会告诉你有没有东西坏了。
在 TapCub 里怎么做?
从上面的核对表出发,站内和机器人这两行用 TapCub 来做。
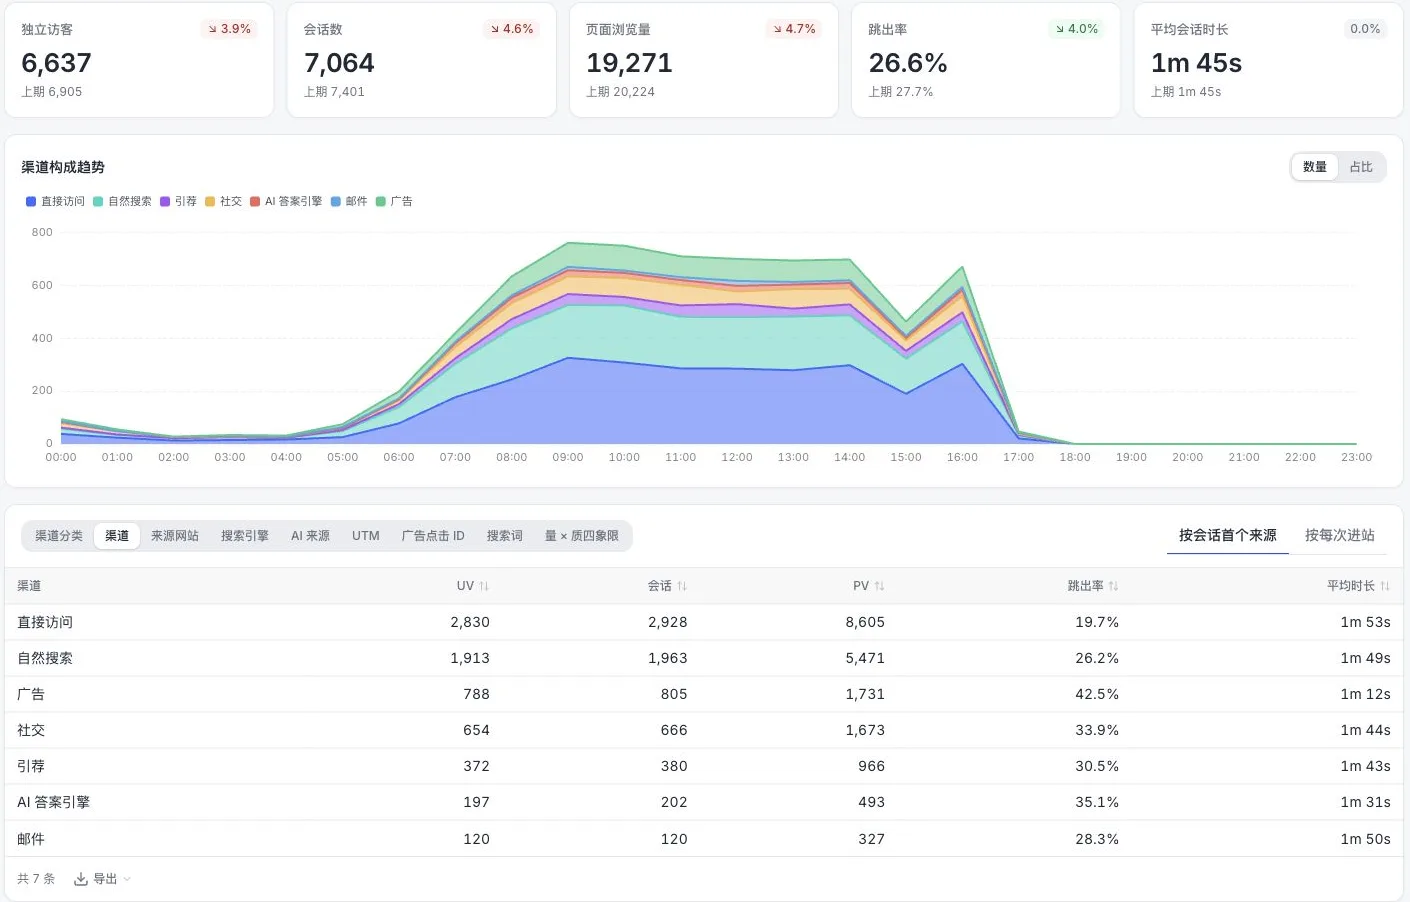
- 站内统计。 一段脚本给出访客、页面和来源。网站统计 › 来源把流量拆成渠道、来源和 UTM 参数;网站统计 › 页面显示访客从哪些页面进、从哪些页面走。
- 机器人,分开统计。 网站统计 › 机器人有三个页签:AI 与智能体、全部机器人和访问记录。新项目会识别机器人并只计入这张报表,所以不会抬高访客数,也不会拉低转化率。这就是核对表里机器人那一行,在统计代码处测量,而不是从日志里推测。
- 搜索词。 在监测 › 搜索表现里连上 Google Search Console 或 Bing Webmaster,按页面、查询词和国家看点击、展现、点击率和平均排名;数据通常晚 1 到 3 天。
- 日志。 全端分析 › 数据管理 › 数据导入接受 Nginx 和 Apache 日志,每个文件最多 100,000 行。日志导入会跳过爬虫,爬虫数据走服务端接口;不要指望导入的日志能复现上面的机器人数。
- 它不做什么。 TapCub 不估算竞争对手的流量。这件事请用样本估算工具,并且别把它放进你自己的报告里。
FAQ
什么是网站流量分析工具?
它们衡量有多少人访问网站、从哪里来、做了什么。主要类型是站内统计、服务器日志、搜索数据和基于样本的估算;每类数的东西不同,所以按问题选类型。
统计工具和服务器日志有什么区别?
统计代码数的是浏览器能上报的东西,所以能看到人、来源和事件,但会漏掉被拦截的脚本和大部分机器人。日志记录服务器处理的每个请求,包括机器人和静态资源,但没有转化事件。
网站流量估算准吗?
估算是建模得到的,不是测出来的,在小网站上最不可靠。像示例那样(31,000 对 21,400)先和你自己的实际数据对比一次,之后只用它来比较竞争对手之间的相对大小。
网站流量里有多少是机器人?
Imperva 的 2025 年报告给出自动化流量占网络流量的 51%,恶意机器人占 37%。你自己的比例会不同;请看你网站的日志或机器人报告,因为机器人比例高会抬高访问数、拉低转化率。
需要不止一个工具吗?
通常要两个:站内统计看访客和转化,搜索数据看查询词。数字对不上时加日志,只有比较竞争对手时才加样本估算工具。
资料来源
- Imperva。2025 年恶意机器人报告:自动化流量 51%,恶意机器人 37%。核对于 2026-11-20。
- Apache HTTP Server 项目。日志文件:通用日志格式的字段;来源页和用户代理只在组合格式里,或需自己添加。核对于 2026-11-20。
- Google。Search Console:关于数据:被省略的查询、1,000 行上限、2 到 3 天的延迟。核对于 2026-11-20。
- Similarweb。我们的数据:直接测量、设备样本、公开和合作伙伴数据、外推。核对于 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
