你看不到竞争对手网站的精确流量,只能看到估算和排名,二者都有误差。公开方法量的东西各不相同,排名每天都在动,而且英文维基百科 2025 年约三分之一的请求不是真人。在相信你和竞争对手之间的差距之前,先用你知道流量的站点校准估算工具。
读完你会知道
- 精确流量只存在于所有者自己的统计里;从外部看到的是模型估算、排名或遥测数据
- 排名每天都在动(前 40 名的域名在 39 天里波动达 29%),英文维基百科 2025 年计入的请求有 35.6% 不是用户流量
- 用三个你知道流量的站点测试估算工具;只有差距超过你测出的比值范围,才相信它
到底能不能看到竞争对手网站的流量?
看不到精确值。精确的访问人数只存在于站点所有者自己的统计里,所以从外部看到的一切都是估算或排名。真正该问的不是「他们的流量是多少」,而是「这个估算可能错多少,我们之间的差距是不是大到能扛住这个误差」。
有一个例外,可以帮你校准预期:维基媒体自己公开发布页面浏览量,所以你能把一个真实的、所有者公布的数字,和外部估算工具会给出的数字放在一起看。下面会用到它。
有哪些方法能估算别人的流量?各自量的是什么?
公开数据大致分五类,各自量的东西略有不同,这就是两个工具对同一个网站给出不同数字的原因。
| 方法 | 数据来自哪里 | 你能得到什么 | 主要局限 |
|---|---|---|---|
| 混合样本估算 | 一家服务商自述会混合站点所有者的第一方统计、安装在数百万台设备上的软件采集的匿名数据、公开数据和合作伙伴数据 | 访问量估算,通常按月 | 是模型输出;具体到某个站点时样本和合作数据的占比不公开 |
| 基于 DNS 的排名 | Cloudflare Radar 根据其公共 1.1.1.1 解析器上匿名化的查询给域名排名;指标是查询该域名的用户群体的估计规模 | 有序的前 100 名,之后是从前 200 到前 1,000,000 的无序排名区间 | 区间内部不排序;统计的是解析器用户的查询,不是访问 |
| 聚合榜单 | Tranco 把多家提供方过去 30 天的排名平均,合成一份一百万个域名的榜单 | 每个域名一个排名 | 为了稳定而设计,但仍然只是排名 |
| 浏览器遥测 | Chrome 用户体验报告汇总符合条件的 Chrome 用户在公开可发现且足够热门的页面和源上的体验 | 性能分布,BigQuery 里有一个粗略的热门度区间 | 没有访问数;Chrome 不公布符合条件的用户占比 |
| 所有者公布的计数 | 所有者自己公开,例如维基媒体通过页面浏览量接口 | 精确的计数,区分用户和自动化流量 | 只有所有者愿意公开才有 |
仔细读第一行:服务商自己的描述说估算来自多种来源的组合,这意味着一个中等规模站点的数字依赖模型,不是计数。
在选工具之前怎么用这张表:先决定你在问哪个问题。如果问的是「谁大得多」,一个排名区间可能就够了,而且不花钱。如果问的是「大约有多少次访问」,你需要混合估算,并做下面的校准。如果问的是「他们的网站对真实用户加载有多快」,浏览器遥测直接就能回答,根本用不到访问量的估算。让问题和方法对上,就能消除人们对流量工具的大部分失望,因为多数失望来自要求一个排名表现得像一个计数。
| 方法 | 量的是什么 | 给你什么 | 主要局限 |
|---|---|---|---|
| 混合样本估算 | 站点所有者统计、设备软件、公开和合作数据的混合 | 月访问量估算 | 模型输出;具体站点的数据占比不公开 |
| 基于 DNS 的排名 | 公共解析器上查询某域名的用户群体的估计规模 | 有序前 100 名,之后是无序区间 | 是查询不是访问;区间内无顺序 |
| 聚合榜单 | 多个排名在 30 天内的平均 | 每个域名一个排名 | 是排名,不是计数 |
| 浏览器遥测 | 符合条件的 Chrome 用户在热门公开页面上的体验 | 性能数据、粗略的热门度区间 | 没有访问数 |
| 所有者公布的计数 | 所有者自己的页面浏览量 | 按访问者类型区分的精确计数 | 只有所有者公布才有 |
描述取自各服务商自己的文档,核对于 2026-11-20。
流量估算可能错多少?
我们没有找到公开、独立、拿已知流量检验商业估算工具的准确度研究,所以本文不引用误差百分比。公开数据能说明的是:连排名都很不稳定,而且网络流量里有很大比例不是真人。
排名每天都在变。 我们在 2026-11-19 查询了五个域名的 Tranco 排名历史,共 39 份每日榜单,从 2026-10-12 到 2026-11-19:
| 域名 | 排名数最小(靠前) | 排名数最大(靠后) | 波动 |
|---|---|---|---|
| wikipedia.org | 31 | 40 | 29.0% |
| nytimes.com | 154 | 163 | 5.8% |
| mozilla.org | 89 | 95 | 6.7% |
| example.com | 165 | 186 | 12.7% |
| sciencedirect.com | 216 | 235 | 8.8% |
波动 =(靠后值 − 靠前值)÷ 靠前值。这些域名位于一份专门为稳定而设计的榜单的前列,排名仍然会移动,最多接近一成。Tranco 的作者指出,被他们合并的各个排名对哪些域名最热门意见不一,每天可能大幅变化,也可能被人为操纵。
很大一部分请求不是真人。 维基媒体的接口按两种访问者过滤,给出 2025 年英文维基百科的页面浏览量。「用户」浏览量合计 85,541,514,536;「全部访问者」合计 132,913,760,903。所以 85.54 ÷ 132.91 = 64.4% 的计入浏览是用户流量,35.6% 来自爬虫和自动化访问者(按维基媒体自己的识别)。一个分不开这两者的工具会高估真人访问,而你从外部无法判断某个估算工具偏向哪一边。
算例:用你知道真实流量的站点校准估算工具
示例数据。要给估算工具标上误差范围,只能在你知道真实数字的站点上测试它。选三个你自己的站点或你有统计权限的站点,查出估算工具给出的月访问量,再相除。
| 站点 | 真实月访问量 | 估算工具给出 | 比值(估算 ÷ 真实) |
|---|---|---|---|
| A | 42,000 | 61,000 | 1.45 |
| B | 8,500 | 3,100 | 0.36 |
| C | 120,000 | 98,000 | 0.82 |
三个比值的几何平均是 0.76,所以平均来看这个工具偏低,但单个比值从 0.36 到 1.45,最严重的低估和最严重的高估相差 4.0 倍。现在套用:
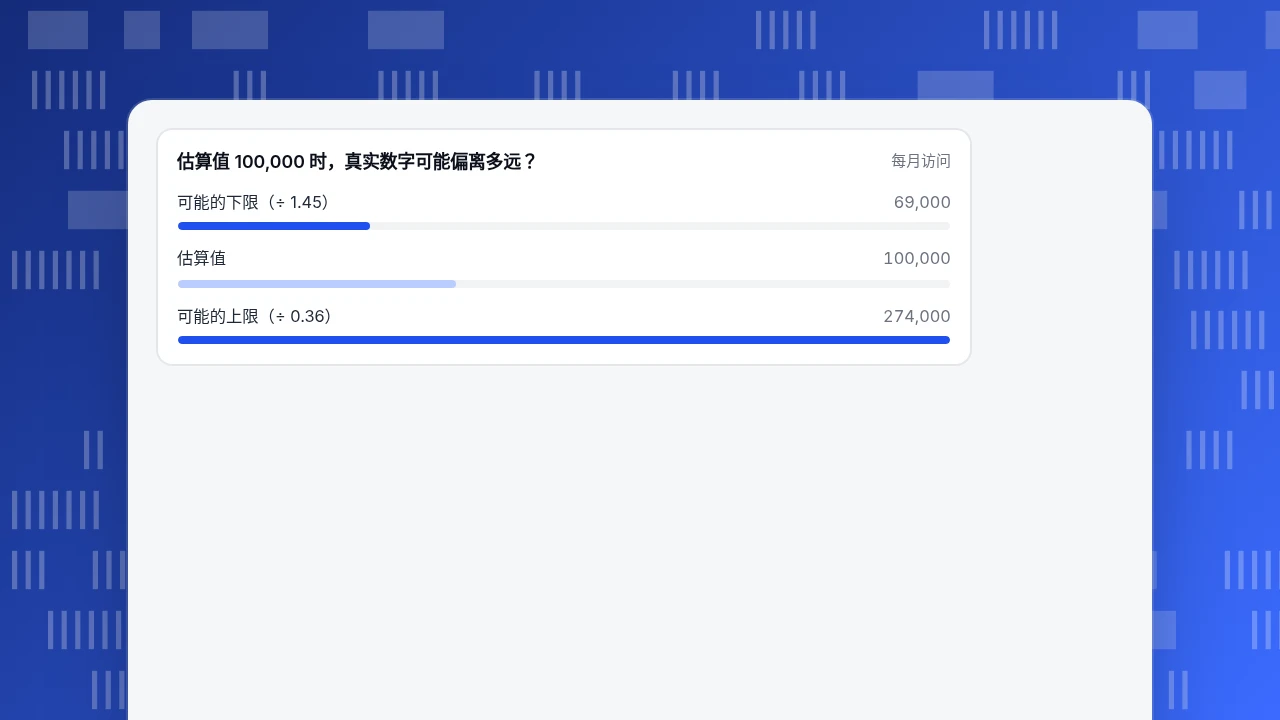
- 某个竞争对手的估算是 100,000 次访问。真实流量可能是 100,000 ÷ 1.45 = 约 69,000,一直到 100,000 ÷ 0.36 = 约 274,000。
- 你自己的统计是 60,000。只有当估算 ÷ 1.45 > 60,000,也就是估算高于 87,000(60,000 × 1.45)时,对方才一定更大。
- 只有当估算 ÷ 0.36 < 60,000,也就是估算低于 21,600(60,000 × 0.36)时,对方才一定更小。
- 在 21,600 到 87,000 之间,诚实的回答是「无法判断」。这里的 100,000 在不确定区间之外,所以「他们比我们大」是安全的,但「他们是我们的四倍」不安全。
三个测试站点样本很小,条件允许就多用几个,并且尽量选和竞争对手规模相近的站点,因为准确度可能随规模不同;在这个样本里最小的站点偏差最大,不过三个站点说明不了什么。
估算值 100,000 时,真实数字可能偏离多远?
每月访问不依赖访问量估算,还能看到什么?
用不依赖估算模型的信号。
- 是否出现在浏览器遥测里。 CrUX 只收录公开可发现、且达到一个未公布的热门度门槛的源。如果竞争对手的源出现在 CrUX(例如通过 PageSpeed Insights 能看到),说明它有足够多的 Chrome 访客可以被测量;这是下限,不是计数。
- 把排名区间当数量级。 位于 Cloudflare Radar 前 10,000 区间的站点和位于前 1,000,000 区间的站点,在解析器热门度上差几个数量级。不要在同一个区间内部排名次,因为区间内的内容是有意不排序的。
- 看方向,不看水平。 用同一个工具比较同一个站点的逐月变化。校准比值在月与月之间可能比各工具之间的水平更稳定。这是一个工作假设,请用你自己已知的站点验证。
- 看已公布的数字。 查看所有者是否公布过什么:公开统计页、接口、财报或媒体资料。维基媒体展示了精确的样子。
- 看来源构成,不看量。 问他们的流量从哪来(搜索、直接、引荐、社交),而不是有多少。你自己的来源报表提供了对照的形状。
接受误差范围之后值得比较哪些指标,见竞品对标;查自己站点的流量见如何查看网站流量。
哪些能精确测量?TapCub 放在哪一步?
TapCub 看不到竞争对手的流量。它精确测量你自己的站点,而这正是校准和对比的前提。
- 在网站统计 › 概览里记下你每月的访客和会话。因为识别出的机器人和 AI 爬虫在网站统计 › 机器人里单独统计,你的真人数据不会被自动化流量抬高,这正是维基媒体例子说明很重要的那种区分。
- 在你打算用的估算工具里查你自己的域名,按上表相除。对其他你经过授权能访问的站点也这样做,得到比值范围。
- 在网站统计 › 来源里看你按渠道和 UTM 的构成。用它来对比你的流量形态和你能推断的竞争对手形态,而不是比较总量。
- 用配置 › 日期标注在图表上标出发版和活动,免得把你自己数据的跳升误当成市场变化。
- 想给合作方或投资人看你的真实数字时,通过配置 › 设置 › 公开分享分享选定模块的只读视图。
常见问题
能精确看到竞争对手有多少流量吗?
不能。精确计数只存在于所有者自己的统计里,或者所有者公布时才有,如维基媒体。其他一切都是模型估算或抽样数据的排名,要带着误差范围来读。
网站流量估算工具有多准?
我们没有找到量化它的公开独立研究,所以请自己测试。在示例校准里,三个已知站点的比值在 0.36 到 1.45 之间,相差四倍。用三个或更多你能核实的站点校准,尽量和竞争对手规模相近。
前一百万名榜单等于流量吗?
不等于。它按热门度信号排名,例如 DNS 解析器上的查询或多家提供方排名的平均,不是按访问量。排名每天可能变化,在 Cloudflare 的榜单里区间内的顺序是有意不公开的。
竞争对手的流量包含机器人吗?
取决于工具,而工具通常不会告诉你。维基媒体的数据显示,英文维基百科 2025 年计入的请求里 35.6% 不是用户流量,所以把自动化请求算进去的估算工具会高估真人访问。
和竞争对手比较,什么比原始流量更好用?
方向和构成。在同一个工具里逐月跟踪同一个站点,比较来源构成,把你自己的精确数字当锚点。只有差距大于你的校准范围时才用估算。
资料来源
- Similarweb。Our data,服务商对其混合数据来源的描述。核对日期 2026-11-20。
- Cloudflare。Goodbye, Alexa. Hello, Cloudflare Radar Domain Rankings,基于解析器的热门度和无序区间。核对日期 2026-11-20。
- Tranco。A research-oriented top sites ranking hardened against manipulation,30 天平均、每日不稳定和可被操纵的研究结论;排名历史于 2026-11-19 通过其接口查询。
- Google Chrome。CrUX methodology,用户、源和页面的收录条件。核对日期 2026-11-20。
- Wikimedia。Pageviews analytics API,en.wikipedia 的月浏览量,
user与all-agents,于 2026-11-20 查询。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
