API 是向某个服务发送数据的约定,SDK 是替你调用这个约定的库,并增加排队、重试和清理。埋点时,页面行为用浏览器 SDK 发送,资金和账户事件从你的服务器带幂等键发送,因为只有接收方能认出同一个事件,重试才是安全的。
读完你会知道
- SDK 通常是对 API 的封装;真正的选择是调用在哪里运行,以及你要自己承担多少底层代码
- 资金和账户事件从你的服务器发送,访客拦截不了,并加上订单号这样的幂等键
- 把会话 ID 随服务端事件一起发送,让它们关联到引发它们的那次访问
SDK 和 API 有什么区别?
API 是约定:向某个服务发送数据的地址、字段和规则。SDK(软件开发工具包)是针对某种语言或平台写好的库,替你去调用这个约定。对埋点来说,SDK 通常做的是琐碎的部分:组装请求、把事件排队、失败时重试、清理取值。直接用 API 则是同一个接口,但这些都得你自己写。
所以「用 SDK 还是用 API」很少是在两个系统之间选,而是在选调用发生在哪里(浏览器、App 还是你的服务器),以及你想自己承担多少底层代码。SDK 的定义见 SDK;API 调用的具体步骤见用 HTTP 接口发送事件。
同一笔购买事件,两条路径各是什么样?
以一个事件为例:订单 1001,一笔 19.90 美元的购买。下面是三种发送方式。
浏览器 SDK。 页面上加载了网站脚本,一行代码在访客的浏览器里记录事件:
tapcub.track('purchase', { revenue: 19.9, currency: 'USD' });HTTP 接口。 你的服务器带着服务端密钥,把 JSON 发到业务事件接口:
curl -X POST "https://api.pathclue.com/api/v1/track" \
  -H "Authorization: Bearer wck_…" \
  -H "Content-Type: application/json" \
  -d '{"events":[{"event":"purchase","login_id":"u_123","insert_id":"order-1001","properties":{"revenue":19.9}}]}'
服务端 SDK。 某种语言的库(Node.js、PHP、Python、Java 或 Go)封装了同一个接口。你调用 track,库负责排队、分批发送并在失败时重试。
第一条路径运行在你控制不了的设备上,第二和第三条运行在你能控制的机器上。这一个差别决定了下一节里大多数取舍。
几条路径怎么对比?
| 浏览器 SDK | 服务端 SDK | 直接调用 HTTP 接口 | |
|---|---|---|---|
| 运行在哪 | 访客的浏览器 | 你的服务器 | 任何能发 HTTP 的地方 |
| 凭据 | 页面上的网站脚本,没有机密 | 服务端机密密钥,不放在页面上 | 服务端机密密钥 |
| 访客能不能拦截或伪造? | 能,拦截工具或改脚本都可能让它停止或被篡改 | 不能:它从你的服务器发出 | 从你的服务器发送就不能 |
| 分批和重试 | 由脚本处理,不用你管 | 内置:每 3 秒或积累到 200 条时发送,最多重试 5 次 | 你自己写 |
| 防重复 | 页面事件不是重点 | 传入你自己的键,如订单号 | 传入你自己的键 |
| 是否知道这次访问 | 知道,同一个页面和会话 | 只有传了会话 ID 才知道 | 只有传了会话 ID 才知道 |
| 适合 | 页面浏览、点击、滚动、表单曝光 | 订单、退款、注册、订阅变更 | 没有 SDK 的语言、脚本和后台任务 |
服务端密钥最关键:TapCub 文档说,订单、付款、退款和注册应该记录在你的服务器上,在那里它们不能被拦截或伪造。
| 事件 | 路径 | 原因 |
|---|---|---|
| 页面浏览 | 浏览器 SDK | 只有页面知道它发生了 |
| 按钮点击或滚动深度 | 浏览器 SDK | 交互数据在页面里 |
| 订单已付款 | 服务端,订单号为键 | 涉及资金,必须扛得住拦截和重试 |
| 退款已发出 | 服务端,退款号为键 | 发生在后台 |
| 注册完成 | 服务端,有会话 ID 就带上 | 由你的数据库确认,并关联到那次访问 |
| 订阅续费 | 服务端或后台任务直接调用接口 | 没有访客在场 |
经验规则:没有访客在场、或涉及资金变动的事件,从你的服务器发送。
每条路径会在哪里出问题?
浏览器。 页面可能在请求发出之前就消失了。MDN 把 navigator.sendBeacon() 描述为一种不拖慢页面卸载就能发送数据的方式,排队数据上限 64 KiB,并指出用 unload 和 beforeunload 事件发送统计数据不可靠,推荐改用 visibilitychange。好的浏览器 SDK 会遵循这个建议,但对一台你控制不了的设备,仍然不能保证送达。
服务端和直接调用接口。 失败的形态正好相反:请求其实到了,但响应没能传回来。HTTP 把一个方法定义为幂等,是指重复发送的效果和只发一次相同。RFC 9110 说,客户端不应该自动重试非幂等的请求,除非它知道这个请求实际上是幂等的,或者能检测到原请求从未被应用。埋点用的 POST 本身不是幂等的。没有一个你自己指定的键,看似安全的重试会多记一笔购买。
每个数据接收接口都有限制。 例如 Google 的 Measurement Protocol 限制每个请求最多 25 个事件、请求体 130 kB,并说它主要为服务端或可信环境设计,把浏览器端埋点引向 gtag.js 或 Tag Manager。无论你用哪个,设计批次之前先读你自己接口的限制。
算例:一次限时抢购,重试和重复
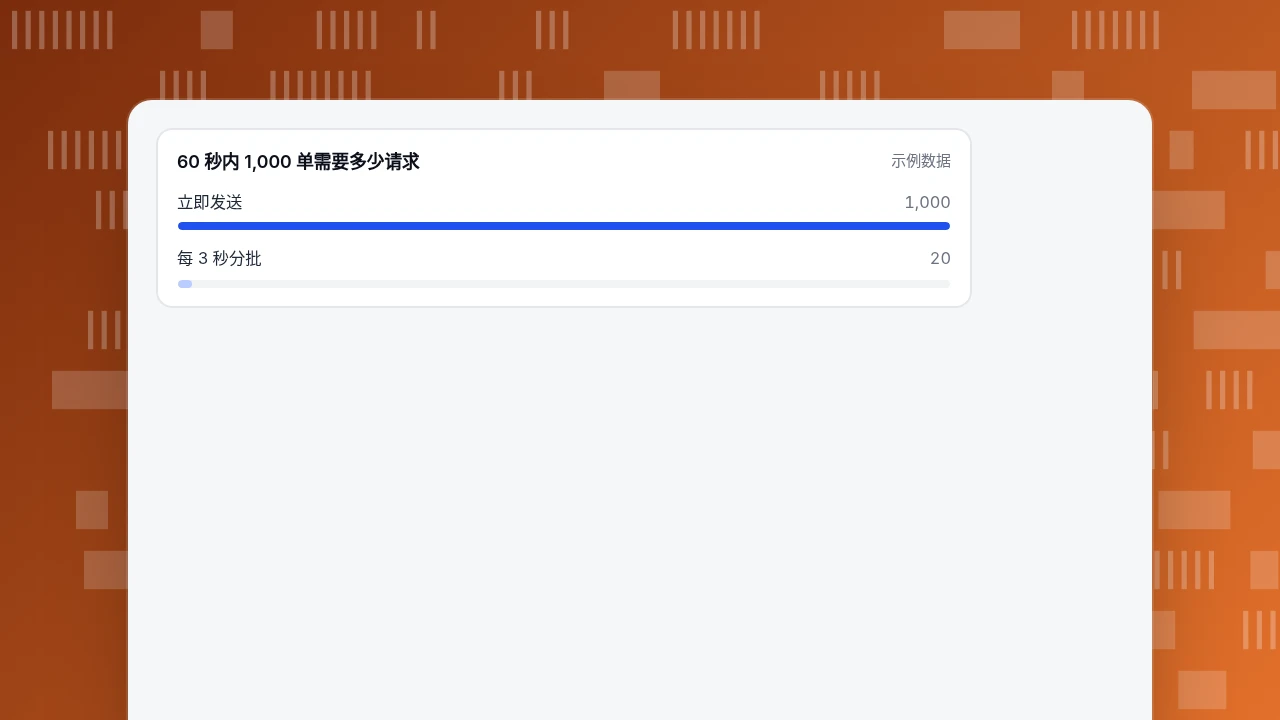
示例数据。一家网店在限时抢购的 60 秒内卖出 1,000 单,每单是一个约 300 字节的 19.90 美元购买事件。假设服务端 SDK 用默认的分批模式(每 3 秒或积累到 200 条时发送,每个请求最多 1,000 条事件和 1 MB)。
- 请求数。 订单每秒到达 1,000 ÷ 60 = 16.7 单。3 秒内约 50 条,远低于 200 条的触发线,所以先触发 3 秒定时器:60 ÷ 3 = 20 个请求,每个约 50 条事件。如果用立即发送模式,就是 1,000 个请求。
- 请求大小。 50 条 × 300 字节 = 15,000 字节,约 14.6 KiB,远低于每个请求 1 MB 的上限。
- 重试窗口。 指数退避从 0.5 秒起每次翻倍,五次重试等待 0.5 + 1 + 2 + 4 + 8 = 15.5 秒后放弃,所以短暂的网络抖动会被吸收,你的代码不用做任何事。
- 重复。 假设某个批次被服务器接收了,但响应超时,库又把它重发了一遍。没有
insert_id时,这个批次里的每个订单都会存两次。对一笔订单,收入变成 19.90 美元 × 2 = 39.80 美元而不是 19.90 美元;这个批次里 50 笔订单是 1,990 美元而不是 995 美元。带上insert_id: "order-1001"(任何不超过 36 个字符的键),服务器对每个键只保留一个事件,重试不改变任何东西。
教训不是服务器有风险,而是:只有给接收方一种认出同一事件的办法,重试才是安全的。SDK 处理排队、大小和重试,键仍然要你来提供。
60 秒内 1,000 单需要多少请求
示例数据应该怎样选?
按顺序用下面的规则。
- 这个事件涉及资金或会改变账户吗? 从你的服务器发,带上幂等键,如订单号。不要依赖浏览器。
- 是只有页面才知道的事情(点击、滚动、表单曝光、页面加载)吗? 用浏览器 SDK。
- 你的语言有服务端 SDK 吗? 用它,不要自己写 HTTP 调用;它已经处理了分批、重试和清理。
- 是脚本、后台任务或没有 SDK 的语言吗? 直接调用接口,并连同键一起写重试逻辑。
- 既要服务端事件,又要它对应的页面访问吗? 把这次访问的会话 ID 随服务端事件一起发送,让二者关联;没有它,服务端事件不会挂到某次访问上。
常见事件各适合哪条路径?
把规则用到一个典型产品会记录的八个事件上:
| 事件 | 路径 | 原因 |
|---|---|---|
| 页面浏览 | 浏览器 SDK | 只有页面知道它发生了,漏掉一条损失很小 |
| 按钮点击或滚动深度 | 浏览器 SDK | 交互数据在页面里 |
| 表单曝光 | 浏览器 SDK | 同样的原因;不要发送访客填写的内容 |
| 订单已付款 | 服务端,以订单号为键 | 涉及资金,必须扛得住拦截和重试 |
| 退款已发出 | 服务端,以退款号为键 | 发生在后台,不在访客的浏览器里 |
| 注册完成 | 服务端,有会话 ID 就带上 | 由你的数据库确认;并关联到引发它的那次访问 |
| 订阅续费 | 服务端或后台任务直接调用接口 | 根本没有访客在场 |
| 夜间导入历史记录 | 直接调用接口或导入工具 | 是批处理任务,不是实时访问 |
注意最后四项根本不涉及访客的浏览器。对它们来说,「SDK 还是 API」只取决于你的语言有没有服务端 SDK。
在 TapCub 里怎样发同一个事件并确认到达?
TapCub 三条路径都支持。上面的结账例子,一步一步来:
- 把网站脚本放到站点上(代码在网站统计 › 配置 › SDK 代码),用
tapcub.track记录页面行为。 - 对于购买,在配置 › 设置 › API 密钥里创建一个密钥,包含 Server track 权限。密钥以
wck_开头,只在创建时显示一次。 - 用
POST /api/v1/track发送事件,来自服务端 SDK 或上面的 curl 调用。先加上debug=1:它只校验事件、逐条返回结果,不存储任何东西。 - 读响应:
accepted是通过校验的事件数,rejected带有原因,例如缺少事件名。如果你的代码重试,要沿用同一个insert_id;重发不会新增一行,而且首条存储之后的一天内重复都会被识别,所以要尽快重试。 - 打开网站统计 › 事件或全端分析 › 数据管理 › 事件与属性看这笔购买。想让它关联到页面浏览,就传这次访问的会话 ID;没有会话 ID 的事件只留在事件表里,不计为一次新访问。直接调用 HTTP 接口没有内置重试,要自己写。
常见问题
SDK 比 API 更好吗?
两者没有一般意义上的好坏。SDK 是 API 外面的一层封装,增加了排队、重试和清理。语言有 SDK 就用 SDK;脚本或没有 SDK 的语言才直接调用 API,并自己加上重试和幂等键。
SDK 会用到 API 吗?
通常会。服务端 SDK 一般封装一个 HTTP 接口。SDK 负责组装请求、分批发送事件、失败时重试;API 是这些请求遵守的约定。
购买应该在浏览器还是服务器上记录?
在服务器上。浏览器可能被拦截、被篡改,或在请求发出前被关闭。带幂等键的服务端购买事件,既避免了被拦截造成的漏记,也避免了重试造成的重复。
为什么需要幂等键?
因为请求可能已经到达服务器而响应丢了,重试就会再发一遍。有了订单号这样的键,服务器对每个键只保留一个事件。没有键,收入可能被算两次。
一个项目里能同时用 SDK 和 API 吗?
可以。页面行为用浏览器 SDK,资金事件用服务器,并把会话 ID 随服务端事件一起发送,让二者在同一次访问里关联。
资料来源
- MDN Web Docs。Navigator: sendBeacon() method,64 KiB 上限,以及为什么用
visibilitychange取代unload。核对日期 2026-11-20。 - IETF。RFC 9110,第 9.2.2 节:幂等方法,定义,以及客户端何时不应重试。核对日期 2026-11-20。
- Google。Measurement Protocol reference,已公布请求限制的例子:25 个事件、130 kB 请求体。核对日期 2026-11-20。
- Google。Send Measurement Protocol events,主要为服务端或可信环境设计。核对日期 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
