移动应用监控工具分五类:崩溃报告、性能监控、商店与系统指标、使用分析和会话回放。每类看到应用的不同部分,没有哪一个工具能覆盖全部。按你需要回答的问题来选,并且要知道某个崩溃率统计的是用户还是会话。
读完你会知道
- 五类工具看到的东西不同;只靠崩溃报告,无法判断新版本是否流失了用户
- 同样的崩溃,无崩溃用户率是 98.5%,无崩溃会话率是 99.4%;一定要看分母
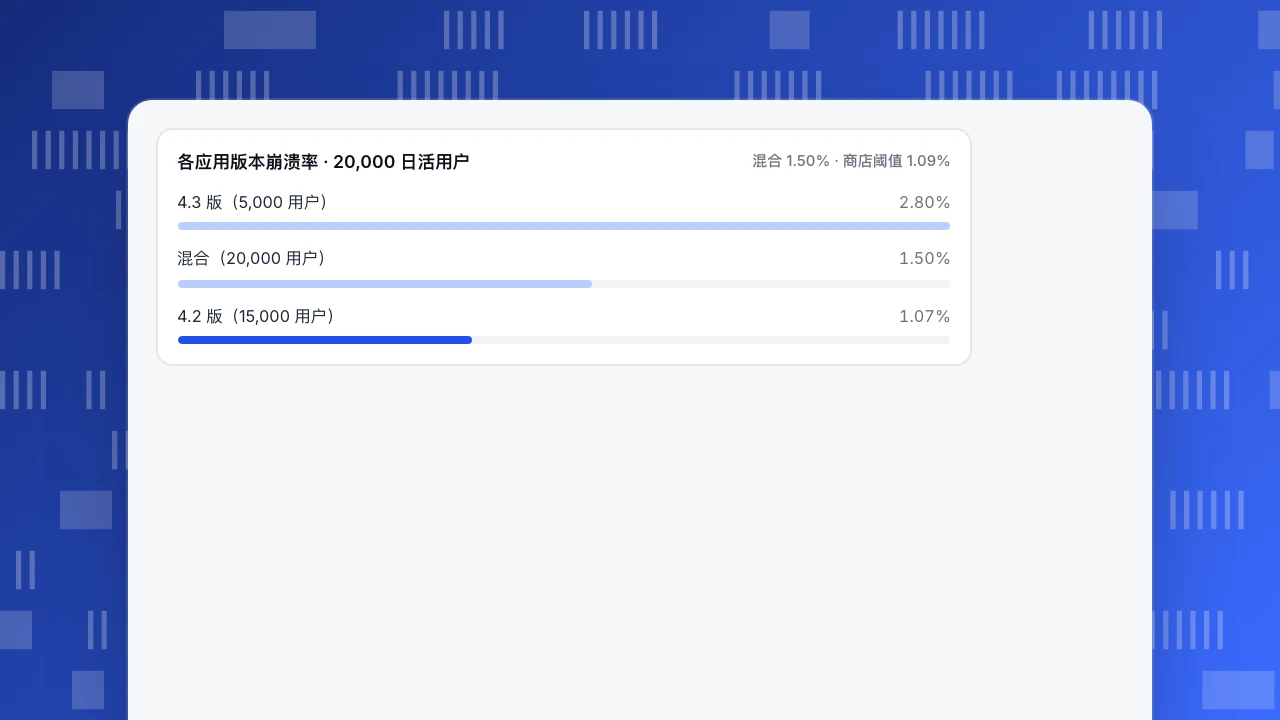
- 混合的 1.50% 崩溃率掩盖了 4.3 版本的 2.80%,比 4.2 版本差 2.6 倍
监控和分析回答的是不同的问题
应用监控回答「应用现在健康吗」:它在崩溃吗,慢吗,耗电或内存是不是太多。产品分析回答「用户在做什么,某个改动有没有用」:事件、漏斗、留存。两者都需要,因为一个健康的应用仍可能在糟糕的引导页流失用户,一个设计良好的应用也可能在某个机型上崩溃。
这些工具互相重叠,让选型很乱。一个有用的办法是问自己,下面五个问题里你今天回答不了哪个:
- 应用在崩溃吗,影响了谁?
- 它慢吗,慢在哪里?
- 平台怎么评价它?
- 用户在做什么,上一个版本有没有改变它?
- 某个用户的会话是什么样的?
五类工具各自看到什么
| 类别 | 衡量什么 | 看不到什么 | 典型指标 |
|---|---|---|---|
| 崩溃与错误报告 | 崩溃、ANR、已处理错误及堆栈 | 用户是否因为慢而离开 | 无崩溃用户率或会话率 |
| 性能监控 | 启动时间、慢帧、网络调用、内存 | 用户为什么行为不同 | 冷启动中位数、慢渲染占比 |
| 商店与系统指标 | 平台层面的崩溃、ANR、耗电、内存 | 业务事件和漏斗 | 用户感知崩溃率对比阈值 |
| 使用分析 | 谁做了什么:事件、漏斗、留存、版本 | 崩溃的根因 | 活跃用户、留存、各版本无崩溃用户率 |
| 会话回放 | 某一次会话长什么样 | 汇总比率 | 崩溃会话的回放 |
三点实用说明:
- 商店指标免费,并且一直在采集。 Play Console 里的 Android vitals,以及 Apple 平台的 Xcode Organizer 和 MetricKit,数据来自操作系统,所以能看到 SDK 看不到的事件,比如 SDK 启动之前的崩溃。
- 崩溃报告工具和分析工具即使都显示崩溃率,回答的也是不同的问题。 一个用来修 bug,另一个用来判断损害有多大。
- 回放解释一个案例,不衡量问题规模。 用比率决定什么重要,用回放去看它。
| 类别 | 衡量什么 | 看不到什么 | 典型指标 |
|---|---|---|---|
| 崩溃与错误报告 | 崩溃、ANR、已处理错误及堆栈 | 用户是否因为慢而离开 | 无崩溃用户率或会话率 |
| 性能监控 | 启动时间、慢帧、网络调用、内存 | 用户为什么行为不同 | 冷启动中位数、慢渲染占比 |
| 商店与系统指标 | 平台层面的崩溃、ANR、耗电、内存 | 业务事件和漏斗 | 用户感知崩溃率对比阈值 |
| 使用分析 | 谁做了什么:事件、漏斗、留存、版本 | 崩溃的根因 | 活跃用户、留存、各版本无崩溃用户率 |
| 会话回放 | 某一次会话长什么样 | 汇总比率 | 崩溃会话的回放 |
类别描述每类工具设计用来看的内容;很多产品覆盖其中两三类。这里不给任何工具排名。
无崩溃率:按用户还是按会话统计
无崩溃指标看起来一样,其实不同。Firebase Crashlytics 定义了两种:
- 无崩溃用户率 = 1 − 崩溃用户 ÷ 全部用户
- 无崩溃会话率 = 1 − 崩溃会话 ÷ 全部会话
示例数据:20,000 日活用户,当天 60,000 次会话(平均每人 3 次)。300 个用户至少崩溃过一次,崩溃会话共 360 次。
- 无崩溃用户率 = 1 − 300 ÷ 20,000 = 98.5%
- 无崩溃会话率 = 1 − 360 ÷ 60,000 = 99.4%
同样的崩溃,差了 0.9 个百分点。按用户算更严格,因为不走运的用户不管开了多少次会话,只算一次。Crashlytics 还指出,时间越长,用户崩溃的机会越多,所以一周的无崩溃用户率和一天的没法比较。
Android 文档展示了不同工具之间的同类差异。Android vitals 按每个日活用户统计问题,而 Crashlytics 按应用会话统计。如果一个用户一天玩了三次游戏、崩溃一次,Android vitals 会把这个用户整个算作崩溃用户,Crashlytics 则显示 33% 的会话崩溃。Android vitals 还包含 SDK 初始化之前发生的崩溃,并且只统计愿意共享数据的设备和从 Google Play 安装的应用,所以两者的数字不会完全一致。
各应用版本崩溃率 · 20,000 日活用户
混合 1.50% · 商店阈值 1.09%混合比率可能掩盖一个糟糕的版本
把上面的 300 个崩溃用户按版本拆开。示例数据:4.3 版正在灰度,有 5,000 日活用户;4.2 版有 15,000。
| 版本 | 日活用户 | 崩溃用户 | 崩溃率 | 无崩溃用户率 |
|---|---|---|---|---|
| 4.2 | 15,000 | 160 | 1.07% | 98.93% |
| 4.3 | 5,000 | 140 | 2.80% | 97.20% |
| 全部 | 20,000 | 300 | 1.50% | 98.50% |
混合值说 1.50%,看起来每个地方都只是个小问题。拆开后才看到 4.3 的崩溃频率是 4.2 的 2.6 倍(2.80 ÷ 1.07)。正确的做法是暂停 4.3 的灰度并去看它的错误分组,而不是把精力分散到整个应用。稳定性一定要按版本和机型来看。
平台阈值说明了什么
Android vitals 公布了 Google Play 可能降低应用可见度或显示警告的水平。在 28 天窗口内,整体不良行为阈值是:用户感知崩溃率 1.09%,用户感知 ANR 率 0.47%,每个手机型号两者都是 8%。Play 每天按 28 天平均值检查,并对影响设备超过 7 天的崩溃和 ANR 标记为新出现的问题,让你有 21 天处理。
在示例里,混合的 1.50% 高于 1.09% 这条线。这对整个应用是个警告,尽管 4.2 单独看(1.07%)刚好在线下。数字并不完全对应,因为 Android vitals 只统计用户感知的崩溃,但方向很明确:在 28 天平均值追上来之前先修 4.3。
不要把这个阈值照搬到 iOS。Apple 通过 Xcode Organizer 和 MetricKit 提供自己的崩溃和诊断数据,在那边用它们的数字。
怎么选你需要的
用这些规则:
- 只需要一个崩溃率? 先用商店后台和你的 SDK 已经报告的内容。它们免费。
- 需要堆栈和分组? 加一个崩溃报告工具来修 bug。
- 启动慢或界面卡? 加性能采样,关注冷启动中位数和卡顿。
- 说不清某个版本有没有损害留存? 加带版本维度的使用分析。
- 有个用户的投诉你复现不了? 对这一个案例用会话回放。
- 不要买五个工具。 选定你回答不了的那一个问题,再看每个候选说自己看不到什么。
前 30 天的监控起步计划
第一天你并不需要所有类别。按问题出现的顺序逐步添加。
| 时间 | 添加 | 告警条件 |
|---|---|---|
| 上线前 | 商店后台(已在采集)、崩溃报告、每个事件都带版本和机型 | 暂不设;确认崩溃数据能到达 |
| 上线首周 | 按版本的无崩溃用户率、冷启动中位数 | 日活 1,000 以上的版本,崩溃用户高于平台阈值的 75% |
| 第 2 到 4 周 | 按版本的留存、ANR 和卡顿数 | 崩溃用户连续两天上升 |
| 第一次更新后 | 每次发布都做版本对比 | 新版本比上一个版本更差 |
为什么是 75%?Android vitals 的整体崩溃阈值是 1.09%,它的 75% 大约是 0.82%。Play 按 28 天平均值判断,并标记新出现的问题,在 7 天的发现期之后给你 21 天来修复。对某个版本在 0.82% 时告警,让你有时间在 28 天平均值越过那条线之前暂停灰度。
为什么是日活 1,000?用户更少时,一个崩溃用户就会让比率变动超过 0.1 个百分点(1 ÷ 1,000 = 0.1%),所以单次崩溃就会触发告警。对规模较小的应用,改成按数量告警,比如某个版本一天有五个崩溃用户,而不是按比率。
三个习惯能让这个计划保持低成本:
- 每条告警一个负责人。 没有负责人的告警,一个月之内就会变成噪声。
- 始终给事件打上应用版本标签。 没有它,上面每张图都是混合值。
- 每次大版本发布后复查阈值, 因为新功能会改变正常的样子。
搭建应用监控时的错误
- 拿两个工具的数字相互比较。 商店后台按每个日活用户统计,SDK 工具按每次会话统计,所以总有一个看起来更好。选一个用于决策,并写明它的定义。
- 在不同窗口上读无崩溃率。 同一个应用,7 天的无崩溃用户率比 1 天的低,因为用户有更多崩溃的机会。
- 忽略版本。 事件没有带版本,一个糟糕的版本会在几周里被平均进全部用户。
- 对所有事情都告警。 五条有人负责的告警,胜过五十条没人看的。
- 以为 SDK 会自动捕获崩溃。 在相信一条平线之前,先在调试版本里故意触发一次崩溃,确认崩溃事件会到达。
- 把 ANR 和卡顿当成崩溃。 它们是不同的问题,修法也不同:是主线程被阻塞,而不是抛出了异常。
成本最低的改进,是在每个候选版本里做一次测试崩溃。如果它在几分钟之内没有出现在看板上,那监控就没有在工作,不管工具多好。
在 TapCub 里怎么看应用健康
用上面的版本例子。
- 打开 应用统计 › 质量与归因 › 稳定性。显示的无崩溃占比是 1 − 崩溃用户 ÷ 活跃用户,也就是按用户算,旁边是崩溃数、ANR、UI 卡顿、启动次数,以及冷启动、热启动和内存的中位数。在 Android 上,ANR 指主线程被阻塞至少 5 秒;在 iOS 和鸿蒙上,UI 卡顿指 2 秒。
- 查看 应用统计 › 用户分析 › 版本分布 里每个版本的崩溃数,就像 4.2 对 4.3 的那张表。在页头筛选里按版本过滤其他报表。
- 在错误分组里,按活跃、已解决或已忽略筛选,有人负责之后再改分组状态。
- 查看你所用平台的 SDK 页面:不是每个 SDK 都会自动上报崩溃,所以在相信一条平线之前,先确认
$app_crashed事件确实在到达。如果页面提示暂无数据,编辑者可以点击重新计算(近 7 天)。 - 用 应用统计 › 用户分析 › 留存 看新版本的用户是否和老版本的用户一样常回来。
稳定性页面显示崩溃、ANR、卡顿、启动时间和内存,不显示后端调用链或请求耗时,所以服务端追踪要另行保留。
FAQ
什么是移动应用监控工具?
它们是收集应用在真实设备上表现的工具:崩溃、错误、速度、内存,有时还有使用情况。不同类型覆盖不同问题,所以大多数团队把商店后台和一两种其他工具组合使用。
无崩溃率多少算好?
和平台阈值以及你自己的上一个版本比。Android vitals 的不良行为线是整体用户感知崩溃率 1.09%,约等于无崩溃 98.9%。比上个版本更差的比率,比一个泛泛的目标更重要。
无崩溃用户率和无崩溃会话率有什么区别?
无崩溃用户率除以用户数;无崩溃会话率除以会话数。同样的崩溃,用户率更低,示例里是 98.5% 对 99.4%。始终用同一个指标,并说明用的是哪个。
什么是 ANR?
ANR 是 Android 上的「应用无响应」:主线程被阻塞到足够久,系统认为应用已经卡住。在 TapCub 的稳定性页面里,它指被阻塞至少 5 秒。
监控和分析都需要吗?
通常需要。监控告诉你应用是否健康;分析告诉你用户是否留下、某个版本是否有帮助。用版本维度把两者连起来。
资料来源
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
