身份解析服务商把同一个人的标识符关联起来:用共有登录的精确匹配(确定性)、用 IP 和设备等信号打分(概率性),或用多来源网络(图谱)。按错误合并两个人的代价来选,再在自己已知的配对上量覆盖率和精确率。
读完你会知道
- 按“把两个不同的人合并”的代价选方法,再定阈值
- 用已知配对做留出测试量覆盖率和精确率;报出的匹配率不检查对错
- 示例中混合方法关联了 81.0% 的设备、有 49 个错误关联;确定性关联 38.0%,只有 2 个
身份解析服务商到底做什么?
身份解析服务商把同一个人分散的标识符,比如笔记本上的一个 Cookie、手机上的设备 ID、一个邮箱和一个客户 ID,判断哪些属于同一个人。你把标识符发给它,它返回一个人级别的 ID、一个匹配结果,或者一组关联起来的记录。身份解析页解释了这个概念;本文讲的是怎么在服务商所用的几种方法之间选择,因为方法决定了你能放心拿结果做什么。
服务商之间有三点差别,比功能清单更重要:
- 怎么判定两个标识符匹配。 从共用的精确登录,到统计意义上的猜测。
- 拿什么数据去匹配。 只用你发过去的数据,还是它手里一个很大的参照库。
- 允许错到什么程度。 每种方法都会出错,问题是出什么样的错、错多少。
核心主张很简单:按你要用匹配结果做的决定来选服务商,然后在自己已知的配对上量它的覆盖率和误合并。 一个很适合统计受众的方法,拿来给人展示他的账户页可能就很危险。
确定性、概率性和图谱:三种方法有什么不同?
| 方法 | 怎么关联标识符 | 优点 | 缺点 |
|---|---|---|---|
| 确定性 | 两条记录共有的标识符精确匹配,比如登录 ID 或哈希邮箱 | 误合并很少,容易解释和审计 | 只能关联给过你该标识符的人,覆盖率有限 |
| 概率性 | 用 IP、设备类型、时间、位置等信号给“是同一个人”的可能性打分,高于阈值就关联 | 覆盖更广,包括从没登录过的人 | 误合并是内置的;阈值在覆盖率和错误之间取舍 |
| 图谱(身份图谱) | 把多个来源的标识符建成网络,通过共享节点关联,常常混合确定性和概率性的边 | 能跨很多设备和来源 | 难审计;质量取决于背后的数据来源 |
有两点说清楚,能省下以后的争论。首先,很多服务商是混合的:以确定性关联为锚,其余用概率性补上。要问清哪些边是哪种,输出里怎么标注。其次,“确定性”这个词常被用得很松。哈希邮箱的精确匹配是确定性的;IP 地址的精确匹配不是,因为很多人共用一个 IP。身份图谱页讲了第三种方法背后的数据结构。
| 方法 | 示例覆盖率 | 示例错误关联 | 适合 |
|---|---|---|---|
| 确定性(登录 ID) | 38.0% | 2 | 账户数据、价格、消息 |
| 概率性 | 72.0% | 65 | 触达和受众计数 |
| 混合图谱 | 81.0% | 49 | 计数和跨设备归因,并单独报告猜测的部分 |
示例数据:1,000 台设备属于 500 个人;精确率分别为 99.5%、91.0%、94.0%。
怎么衡量匹配质量?
任何解析方法都用两个数字描述,两个都要看:
- 覆盖率: 最终与至少一个其他设备关联起来的设备占比。
- 精确率: 做出的关联里,把同一个人的设备连在一起的占比。
测量办法是用你已经确定属于同一个人的配对做留出测试:比如在你自己的产品里登录过同一个账号的设备。把这些关联藏起来,跑一遍方法,数它找回多少(覆盖率)、又多连了多少错的(精确率)。服务商给的“匹配率”衡量的是另一件事,通常是你的记录有多少在它的参照库里找到了任何匹配,不检查匹配对不对。
示例数据:1,000 台设备属于 500 个人,每人两台,所以真实答案是已知的。
| 方法 | 关联的设备数 | 覆盖率 | 精确率 | 正确关联 | 错误关联 | 每个错误对应的正确数 |
|---|---|---|---|---|---|---|
| 确定性(登录 ID) | 380 | 38.0% | 99.5% | 378 | 2 | 189 |
| 概率性 | 720 | 72.0% | 91.0% | 655 | 65 | 10 |
| 混合图谱 | 810 | 81.0% | 94.0% | 761 | 49 | 16 |
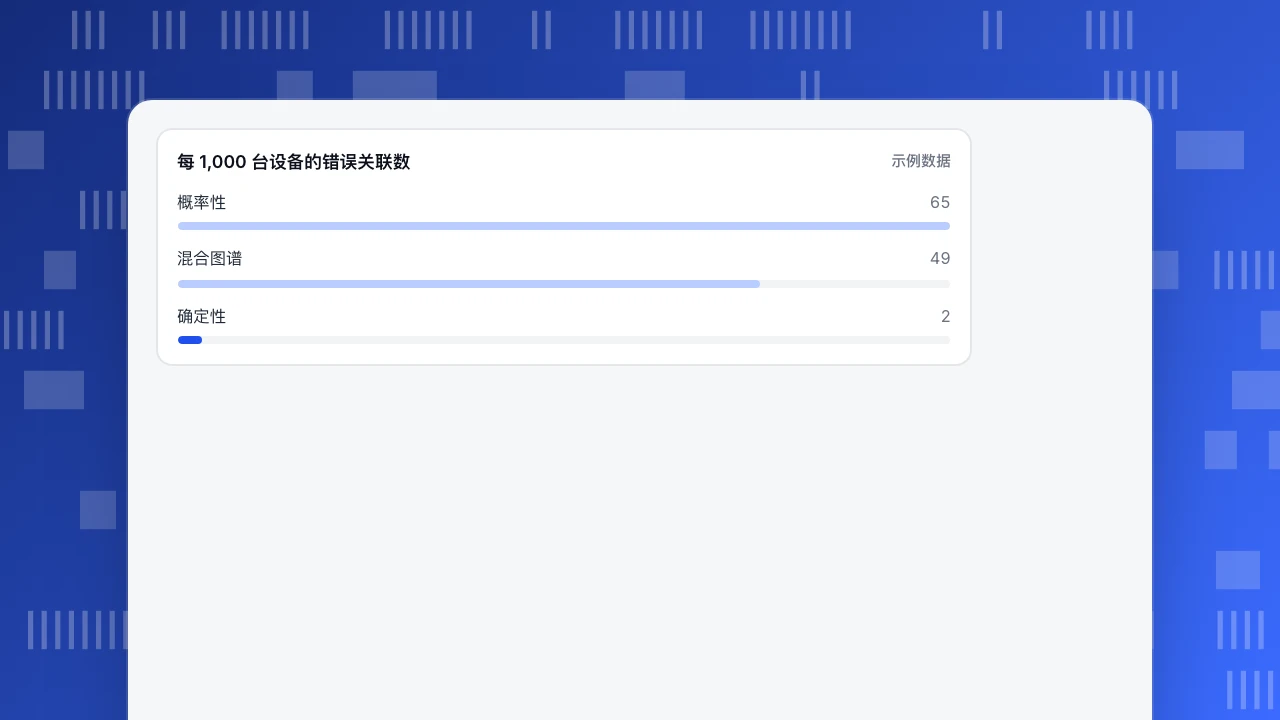
算法是:正确关联 = 关联数 × 精确率,错误关联 = 关联数 × (1 − 精确率),取整到设备。混合方法的正确关联是确定性方法的两倍(761 对 378),但也多出 49 个错误,确定性方法只有 2 个。这笔交易划不划算,完全取决于一次错误关联的代价,下一节讲这个。
每 1,000 台设备的错误关联数
示例数据哪种方法适合哪种决定?
先写下两个不同的人被合并成一个人会发生什么,再按这个代价选方法。
- 向某人展示账户数据、价格或消息:只用确定性。 错误合并会让一个人看到另一个人的信息。1,000 台设备里有 65 个错误关联,概率性方法在这里不可接受;只有 2 个的确定性方法接近可以接受。
- 统计去重人数和触达:混合或概率性即可。 “谁是同一个人”有 5% 到 9% 的误差,只会让计数轻微变动,而额外的覆盖率能减少多设备用户的重复计数。用你的注册数据做个常识检验:人数远低于不同登录 ID 的个数就值得查,因为很少有人持有多个账号。
- 跨设备的转化归因:混合,并把概率性的部分单独报告。 如果你记功的跨设备转化里有 40% 依赖猜出来的关联,就要写明,免得有人把这个数字当成精确值。
- 屏蔽,比如遵守退订:宁可多合并。 这里错误合并只是多屏蔽了一个人,漏合并却会继续打扰要求停止的人。这是错合并比漏合并便宜的少数情况之一。
每次的顺序都一样:先看错误合并的代价,再选方法,最后定阈值。
购买前应该问服务商什么?
把这些问题当作选型标准;每一条都有可以核对的答案。
- 到底什么算确定性匹配? 问清标识符类型。邮箱和登录 ID 可以;IP 地址不行。
- 我能在自己已知的配对上跑留出测试吗? 不能的话,你就没法验证精确率。坚持量覆盖率和错误关联,不要只听报出来的匹配率。
- 参照数据从哪来,同意依据是什么? 按 GDPR,个人数据是与已识别或可识别的自然人有关的任何信息,经过假名化的数据只要能借助额外信息归属到某个人,仍是个人数据。哈希邮箱是假名化而不是匿名,所以你的合法性依据和告知义务依然适用。
- 我能拿回什么? 一个能存下来的人 ID、一份关联记录列表,还是只有在它平台内的受众匹配?前两种可以带走;最后一种把价值锁在对方那里。
- 计价单位和退出方式是什么? 按匹配的记录数、按查询次数还是按月;离开时能不能导出这些关联。
- 错误怎么报告? 看有没有每条关联的置信度,这样上面那些敏感决定可以设更严的阈值。
- 答案多快? 页面个性化要实时查询,还是接受滞后一天的批量更新。
浏览器的变化为什么影响选择?
概率性和图谱方法依赖的标识符,浏览器正越来越多地限制。Safari 的智能防跟踪(ITP)会在用户 7 天没有访问站点后删除脚本写入的存储,把链接里带点击 ID 的落地页所设的 Cookie 有效期限制在 24 小时,并且默认拦截第三方 Cookie,没有例外。所以依赖长期第三方标识符的方法,每周都会把更多设备当成新设备,覆盖率会随时间下降。
由登录建立的关联不会这样老化。有人在新设备上登录,你直接从第一方数据里知道了这个关联。所以无论后面再接哪家服务商,先用自己的登录建立确定性基础都值得:它既是准确度高的一层,也是浏览器政策不会侵蚀的一层。
在 TapCub 里怎么用你自己的登录数据?
TapCub 不是身份解析服务商。它没有第三方身份图谱,也不会拿你的访客去匹配外部数据。它做的是用你自己的登录建立确定性这一层,而这一层同时也是上面留出测试需要的真实基准。
- 打开识别模式并上报登录。 识别模式从 Pro 套餐起提供。你自己的登录成功后调用
tapcub.login(id, props);ID 可以是你的登录 ID、邮箱(转小写后哈希)、手机号、OpenID 或 UnionID。guest、anonymous这类占位 ID 会被拒绝,免得一群人被并成一个人。 - 让第一次登录回填历史。 设备上的第一次登录,会把该设备之前的匿名历史并到这个人名下,所以从首次访问到注册的漏斗是完整的。之后用另一个账号在同一设备登录,不会移动已经属于别人的记录。
- 看人,不看设备。 在 全端分析 › 用户 › 用户 打开一个人,可以看到他跨设备的行为随时间的变化。分析可以按访客、设备或人计数;切换到按人,就消除了重复计数。
- 把这些配对当作留出测试集。 一个登录绑定了两台及以上设备的人,就是你的已知配对。在拿任何外部方法去测之前,先记下其中一批样本。
- 知道边界。 每个人默认最多 50 台设备;超出的设备仍会被统计,但不会并到这个人名下。从不登录的匿名访客保持独立,TapCub 不会去猜他们是不是同一个人。
FAQ
什么是身份解析服务商?
把同一个人的标识符,比如 Cookie、设备 ID、邮箱和客户 ID,关联成一条人级别记录的公司或平台。服务商的差别主要在匹配方式(确定性、概率性或图谱)、拿什么数据去匹配,以及怎么报告错误。
确定性和概率性身份解析有什么区别?
确定性匹配关联共有精确标识符(如登录 ID)的记录,所以误合并很少,但只覆盖主动表明身份的人。概率性匹配用 IP、设备等信号给可能性打分,覆盖更多人,代价是内置的错误。
怎么测试身份解析服务商?
做留出测试。从你自己的登录里取已知属于同一个人的设备配对,把关联藏起来,跑服务商,数找回的关联和多出来的错误关联。比较覆盖率和精确率,而不是报出来的匹配率。
我一定需要身份解析服务商吗?
不一定。如果有价值的用户大多会登录,用自己的登录建立的确定性层可能就够做账户分析了。当你必须触达从不登录的人、或要整合很多来源的数据,并且接受误差的取舍时,服务商才有帮助。
资料来源
- WebKit,Tracking Prevention——脚本可写存储 7 天上限、带链接装饰时 24 小时上限和默认拦截第三方 Cookie。核对于 2026-11-21。
- GDPR,第 4 条:定义——个人数据(4(1))和假名化(4(5))。核对于 2026-11-21。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
