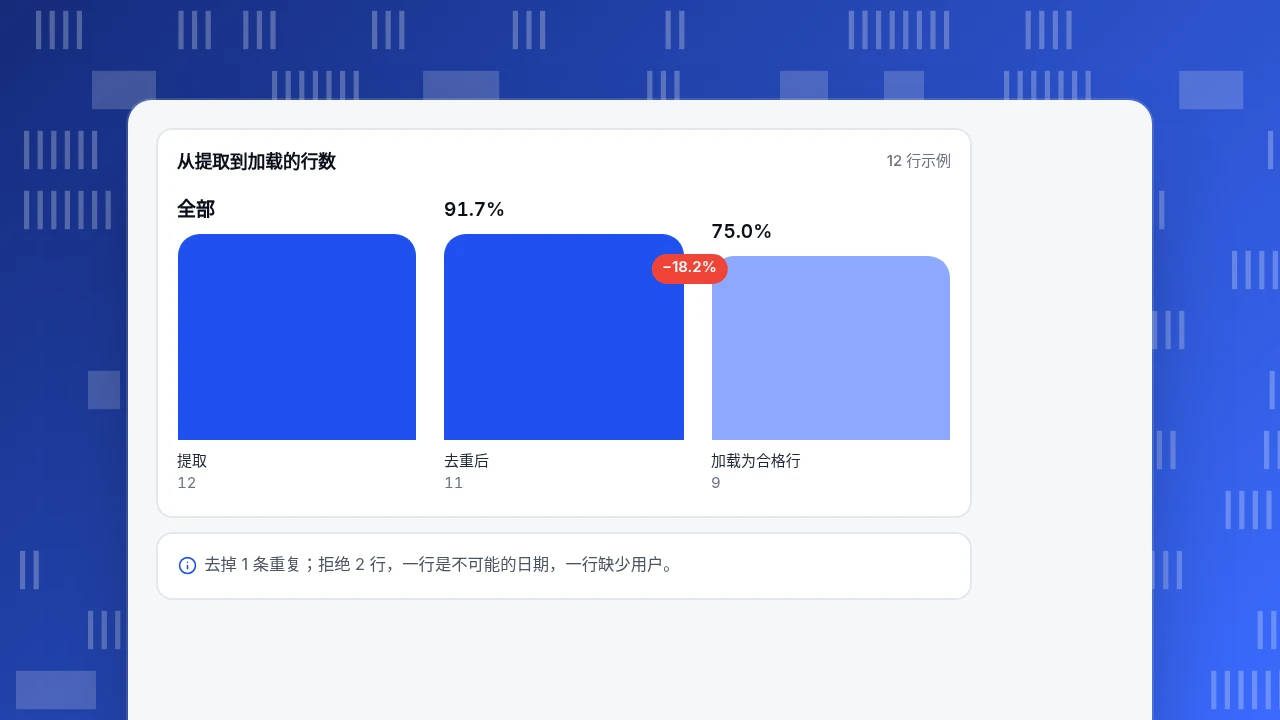
用 SQL 做 ETL,就是用 SELECT 提取行,用表达式、连接和窗口函数转换,再用 INSERT ... SELECT 加载,并用 upsert 让重跑也安全。下面是一个可以在 SQLite 里直接运行的完整例子:一张 12 行的事件表,被清洗、去重、加载进三张表,并核对到每一行、每一分钱。
读完你会知道
- 把所有清洗规则放进一个视图,加载之前先检查结果
- 用主键和 ON CONFLICT 让加载幂等,并通过运行两遍来证明
- 核对行数和金额:提取 12 = 重复 1 + 拒绝 2 + 加载 9,购买金额 466.00 − 被拒绝的 45.00 = 421.00
用 SQL 做 ETL 是什么意思
ETL 是提取(extract)、转换(transform)、加载(load)。亚马逊的描述最直白:从源数据库取出相关记录,整理成更适合分析的形态,再把处理好的数据写进目标数据库。SQL 对这三步都适用:提取是一条 SELECT(或一次导出),转换是 SELECT 里的表达式、连接和窗口函数,加载是 INSERT ... SELECT 写入目标表。
只用 SQL 做 ETL,适合源表和目标表能在同一个数据库会话里访问、数据量在几千到几百万行的场景。需要定时调度、多个数据源或多种文件格式、失败告警时它就不够了,最后一节给出判断规则。
如果先加载再转换,顺序就叫 ELT。ETL 与 ELT 的区别做了比较,ETL 术语页有简短定义。本文是 SQL 本身的一个完整、可运行的例子。下面的内容在 SQLite 命令行、DB Browser for SQLite 或 Python 的 sqlite3 模块里原样可跑(需要 SQLite 3.25 或更新版本,因为用到了窗口函数和 upsert)。文中展示的计数是在 SQLite 3.51.0 上运行得到的实际输出。
源表和它的问题
示例数据:从一家商店的事件日志导出的 12 行,带有真实导出常见的各种问题。
-- 原始导出表:全部是文本,没有任何约束,和真实导出一样
CREATE TABLE raw_events (
  event_id TEXT,        -- 事件编号,本应不重复,但导出里有重复
  occurred_at TEXT,     -- 发生时间,格式不统一
  user_email TEXT,      -- 用户邮箱,大小写和空格混乱,可能为空
  event_name TEXT,      -- 事件名,大小写混乱
  amount_cents INTEGER, -- 金额,单位是分
  page TEXT             -- 页面路径
);
-- 12 行示例数据:E003 出现两次,E007 的月份是 13,E008 没有用户
INSERT INTO raw_events VALUES
 ('E001','2026-11-01 09:15:00','Ann@Example.com ','Purchase', 4500,'/checkout/done'),   -- 邮箱有大写和末尾空格
 ('E002','2026-11-01T10:02:30','bob@example.com','purchase',12900,'/checkout/done'),   -- 时间用 T 分隔,和其他行不一致
 ('E003','2026-11-01 11:40:00','ann@example.com','page_view',NULL,'/pricing'),   -- E003 的原始行
 ('E003','2026-11-01 11:40:00','ann@example.com','page_view',NULL,'/pricing'),   -- E003 的重复副本
 ('E004','2026-11-01 23:59:59','cy@example.com','PURCHASE ', 2500,'/checkout/done'),   -- 事件名全大写,末尾有空格
 ('E005','2026-11-02 08:00:00','bob@example.com','page_view',NULL,'/blog'),
 ('E006','2026-11-02 08:05:00','dee@example.com','purchase', 7800,'/checkout/done'),
 -- E007 的月份是 13,整行时间无效
 ('E007','2026-13-02 09:00:00','eve@example.com','purchase', 3000,'/checkout/done'),
 -- E008 没有用户邮箱
 ('E008','2026-11-02 14:30:00',NULL,'purchase', 1500,'/checkout/done'),
 ('E009','2026-11-03 10:00:00','ann@example.com','purchase', 4500,'/checkout/done'),
 ('E010','2026-11-03 12:12:00','bob@example.com','page_view',NULL,'/pricing'),
('E011','2026-11-03 18:45:00','cy@example.com','purchase', 9900,'/checkout/done');| 问题 | 涉及的行 | 处理规则 |
|---|---|---|
同一个 event_id 出现两次 | E003(2 份) | 每个 event_id 只留一行 |
时间分隔符不统一(空格和 T) | E002 | 统一成 YYYY-MM-DD HH:MM:SS |
| 不可能的日期(13 月) | E007 | 带原因拒绝,不加载 |
| 缺少用户 | E008 | 带原因拒绝,不加载 |
| 大小写混用、末尾空格 | E001、E004 | lower(trim(...)) |
| 金额是整数分 | 全部购买行 | 除以 100 |
目标是三张表:events_clean 放合格的行,events_rejected 放没通过规则的行,daily_summary 每天一行。
-- 目标表 1:合格事件,event_id 做主键,防止重复加载
CREATE TABLE events_clean (
  event_id TEXT PRIMARY KEY,   -- 事件编号,主键,不允许重复
  occurred_at TEXT NOT NULL,   -- 统一格式后的时间,不允许为空
  user_id TEXT NOT NULL,       -- 清洗后的用户标识,不允许为空
  event_name TEXT NOT NULL,    -- 小写、去空格后的事件名
  amount REAL,                 -- 金额,单位元
  page TEXT);                  -- 页面路径
-- 目标表 2:被拒绝的行,加上拒绝原因,方便以后追查
CREATE TABLE events_rejected (event_id TEXT, reason TEXT);
-- 目标表 3:每天一行的汇总,day 做主键,方便 upsert
CREATE TABLE daily_summary (
  day TEXT PRIMARY KEY,   -- 日期,主键,每天只有一行
  events INTEGER,         -- 当天事件总数
  buyers INTEGER,         -- 当天购买的去重用户数
  revenue REAL);          -- 当天购买金额合计
提取:只取需要的
真实流程里,提取是对另一个系统的查询或一次文件导出。两个习惯可以让它保持轻量。只选目标表需要的列;并且增量提取:记下一个水位线,也就是已加载数据中最大的时间戳,下次只取更新的行。
-- 增量提取:只取比水位线更新的行,:last_loaded_at 是上次加载到的时间
SELECT event_id, occurred_at, user_email, event_name, amount_cents, page
FROM raw_events
WHERE occurred_at > :last_loaded_at;
第一次运行时水位线是空字符串,全部数据都会取出。有两点要小心。比较的列要用源系统可靠写入的列,比如插入时间,并且每次多回看几分钟来捕捉迟到的行:这样做只有在后面的加载步骤幂等时才安全。另外不要对自己不控制的表用 SELECT *,源端新增一列会悄悄改变目标表。
本例的原始行已经在 raw_events 里,所以提取就是视图里的 FROM 子句,水位线留作你自己流程里的注释。
转换:在一个视图里清洗、去重、标准化
把所有规则放进一个视图,这样加载之前就能先检查结果。
-- 暂存视图:所有清洗规则都放在这里,加载前可以先查看结果
CREATE VIEW v_stage AS
WITH norm AS (
  SELECT event_id,
         datetime(replace(occurred_at,'T',' '))          AS occurred_at,   -- 统一时间格式,非法日期变成 NULL
         lower(trim(user_email))                         AS user_id,       -- 去空格、转小写
         lower(trim(event_name))                         AS event_name,    -- 事件名也要统一
         amount_cents / 100.0                            AS amount,        -- 分换成元,用 100.0 避免整数除法
         page,
         row_number() OVER (PARTITION BY event_id ORDER BY rowid) AS rn   -- 同一事件编号的副本依次编号
  FROM raw_events)
SELECT * FROM norm WHERE rn = 1;   -- 每个事件编号只留编号为 1 的那份
replace(occurred_at,'T',' ')把2026-11-01T10:02:30变成空格分隔的形式。SQLite 的datetime()两种写法都接受,按其文档,无法解析的输入返回NULL。这让 E007 可以被检测出来:datetime('2026-13-02 09:00:00')是NULL,你可以判断它,而不是让加载崩溃。lower(trim(...))让Ann@Example.com和ann@example.com成为同一个用户。不做这一步,一个买家在所有计数里会变成两个人。row_number() OVER (PARTITION BY event_id ORDER BY rowid)给每个事件的各份副本编号,只留rn = 1就去掉了重复的 E003。窗口函数从 SQLite 3.25.0(2018-09-15)开始支持。- 除以
100.0而不是100,避免整数除法。
加载前先查视图确认:SELECT count(*) FROM v_stage 返回 11(12 行原始数据减去 1 条重复),两条坏行的时间戳或用户列显示 NULL。
加载:拒绝行、合格行和可重复运行的汇总
三条语句,按这个顺序。
-- 1. 拒绝行:先写入拒绝表,带上以后能读懂的原因
INSERT INTO events_rejected
SELECT event_id,
       CASE WHEN occurred_at IS NULL THEN 'bad timestamp' ELSE 'missing user' END
FROM v_stage
WHERE occurred_at IS NULL OR user_id IS NULL;   -- 时间无效或没有用户的行

-- 2. 合格的行:时间和用户都有效才加载,重复的主键直接跳过
INSERT INTO events_clean
SELECT event_id, occurred_at, user_id, event_name, amount, page
FROM v_stage
WHERE occurred_at IS NOT NULL AND user_id IS NOT NULL   -- 两个必填字段都有效
ON CONFLICT(event_id) DO NOTHING;                        -- 已加载过的事件编号不再重复写入

-- 3. 每日汇总:按天聚合,已有的那一天用新数字覆盖,所以可以放心再跑一次
INSERT INTO daily_summary (day, events, buyers, revenue)
SELECT date(occurred_at), count(*),                         -- 按天取日期、事件数
       count(DISTINCT CASE WHEN event_name='purchase' THEN user_id END),   -- 买家数,按用户去重
       coalesce(sum(CASE WHEN event_name='purchase' THEN amount END),0)   -- 收入,没有购买时记 0
FROM events_clean
WHERE true                    -- 避免 ON 被解析成连接条件
GROUP BY date(occurred_at)
ON CONFLICT(day) DO UPDATE SET   -- 当天已有记录时,用新算的数字覆盖
  events=excluded.events, buyers=excluded.buyers, revenue=excluded.revenue;
有两个细节。主键上的 ON CONFLICT ... DO NOTHING 保证重跑不会把同一个 event_id 插入两次。第 3 步里带 excluded. 前缀的 DO UPDATE 会用新算出的值覆盖当天那一行,所以运行两次也只有每天一行、数字相同。upsert 语法从 SQLite 3.24.0(2018-06-04)开始支持;PostgreSQL 文档里有同样的 ON CONFLICT 写法。当 upsert 的值来自一条 SELECT 时,SQLite 文档说这条 SELECT 应该始终带一个 WHERE 子句,哪怕只是 WHERE true,免得解析器把 ON 当成连接条件,这就是第 3 步里有 WHERE true 的原因。
实际运行的结果:
| 日期 | 事件数 | 买家数 | 收入 |
|---|---|---|---|
| 2026-11-01 | 4 | 3 | 199.00 |
| 2026-11-02 | 2 | 1 | 78.00 |
| 2026-11-03 | 3 | 2 | 144.00 |
从提取到加载的行数
12 行示例提取
12
去重后
11
加载为合格行
9
核对计数,并证明它能重复运行
说不清每一行去了哪里的流程,不算做完。核对两个等式。
行数: 提取 12 = 去掉重复 1 + 拒绝 2 + 加载 9。查询如下:
-- 行数核对:提取数 = 重复数 + 拒绝数 + 加载数
SELECT (SELECT count(*) FROM raw_events) AS extracted,
       (SELECT count(*) FROM raw_events) - (SELECT count(*) FROM v_stage) AS dup,   -- 被去掉的重复行
       (SELECT count(*) FROM events_rejected) AS rej,                               -- 被拒绝的行
       (SELECT count(*) FROM events_clean) AS loaded;                               -- 已加载的合格行
返回 12、1、2、9,而 1 + 2 + 9 = 12。
金额: 原始表里的购买金额除以 100 后合计 466.00(45 + 129 + 25 + 78 + 30 + 15 + 45 + 99)。被拒绝的购买是 E007(30.00)和 E008(15.00),共 45.00。所以合格购买应当合计 466.00 − 45.00 = 421.00,SELECT sum(amount) FROM events_clean WHERE event_name='purchase' 返回的正好是 421.0。
重跑测试: 先清空 events_rejected,再把三条加载语句运行第二遍。events_clean 仍是 9 行,daily_summary 仍是同样的 3 行,拒绝行是 2 条,因为拒绝表事先清空了。如果重跑改变了任何计数,说明加载不幂等,一次失败的运行就可能弄坏目标表。
| 核对项 | 预期 | 结果 |
|---|---|---|
| 行数:提取 = 重复 + 拒绝 + 加载 | 12 = 1 + 2 + 9 | 12、1、2、9 |
| 拒绝后的购买金额合计 | 466.00 − 45.00 = 421.00 | 421.0 |
| 重跑:events_clean 的行数 | 9 | 9 |
| 重跑:daily_summary 的行数 | 3 | 3 |
| 重跑:无法解释的差异 | 0 | 0 |
示例数据。每项核对都在真实运行中通过;如果重跑改变了任何计数,说明加载不是幂等的。
SQL 单独不够用的时候
SQL 是大多数数据流程里的转换语言,但它周围的粘合部分不是 SQL。对照信号和对策:
| 信号 | 说明什么 | 要补什么 |
|---|---|---|
| 任务必须每晚 02:00 运行 | 需要调度器 | cron、工作流工具或数据库自带的任务功能 |
| 源和目标是不同的系统 | 单个会话读不到两边 | 用导出文件或连接器做提取和加载 |
| 原始表有几亿行 | 每次全表重扫太慢 | 基于水位线的增量加载、分区、数据仓库 |
| 规则经常变 | 手改视图定义会漂移 | 把 SQL 放进版本控制并评审改动 |
| 出错要有人知道 | 没有东西在盯着任务 | 像上面那样的行数核对,再接上告警 |
如果先把原始数据加载进数据仓库,再在仓库里转换,就是 ELT,见 ETL 与 ELT 的区别。本文的 SQL 可以原样搬到那种做法里,只是步骤顺序不同。
怎样把结果送进 TapCub
拿上面的 events_clean,把它作为事件导入 TapCub。
- 导出可直接加载的形态。 选出 TapCub 的 CSV 向导能映射的列,时间用 ISO 文本:
SELECT occurred_at AS time, event_name AS event, user_id, page FROM events_clean。user_id用内部用户 ID,不要用邮箱;演示里用邮箱只是为了展示转小写。避免写入个人数据说明了哪些内容不该放进去。 - 一次性导入文件。 在 全端分析 › 数据管理 › 数据导入 点 导入文件。向导会识别类型、显示前 20 行,并按
time、event_name、user_id这类列名猜测映射。一个文件最多 100,000 行,更大的导出要拆分。导入的事件平台为import,可以按它筛选。 - 持续加载用服务端事件接口。 数据导入页面用于迁移,不是持续采集渠道;定时任务请从你的流程里通过服务端事件接口发送,见发送服务端事件。
- 再查回来。 全端分析 › 行为分析 › 行为分析 里的 SQL 标签页接受一条
SELECT或WITH,只能查项目的v_events、v_sessions、v_persons和v_autocapture视图,最多返回 50,000 行,30 秒超时。写操作会被拒绝,所以 TapCub 的 SQL 用来读取你加载的内容,不能做加载本身。见用 SQL 查询数据。
TapCub 不是 ETL 工具:它不调度也不运行你的转换。它接收清洗好的事件,让你用和脚本采集的事件同样的报表去分析。
常见问题
SQL 里的 ETL 是什么?
就是用 SQL 语句完成的提取、转换和加载。提取是一条 SELECT 或一次导出,转换是 SELECT 里的清洗和整理,加载是 INSERT ... SELECT 写入目标表。它适合数据量不大、源和目标在同一个数据库会话里能访问的场景,重复运行需要调度器。
只用 SQL 能做 ETL 吗?
一次性或中等规模的任务可以:上面的例子只用 SQL 就完成了提取、清洗、去重、加载和核对。但定时运行、在不同系统间搬数据、核对失败时告警,还是要 SQL 之外的东西。这些部分和转换本身相比很小。
怎样让 SQL 加载可以安全地重复运行?
给目标表加主键并使用 upsert:永不变化的事实数据用 ON CONFLICT ... DO NOTHING,汇总表用 DO UPDATE SET col = excluded.col。这样重跑得到相同的行。测试方法是把加载运行两遍,比较行数,就像核对一节里那样。
SQL 里的 ETL 和 ELT 有什么区别?
ETL 先转换再加载;ELT 先加载原始数据,再用 SQL 在目标内转换。SQL 本身是一样的。ELT 保留了原始表,所以改了规则可以重建,目标是计算资源充足的数据仓库时更方便。
ETL 最常用到哪些 SQL 功能?
清洗函数如 trim、lower 和日期解析;表达规则的 CASE;做汇总的 GROUP BY;去重用的 row_number() 这类窗口函数;以及安全重载用的 upsert。这些覆盖了大部分转换,剩下的工作是核对计数。
资料来源
- Amazon Web Services,What is ETL?:提取、转换、加载的定义,以及 ELT 如何调换顺序。核对于 2026-11-20。
- SQLite,UPSERT:
ON CONFLICT语法、excluded.限定符、3.24.0 版本,以及INSERT ... SELECT的WHERE子句说明。核对于 2026-11-20。 - SQLite,日期和时间函数:接受的时间格式,以及无法解析的输入返回
NULL。核对于 2026-11-20。 - PostgreSQL,INSERT:
ON CONFLICT DO NOTHING和DO UPDATE子句。核对于 2026-11-20。 - SQLite,窗口函数:3.25.0(2018-09-15)加入,包含
row_number()。核对于 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
