因果关系的一个例子是随机测试:把新的结算按钮随机展示给一半访客,这一半的销量更高。随机分配让两组除了改动之外都相似,所以差异可以归因于改动。本文给出证据阶梯、三个实验与观察结论不一致的已发表案例,以及一个算例:21.9 个点的留存差距,实际只有 2 个点。
读完你会知道
- 只有随机测试(或接近它的设计)才有资格用「导致」这个词;调整后的和原始的比较只能用更弱的措辞
- 示例里功能用户留存高 21.9 个点,但在可比分组内效果只有 2 个点,被高估了 10.9 倍
- 写「导致」之前,先检查先后、第三个因素、谁选的暴露、偶然和机制
什么算因果关系,什么证据能说明它?
因果关系是指:在其他条件都保持不变的情况下,改变 X 会改变 Y。网店的结算按钮变成绿色,同一周销量上升,这只是相关。把绿色按钮随机展示给一半访客,发现这一半的销量更高,才是因果证据,因为随机分组让两半人除了按钮之外在其他方面都相似。
本文讲的是证据,不是词汇。两个概念的区别和一批容易混淆的例子,请看相关与因果的例子和因果关系词条。这里我们用几个真实案例、一个你可以复算的产品分析例子,以及一个区分因果与巧合的简短检查。
证据阶梯
| 证据 | 能排除什么 | 产品团队里的例子 |
|---|---|---|
| 随机实验 | 混杂因素、选择偏差、反向因果(分配是随机的,而且在先) | 把新的新手引导随机展示给 50% 的新注册用户 |
| 留出组或自然实验 | 多数混杂因素,前提是分配近似随机 | 功能先在一个国家上线;或用抛硬币选的地区 |
| 做了调整的观察数据 | 只能排除你测量过的混杂因素 | 在相同活跃程度内比较功能用户和非用户 |
| 原始相关 | 什么都排除不了 | 「用功能 X 的用户留存更好」 |
往表格下方走,你有资格提出的结论就越弱。本文的所有例子,讲的都是有人用了下面的台阶,却说得好像站在最上面。
| 证据 | 能排除什么 | 例子 |
|---|---|---|
| 随机实验 | 混杂因素、选择偏差、反向因果 | 把新的新手引导随机展示给 50% |
| 留出组或自然实验 | 多数混杂因素(前提是分配近似随机) | 功能先在一个国家上线 |
| 做了调整的观察数据 | 只能排除你测量过的混杂因素 | 在相同活跃程度内比较用户与非用户 |
| 原始相关 | 什么都排除不了 | 用功能 X 的用户留存更好 |
沿表格往下,你可以提出的结论越来越弱。
例 1:激素治疗,随机试验与多年观察
妇女健康倡议(Women's Health Initiative)把 16,608 名健康的绝经后妇女随机分到雌激素加孕激素组或安慰剂组。试验在平均 5.2 年后提前终止,因为治疗增加了冠心病、中风、肺栓塞和浸润性乳腺癌的风险。作者的结论是总体风险大于获益,不应为预防心脏病而开始这种治疗(Rossouw 等,JAMA 2002)。做这个试验,是因为只靠观察性证据,风险和获益的平衡一直说不清。
它之所以是因果例子,在于设计:妇女是靠机会分组的,所以两组在健康习惯、收入和就医条件上没有差别。这正是原始比较所缺少的。
例 2:Bing 上一个广告标题的改动
Bing 里有一个小改动,涉及广告标题的显示方式,它一直躺在待办清单里,直到一位工程师做了一次快速的在线对照实验。结果发现收入提升 12%,仅在美国一年就超过 1 亿美元,而且没有损害关键的用户体验指标(Kohavi 和 Thomke,《哈佛商业评论》)。Kohavi 等人的书还补充说,Bing 每年运行超过 10,000 个实验,效果这么大的简单改动几年才出现一次(Trustworthy Online Controlled Experiments)。
有两点启示。其一,光看仪表盘没人能猜到这个改动重要;是对照测试量出来的。其二,大多数想法没有效果,这正是需要对照组的原因。
例 3:观察法的广告衡量与实验结果不一致
Gordon、Zettelmeyer、Bhargava 和 Chapsky 把观察性方法与随机实验放在同样的广告活动上比较。他们用了 Facebook 的 15 个美国实验,涉及 5 亿条用户—实验观察,把实验作为基准,发现常用的观察性方法往往不能衡量广告的真实效果(Marketing Science,2019)。有些研究接近,有些不接近;作者还指出,即使数据相当全面,也可能不够。
对营销人员的启示不是观察数据没用,而是单看观察性结果,你无法判断它属于接近的那一类还是不接近的那一类。
例 4:一个功能与留存,用数字算一遍
示例数据:10,000 位新用户,一个新的「保存视图」功能,以及 30 天留存。本来就活跃的用户更可能尝试这个功能,而且不用功能也会留下。
| 分组 | 用户数 | 试用了功能 | 用户的 30 天留存 | 非用户的 30 天留存 |
|---|---|---|---|---|
| 本来就活跃 | 2,000 | 1,600(80%) | 70% | 68% |
| 其他用户 | 8,000 | 1,600(20%) | 25% | 23% |
| 全部 | 10,000 | 3,200 | 47.5% | 25.6% |
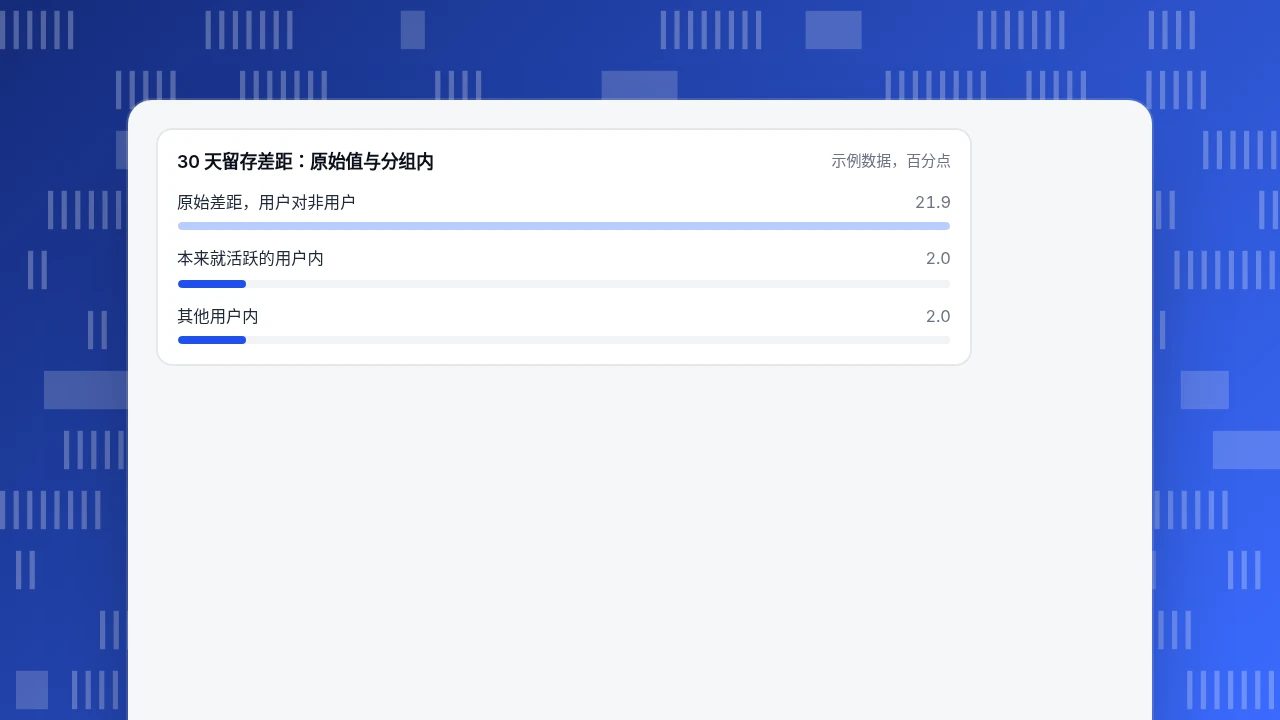
在整个用户群里比较功能用户和非用户,差距是 47.5% − 25.6% = 21.9 个百分点。在每个分组内部比较,两组的差距都是 2 个百分点(70% 对 68%,25% 对 23%)。原始差距把效果高估了 10.9 倍,因为活跃用户在功能用户里占比高(3,200 人中有 1,600 人),在非用户里占比低(6,800 人中只有 400 人)。
如果做随机留出组,随机 10% 的用户看不到这个功能,活跃用户就会在两组之间被平衡,测得的差距预计会落在 2 个百分点附近。仪表盘上的相关是真实的,但「这个功能让留存提升 22 个点」这个因果结论不成立。
30 天留存差距:原始值与分组内
示例数据,百分点不能随机时:Hill 的九个视角
当随机试验做不了时,证据要从多个方向累积。Austin Bradford Hill 在 1965 年的演讲里列出了判断一个关联时可以问的九个「视角」,并强调其中没有哪一个能带来无可争议的证明,也没有哪一个是必须满足的清单项(Hill,《皇家医学会会刊》,1965)。它们很容易翻译成产品问题:
| Hill 的视角 | 给产品团队的问题 |
|---|---|
| 关联强度 | 效果相比通常的噪声有多大? |
| 一致性 | 在不同的细分、国家和月份里都出现吗? |
| 特异性 | 功能是推动了它该推动的指标,还是什么都在动? |
| 时间先后 | 是先有使用,后有留存改善吗? |
| 剂量反应 | 功能用得更多的用户留存更好吗? |
| 合理性 | 你能用一句话说明机制吗? |
| 一贯性 | 与你已知的用户情况吻合吗? |
| 实验 | 有没有人真的撤掉功能并测量过? |
| 类比 | 别处类似的改动也是这样吗? |
观察数据里五个「是」可以建立一个论据,但不能代替「实验」那一行。
区分因果与巧合的快速检查
写下「导致」之前,按顺序做这几项检查:
- 先后。 X 发生在 Y 之前吗?如果 Y 在先,可能是反向因果(要流失的用户不再打开应用,所以「使用减少预示流失」有一部分就是流失本身)。
- 第三个因素。 有没有什么让 X 和 Y 都更可能出现?例 4 里的活跃用户就是这种模式。
- X 是谁选的? 如果人们是自己选的功能,在随机分配证明相反之前,都先假设存在选择偏差。
- 偶然。 找到这个结果之前,你做了多少次比较?比较多了,碰上一个侥幸结果就很正常;用 Bonferroni 这类校正,可以看出差多少。
- 剂量。 X 越多,Y 也越多吗?
- 重复。 在第二个时期或细分里也成立吗?
- 机制。 你能用一句话讲清 X 怎样推动 Y 吗?
如果第 1–3 项没通过,就到此为止。只有前三项通过,后四项才有意义。
让措辞与证据相符
| 你手里的证据 | 稳妥的措辞 | 避免 |
|---|---|---|
| 随机测试,样本足够 | 「这项改动使转化率提高了 X 个百分点(95% 区间……)」 | 不给区间就说「证明」 |
| 留出组或自然实验 | 「这项改动很可能提高了……」 | 夸大分组的随机程度 |
| 做了调整的观察数据 | 「在调整……之后,与……相关」 | 「导致」「驱动」 |
| 原始比较 | 「做了 X 的用户有 Y」 | 任何面向未来的说法(「将会提升」) |
措辞往往在仪表盘、聊天记录和汇报幻灯片里跑偏,要在源头改。
TapCub 能说明和不能说明的因果
还是「保存视图」的例子。TapCub 能显示谁用了这个功能、谁留下了;因果的那一步是 TapCub 之外的设计决定。
- 先看原始差距。 在 全端分析 › 行为分析 › 行为分析 里,对做过功能事件的人和没做过的人建留存报告。它能复现 47.5% 对 25.6% 的比较,仅此而已。
- 按活跃程度分层比较。 用 全端分析 › 用户 › 分群与标签 建一个「本来就活跃」的分群,或者做拆分,再重复一遍。差距缩小,是存在混杂因素的信号。
- 标出上线日。 在 配置 › 日期标注 里添加日期标注,让上线、活动和调价都出现在指标旁边的图上。
- 把解释当作解释。 全端分析 › 智能运营 › AI 助手 有「变化归因」,把指标的变化按渠道、来源域名、国家、设备和着陆页拆解。它显示变化出现在哪里,不说明为什么。
- 谨慎解读客服转化。 客服 › 客服报表 › 转化归因 对比聊过和没聊过的访客,并给出相对提升;聊过的访客少于 30 人时会提示。主动发起聊天的人往往本来就更接近购买,所以这个提升是上限,不是因果估计。
TapCub 不做实验、不分流、不设留出组。留出组由你自己的代码来分配,把分组作为事件属性发送,再用 TapCub 比较结果。
常见问题
因果关系有什么例子?
把新的结算按钮随机展示给一半访客,这一半的销量更高,就是因果证据,因为随机分配让两组除了按钮之外没有别的区别。一项把 16,608 名妇女随机分组、发现中风和乳腺癌风险更高的激素治疗试验,是另一个例子。
怎么证明因果关系?
随机决定谁得到改动,再比较结果。做不到时,就把几条证据结合起来:原因在结果之前,效果随暴露量增加,在不同群体里都成立,机制说得通。Hill 1965 年的视角是经典清单,其中没有一条是保证。
相关和因果有什么区别?
相关是指两个指标一起变化;因果是指改变一个会改变另一个。功能与留存的例子体现了差距:使用该功能的用户留存高 21.9 个点,但在可比的分组里差距只有 2 个点,因为活跃用户既更爱用,也更会留下。
观察数据能说明因果吗?
有时可以,但要小心。调整已知的混杂因素,检查一致性和剂量反应,可以增强论据,但未测量的因素仍然无法排除。在 Facebook 的 15 个广告实验里,常用的观察方法往往与随机结果不一致,所以值得做留出组。
p 值显著就能证明因果吗?
不能。p 值告诉你:如果没有效果,当前数据有多令人意外。它没有说两件事为什么一起变化。自己选择分组的两组人之间的显著差异,完全可能来自谁选择了进入哪一组。
资料来源
- Rossouw, J. E. 等(2002),Risks and benefits of estrogen plus progestin in healthy postmenopausal women,JAMA 288(3),321–333。核对于 2026-11-20。
- Kohavi, R. 和 Thomke, S.(2017),The Surprising Power of Online Experiments,《哈佛商业评论》;以及 Kohavi、Tang 和 Xu,Trustworthy Online Controlled Experiments 第 1 章。核对于 2026-11-20。
- Gordon, B. R.、Zettelmeyer, F.、Bhargava, N. 和 Chapsky, D.(2019),A Comparison of Approaches to Advertising Measurement: Evidence from Big Field Experiments at Facebook,Marketing Science 38(2),193–225。核对于 2026-11-20。
- Hill, A. B.(1965),The environment and disease: association or causation?,Proceedings of the Royal Society of Medicine 58,295–300。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
