免费找到指向你网站的反向链接,就是打开 Google Search Console 的链接报告和 Bing 站长工具的反向链接报告,再加上分析工具里的引荐来源和你的服务器日志。每个来源都是有文档化限制的样本,所以清单需要合并。下文给出每种方法的步骤、一个合并的实例,以及拿到结果之后该做什么。
读完你会知道
- Google 每个表格最多 1,000 行,Bing 最多 1,500 个域名;两者都不完整,所以至少用两个来源
- 引荐来源和日志只能找到被人点击的链接,而且浏览器默认只发送链出页面的域名
- 在示例中,只用 Search Console 会漏掉 21 个引荐域名中的 9 个,只用 Bing 漏掉 6 个;合并可以找回它们
五种免费方法找反向链接,以及各自的盲区
反向链接是别的网站指向你网站的链接。没有哪个免费来源能列出全部,所以实用的做法是把几个来源合起来,并清楚每一个的盲区。下面的数字来自各工具自己的帮助页。
| 方法 | 能看到什么 | 文档里的限制 | 盲区 |
|---|---|---|---|
| Google Search Console 的链接报告 | 你已验证网站的热门链入站点、热门被链页面和热门链接文字 | 表格限 1,000 行;每个切片最多导出 100,000 行;是样本,不是全部链接 | 不显示链接是否为 nofollow;只能看自己验证过的网站 |
| Bing 站长工具的反向链接报告 | 引荐域名、页面和锚文本;可以和另外最多两个网站比较 | 最多 1,500 个域名、每个域名 10,000 条反向链接、100,000 个页面网址、1,500 个锚文本;是有代表性的样本,不完整 | 只有一个有代表性的集合;需要验证网站 |
| 分析工具里的引荐来源 | 真正带来访客的网站 | 只有被点击过的链接 | 没人点过的链接,以及链出网站上的具体页面 |
| 服务器访问日志 | 每个请求及其 Referer 头,包括机器人 | 要自己解析日志 | 与引荐来源相同,但包含爬虫流量 |
| Common Crawl 网络图 | 由抓取数据构建的开放的主机级和域名级链接图 | 文件很大,需要数据处理工具;定期发布 | 不是你网站的专属报告,需要按你的域名过滤 |
至少用两个来源。同时出现在 Google 和 Bing 报告里的链接几乎肯定是真的;只出现在你的引荐来源里的链接,是真有人在用的链接。
| 来源 | 文档里的限制 | 示例中的域名数 |
|---|---|---|
| Google Search Console | 每个表格 1,000 行;是样本 | 12 |
| Bing 站长工具 | 1,500 个域名;每个 10,000 条反向链接;有代表性的集合 | 15 |
| 分析工具里的引荐来源 | 只有被点击的链接 | 5 |
| 合并 | — | 21 |
示例数据:域名清单仅为示意。7 个域名同时出现在 Google 和 Bing 里,21 个中有 12 个只被一个来源找到。
怎样在 Google Search Console 里找反向链接
先要有一个已验证的资源。然后:
- 在左侧菜单打开 链接。
- 在 外部链接 下,看 热门链入站点。这就是链接到你的域名清单。
- 点一个域名,看它链接到你的哪些页面,再点一次,看实际的链出页面。
- 打开 热门被链页面,看你自己的哪些页面吸引链接;打开 热门链接文字,看锚文本。
- 用 导出 保存表格;链接报告在「最新链接」和「更多样本链接」两个切片里各最多导出 100,000 行。
Google 自己的页面有两点提醒。报告「不是每一条链接的完整清单」,而且每个表格限 1,000 行,所以链接很多的网站会被截断。它也不显示链接是否带有 nofollow,所以不能把它当作传递价值的链接清单来读。
怎样在 Bing 站长工具里找反向链接
Bing 的报告免费,并且在两方面走得更远:显示的行数更多,还能查看其他网站的链接。
- 添加并验证你的网站,然后打开 反向链接。
- 域名 显示去重后的链入域名和每个域名的反向链接数(最多 1,500 个域名;打开一个域名可以看到最多 10,000 条反向链接);页面 显示每个链入网址以及它指向你的哪个页面(最多 100,000 个网址);锚文本 显示别人怎样描述你(最多 1,500 个)。
- 用 全部下载 导出。
- 用 任意网站的反向链接 把你的资料和最多两个其他网站比较。结果列出每个网站的前 10 个引荐域名和前 10 个锚文本,而筛选项 显示未链接到我的网站的域名 会列出链接到其他网站、却没有链接到你的域名。这个清单,就是「怎样找到链接过竞争对手的网站」的免费答案。
Bing 自己说,它的报告是「有代表性的一组链接」,不是完整的资料。
怎样从引荐来源和服务器日志里找反向链接
引荐来源找到的是能带来流量的链接,对你价值最大。有一个限制要知道。浏览器默认的 Referrer-Policy 是 strict-origin-when-cross-origin:对于来自其他网站的链接,浏览器只发送链出页面的来源,不发送路径或查询字符串。所以你的分析工具通常只能告诉你是哪个域名链接了你,而不是哪个页面;要找到页面,需要打开链出网站,或到 Search Console 里看。
要从原始访问日志里取引荐来源,就解析 Referer 字段。示例数据:14 行标准 combined 日志格式的记录,来自 www.example.com 上的网站。
203.0.113.5 - - [12/Nov/2026:08:01:02 +0000] "GET /guide HTTP/1.1" 200 5120 "https://blog.partner.example/" "Mozilla/5.0"
203.0.113.7 - - [12/Nov/2026:09:15:44 +0000] "GET /pricing HTTP/1.1" 200 4096 "https://www.google.com/" "Mozilla/5.0"
198.51.100.8 - - [12/Nov/2026:12:30:00 +0000] "GET /guide HTTP/1.1" 200 5120 "https://spam-links.example/" "SomeCrawler/1.0"
... 另外 11 行
一个简短的脚本保留引荐主机,去掉不属于反向链接信号的内容:
import re, collections
from urllib.parse import urlparse
OWN = {"www.example.com", "example.com"}          # 自己的域名
SEARCH = {"www.google.com", "www.bing.com"}       # 搜索引擎
pat = re.compile(r'"[A-Z]+ (\S+) [^"]+" \d+ \d+ "([^"]*)" "([^"]*)"')   # 取出路径、引荐、UA
hosts = collections.Counter()
for line in open("access.log"):
    m = pat.search(line)
    if not m: continue
    path, ref, ua = m.groups()
    if re.search(r"bot|crawler|spider", ua, re.I): continue   # 爬虫不是访客
    if ref == "-": continue                                    # 直接访问
    h = urlparse(ref).hostname
    if h in OWN or h in SEARCH: continue                       # 站内或搜索
    hosts[h] += 1
print(hosts.most_common())
在这 14 行示例上,脚本去掉 2 个爬虫请求、1 次直接访问、1 次站内点击和 2 次搜索访问,保留 8 条:blog.partner.example 4 条、forum.community.example 2 条、newsletter.example 1 条、t.co 1 条。注意「spam-links」那一行是爬虫,所以它不算引荐。日志里的引荐来源很容易伪造,所以只出现在日志里、没有任何工具收录的主机,在相信它之前要先看一眼。
怎样合并这几份清单
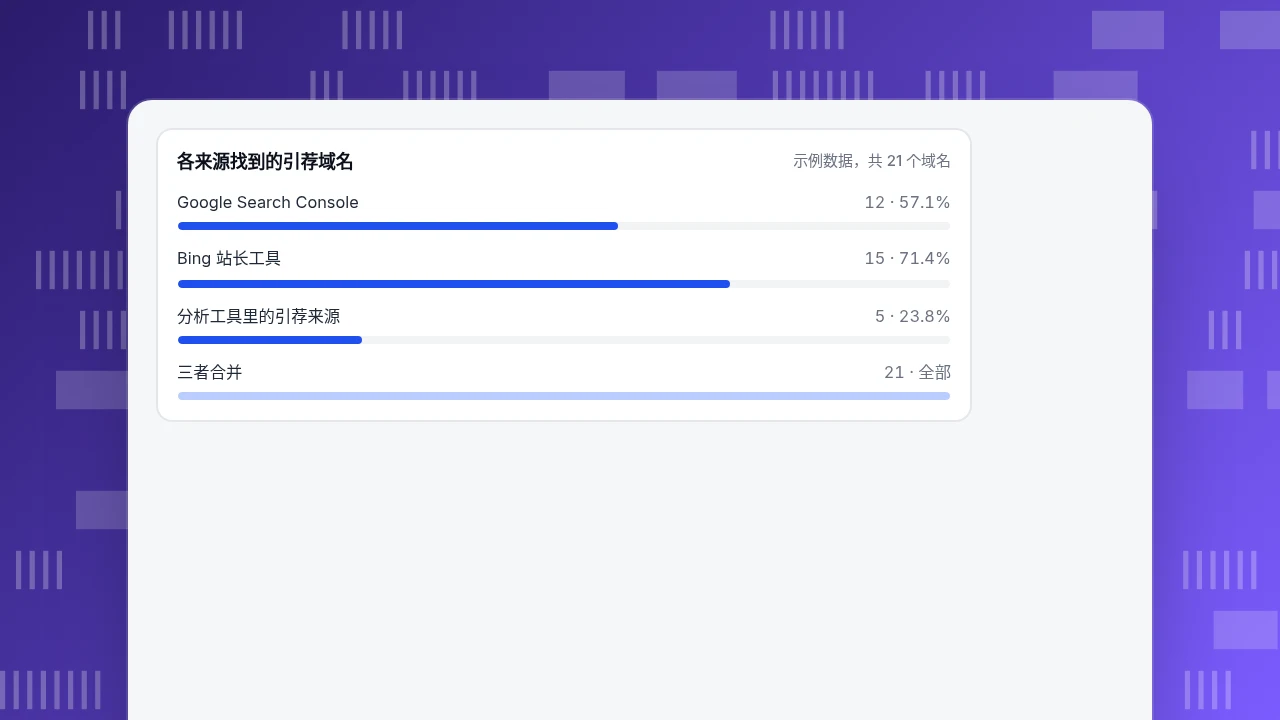
每个来源找到一些链接,漏掉另一些。示例数据:一个网站从三个来源得到的引荐域名。
| 来源 | 找到的域名 | 占全部 21 个的比例 |
|---|---|---|
| Google Search Console | 12 | 57.1% |
| Bing 站长工具 | 15 | 71.4% |
| 分析工具里的引荐来源 | 5 | 23.8% |
| 三者合并 | 21 | 全部 |
有 7 个域名同时出现在 Google 和 Bing 里;21 个中有 12 个(57.1%)只被一个来源找到。如果只用 Search Console,你会漏掉 21 个中的 9 个(42.9%);只用 Bing,则漏掉 6 个(28.6%)。引荐来源里有两个域名,一个新闻邮件和一个资源页,也在 Bing 的清单里,而链接缩短服务 t.co 在其他地方都没有出现。
合并只要几行代码:把每份清单导出成一个域名文本文件,用集合运算。
gsc = set(open("gsc.txt").read().split())          # Google 的域名
bing = set(open("bing.txt").read().split())        # Bing 的域名
ref = set(open("referrers.txt").read().split())    # 引荐来源的域名
union = gsc | bing | ref                           # 三份合并去重
print(len(union), "domains;", len(gsc & bing), "in both Google and Bing")
把合并后的文件按日期保存。下个月再合并一次,对比两份就能看出新增和丢失的链接。
各来源找到的引荐域名
示例数据,共 21 个域名做大规模分析时的免费链接图
Common Crawl 发布主机级和域名级的网络图,由它的抓取数据构建,包含所有类型的链接,连指向脚本和字体的链接也在内。域名图按公共后缀列表,在付费级域名(pay-level domain)层面汇总主机图。列出的最新版本是 cc-main-2026-aug-sep-oct。文件很大,需要数据处理工具,所以这个方法适合分析人员,不适合快速检查;用你的域名过滤边列表,就能找到链接到它的域名。
拿到清单之后怎么做
链接清单只有改变你的行动才有用。用四条规则整理它:
| 你看到什么 | 说明什么 | 行动 |
|---|---|---|
| 一个会带来访客的新域名 | 一条有效的链接 | 向对方致谢,考虑建立联系 |
| 链接指向你网站上返回 404 的页面 | 价值指向了空处 | 把它重定向到最接近的有效页面 |
| 上个月清单里有、这个月没有的域名 | 链接丢失了 | 检查页面是被删除了,还是链接被改了 |
| 一批来自无关垃圾域名的链接 | 多半可以忽略 | 不要去追;Google 说它通常会忽略来自已知垃圾站点的链接 |
如何获得链接,见如何获取反向链接;反向链接的定义,见反向链接术语页。
在 TapCub 里怎么看哪些链接在带来访客
TapCub 不抓取整个网络,也不列出反向链接,没人点过的链接更看不到。它显示带来了人的链接,也就是上面的引荐来源方法。
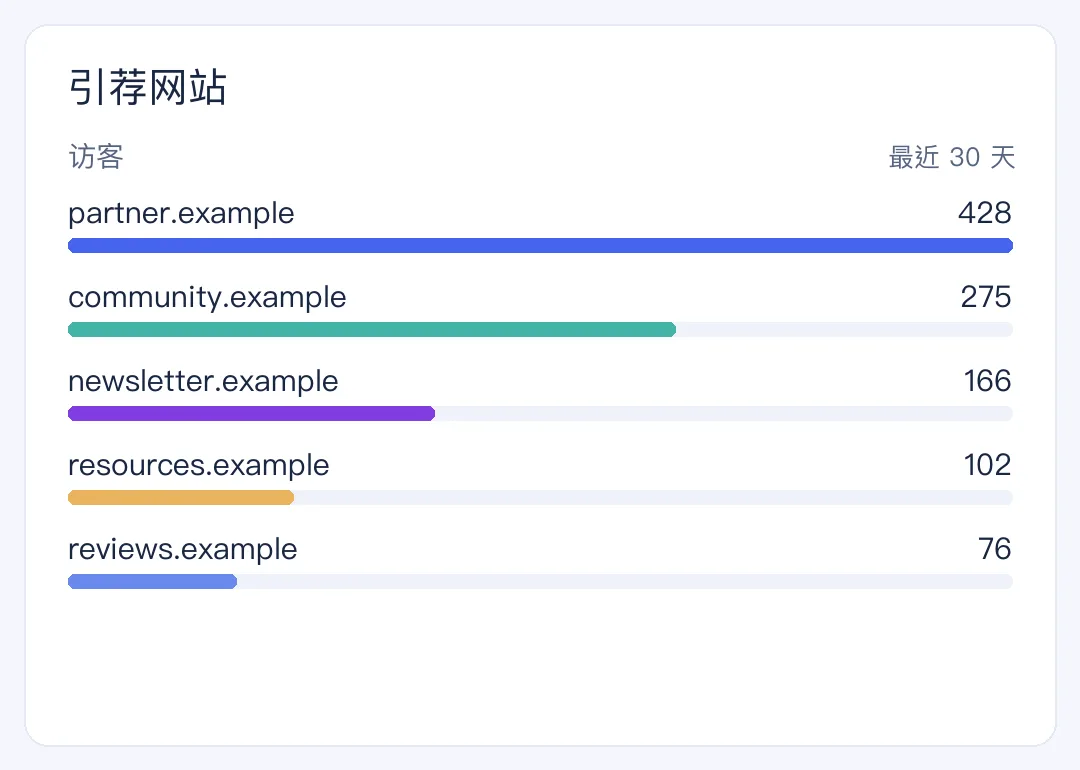
- 读引荐来源。 打开 网站统计 › 来源,选择 引荐来源 标签页。每行有访客、会话、浏览量、跳出和时长。默认情况下,一次会话只记在它到达时的来源名下;切换到 每次到达,会把会话中间从外部网站到达的情况也算进去。来自你自己网站的链接算站内,不算引荐。
- 筛选到某一个引荐来源。 点一行把它加为筛选条件,其他报表会随之收窄,这样你能看到这条链接把人带到哪些页面,以及他们是否转化。
- 识别 SEO 工具的爬虫。 构建反向链接索引的爬虫,会出现在 网站统计 › 机器人 里,和访客分开;它们做什么,见 AhrefsBot 和 SemrushBot。
- 把搜索数据分开看。 连上 Search Console 之后,监测 › 搜索表现 按页面和查询词显示点击、展现和排名;它不是反向链接报告,但能看出获得链接的页面是否也获得了搜索流量。
- 把合并后的清单记下来,带上日期,每月复查一次。
TapCub 给你的是被点击的那一半。其余部分请用 Search Console 和 Bing。来源与 UTM讲解了引荐来源和渠道是怎样分组的。
常见问题
怎样免费看到谁在链接我的网站?
用 Google Search Console 的链接报告和 Bing 站长工具的反向链接报告。两者对你验证过的网站都免费,列出引荐域名和页面,并能导出文件。两者都不完整,所以要和分析工具里的引荐来源合起来,比较各份清单。
为什么 Search Console 显示的反向链接比其他工具少?
Google 的报告是样本,每个表格限 1,000 行,并且说明它不是每一条链接的完整清单。它也可能漏掉未被索引的页面和重复项。付费工具运行自己的爬虫,报告的数量不同,所以没有两个工具完全一致。
怎样找到链接过竞争对手、但没链接我的网站?
Bing 站长工具的「任意网站的反向链接」可以把你的资料与最多两个其他网站比较,并筛选出没有链接到你的域名。它列出每个网站的前 10 个引荐域名,这就是值得去联系的地方清单。
怎样找到指向某个具体页面的反向链接?
在 Search Console 的链接报告里,打开热门被链页面,点那个页面,再看链入的网站。在 Bing 里,页面视图列出每个链入网址,以及它指向你网站上的哪个页面。也可以按着陆页筛选分析工具里的引荐来源。
带 nofollow 的反向链接还会出现吗?
会。Search Console 的链接报告不标明链接是否为 nofollow,所以没法用它来筛选。nofollow 链接仍然可以带来访客,所以无论如何都会出现在引荐来源里。
资料来源
- Google,链接报告,Search Console 帮助:各部分、1,000 行的表格限制、100,000 行的导出,以及「不是完整清单」的说明。核对于 2026-11-20。
- Microsoft,反向链接,Bing 站长工具帮助:域名、页面、锚文本的限制,「有代表性的集合」说明,以及任意网站的反向链接。核对于 2026-11-20。
- MDN,Referrer-Policy:默认值
strict-origin-when-cross-origin以及它发送什么。核对于 2026-11-20。 - Common Crawl,网络图:主机级和域名级图以及最新版本。核对于 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
