选聊天机器人供应商:把你的需求加权,权重加起来是 100;用同一套标准给每个入围供应商打 1 到 5 分;算 Σ(权重 × 分数) ÷ 100;再检查赢家在权重移动 10 个点后是否还成立。例子里同样三个供应商,对小型网店的排名是 Y、X、Z,对受监管的欧盟服务机构是 Z、Y、X;没有哪个供应商对所有人都赢,只在某一组权重下赢。
读完你会知道
- 权重表达你的需求:同样的分数,Y 在买家 A 的权重下是 3.75、在买家 B 的权重下是 3.45,而 Z 从 2.85 升到 3.90
- 如果移动 10 个点的权重就改变赢家(0.45 的领先变成 0.05),就把几家当作打平,用试用结果决定
- 用 30 个真实问题测准确度,重点看较难的 10 个里的错误回答;聊天机器人的回答就是你的陈述
怎么选聊天机器人供应商?按你的需求打分,而不是看功能清单
选聊天机器人供应商的办法是:写下你的需求,给每项需求加权,用同一套需求给每个入围的供应商打 1 到 5 分,再检查赢家在权重变动之后是否还站得住。做成算术的理由是,厂商的对比页是按厂商自己的标准给每个产品打分的。加权矩阵把你的优先级放进公式,也能让你看出两家什么时候实际上打平。
本文给出评估标准,给出一个两类截然不同的买家的打分例子,其中排名会翻转,给出根据 GDPR 第 28 条对处理方的要求可以问的数据处理问题,给出签约前测试回答准确度的方法,给出带盈亏平衡点的成本模型,以及一个两周试点计划。不点任何供应商的名:可迁移的是流程,任何具体的产品对比一个季度就过时了。想看工具类型清单,见网站聊天工具;想了解聊天机器人的总成本,见聊天机器人要花多少钱。
该比较哪些标准?
| 标准 | 要问什么 | 要求提供的证据 |
|---|---|---|
| 回答可控性 | 机器人能只根据我提供的内容回答吗,我能看到它用了哪个来源吗? | 用你自己的文档做的演示;它拒绝回答的问题清单 |
| 转人工 | 它答不了时,真人能拿到完整对话吗? | 一次中途升级的测试对话 |
| 数据处理 | 数据存在哪里、存多久、子处理方是谁、我能删除吗? | 数据处理协议;子处理方名单;保留设置 |
| 报表 | 我能看到已解决、已转人工和没答上的问题吗? | 在真实数据上的示例报表,而不是营销用的仪表盘 |
| 成本 | 月费是多少,量增长时什么会让它变化? | 你当前用量和三倍用量下的书面报价 |
| 搭建投入 | 到第一个上线的回答要多少小时,谁来维护? | 做过的人给出的时间估计,加上你这边一位明确的负责人 |
| 集成 | 它从哪些系统读、往哪些系统写,谁来建? | 清单,写明哪些包含、哪些要定制 |
| 语言 | 它用哪些语言回答,测试过吗? | 在你服务的每种语言里各测一次 |
不是每一行对每位买家都重要。下一节说明权重怎么表达这一点。
| 供应商 | 买家 A(小型网店) | 买家 B(受监管的欧盟服务机构) |
|---|---|---|
| X:模板机器人 | 3.45 | 2.75 |
| Y:在线客服加 AI | 3.75 | 3.45 |
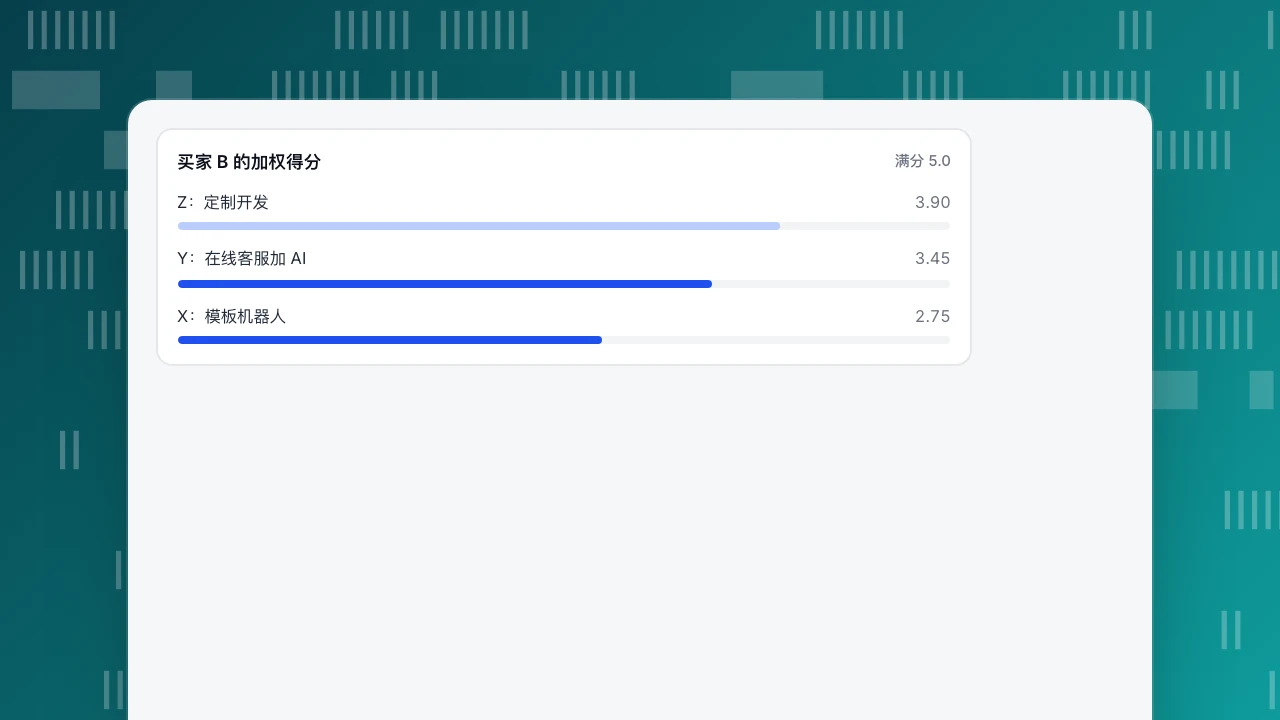
| Z:定制开发 | 2.85 | 3.90 |
A 的权重偏重成本和搭建投入;B 的权重偏重数据处理和回答可控性。总分 = Σ(权重 × 分数) ÷ 100。
示例:两位买家的加权矩阵
方法:给每项标准一个权重,使权重加起来是 100,给每个供应商在每项标准上打 1 到 5 分,再算 Σ(权重 × 分数) ÷ 100。总分 5.0 表示每项都满分。
示例数据:三个匿名供应商,试用之后按六项标准打分。
| 标准 | 供应商 X:模板机器人 | 供应商 Y:在线客服加 AI | 供应商 Z:定制开发 |
|---|---|---|---|
| 成本 | 5 | 4 | 2 |
| 搭建投入 | 5 | 4 | 1 |
| 转人工 | 2 | 4 | 3 |
| 回答可控性 | 2 | 3 | 5 |
| 数据处理 | 3 | 3 | 5 |
| 报表 | 2 | 4 | 3 |
两位需求不同的买家:
- 买家 A:一家小型网店,想在预算不多的情况下本月上线。
- 买家 B:欧盟的一家受监管的服务机构,必须控制机器人说什么、数据去哪里。
| 标准 | 买家 A 的权重 | 买家 B 的权重 |
|---|---|---|
| 成本 | 25 | 10 |
| 搭建投入 | 20 | 5 |
| 转人工 | 20 | 20 |
| 回答可控性 | 15 | 25 |
| 数据处理 | 10 | 30 |
| 报表 | 10 | 10 |
| 合计 | 100 | 100 |
计算得到的总分:
| 供应商 | 买家 A | 买家 B |
|---|---|---|
| X:模板机器人 | 3.45 | 2.75 |
| Y:在线客服加 AI | 3.75 | 3.45 |
| Z:定制开发 | 2.85 | 3.90 |
其中一个总分怎么算:买家 A 的供应商 Y = (25×4 + 20×4 + 20×4 + 15×3 + 10×3 + 10×4) ÷ 100 = (100 + 80 + 80 + 45 + 30 + 40) ÷ 100 = 3.75。买家 B 的供应商 Z = (10×2 + 5×1 + 20×3 + 25×5 + 30×5 + 10×3) ÷ 100 = (20 + 5 + 60 + 125 + 150 + 30) ÷ 100 = 3.90。
同样的三个供应商,对买家 A 的排名是 Y、X、Z,对买家 B 是 Z、Y、X。没有哪个供应商本身是最合适的,只有在某一组权重下才有一个最合适的。
敏感性检查。 把买家 B 的 10 个点权重从数据处理(30 降到 20)移给成本(10 升到 20)。供应商 Z 从 3.90 降到 3.60(数据上少 10 × 5,成本上多 10 × 2),供应商 Y 从 3.45 升到 3.55(少 10 × 3,多 10 × 4)。领先幅度从 0.45 缩小到 0.05。如果移动 10 个点的权重就翻转结果,就把这两家当作打平,用试用结果而不是矩阵来决定。
买家 B 的加权得分
满分 5.0该问哪些数据处理问题?
如果机器人处理欧盟居民的个人数据,GDPR 第 28 条规定了你(控制方)和供应商(处理方)之间的合同里必须有什么。把它变成问题:
- 指令。 供应商只按你的书面指令处理数据吗?
- 子处理方。 使用另一个处理方之前,他们会取得你的事先书面授权(具体授权或一般授权)吗?一般授权下,他们必须把计划中的变更告诉你,让你能提出异议。要一份当前的名单。
- 安全与保密。 员工受保密约束吗,第 32 条的安全措施到位了吗?
- 数据主体请求。 他们会协助你回应访问和删除请求吗?
- 删除或返还。 合同结束时,他们会按你的选择删除或返还全部个人数据吗?
- 审计。 他们会提供信息证明合规,并允许审计(包括检查)吗?
- 链条下游的责任。 如果子处理方出问题,最初的处理方对你仍负完全责任。
不能书面回答这些问题的供应商,本身就已经告诉了你一些事。这是一份清单,不是法律意见;请你自己的法律顾问审阅协议。
签约前怎么测试回答的准确度?
聊天机器人的回答就是你的陈述。在 Moffatt v. Air Canada(2024 BCCRT 149)一案中,不列颠哥伦比亚省的民事解决庭裁定,航空公司要对其网站聊天机器人给客户的错误信息负责。要把准确度当作合同风险,而不仅仅是质量指标。
对每个入围的供应商,用你自己的内容做这个测试:
- 收集 30 个真实问题,来自你的客服邮箱:20 个内容能回答,5 个只能部分回答,5 个完全答不了。
- 给每个回答标记:正确、部分正确、错误或拒答。
- 计算: 正确回答数 ÷ 20 个能回答的问题;错误回答数 ÷ 10 个答不了和只能部分回答的问题。第二个数才是关键。机器人自信地回答了本该拒答的问题,责任就是从这里来的。
- 开始前先定标准: 比如 20 个里至少 17 个正确(85%),较难的 10 个里最多错 1 个。按你的风险调整,但要先写下来。
一个供应商能答对 20 个中的 18 个,但在难题里错了 4 个 / 10,它比答对 16 个、难题里错 0 个的供应商更差,因为后者在不知道时会拒答。
转人工是怎么工作的,怎么测试?
试用中要求看到三件事:
- 触发条件。 什么会把对话转给真人:访客要求、低置信度的回答,还是关键词?你能改吗?
- 上下文。 坐席能看到整段对话和访客所在的页面吗,还是访客得重复一遍?
- 时段。 非工作时间会怎样:留言表单,还是一个一直承诺会回复的机器人?
自己做这个测试:发起一次对话,问一件知识库之外的事,计时看要多久才能让一个手里拿着对话记录的真人接手。
成本怎么权衡,盈亏平衡点在哪?
供应商的收费形状不同:固定月费、按每个已解决对话收费,或两者混合。要在你的用量下比较。
示例数据:供应商 P 月费 $400,加每个已解决对话 $0.50。供应商 Q 月费 $0,每个已解决对话 $1.50。
| 每月已解决对话数 | 供应商 P | 供应商 Q |
|---|---|---|
| 200 | $500 | $300 |
| 400 | $600 | $600 |
| 1,000 | $900 | $1,500 |
盈亏平衡:400 + 0.50x = 1.50x,所以 x = 每月 400 个已解决对话。低于 400,Q 更便宜;高于 400,P 更便宜。1,000 个对话时,P 每个 $0.90,Q 每个 $1.50。决定之前,给两家都加上搭建和维护的小时数(你的时间,按小时成本折算)。
两周试点是什么样的?
| 天数 | 任务 | 产出 |
|---|---|---|
| 1–2 | 把同样 20 份文档载入每个入围供应商 | 相同的输入 |
| 3–4 | 做 30 题测试 | 准确度和难题错误数 |
| 5–6 | 测试转人工和非工作时间的行为 | 转到真人的耗时 |
| 7–8 | 用书面形式提出数据处理问题 | 书面答复 |
| 9–10 | 用试用前约定好的权重给矩阵打分 | 总分 |
| 11–14 | 做敏感性检查;让赢家在一个低流量页面上真实运行 | 决定 |
TapCub 的聊天怎么对照这份清单
TapCub 的在线客服是候选类型之一:一个人工在线客服,外加基于知识库的 AI 回复,所以应该和其他候选一样按上面的标准来评判。
- 回答可控性。 在 客服 › 知识库,问答条目原样发送、不调用 AI;文档条目经检索后用来起草回答。用 Playground 测试,不耗额度。
- 转人工。 在 客服 › 聊天设置 › AI 接待,可选关闭、仅坐席全离线时、或 AI 先答(坐席接手、人工回复或访客要求人工时停止)。资料不够时转交真人。
- 报表。 客服 › 客服报表 显示会话数、解决率、首次响应和知识库命中率(直接问答匹配或检索回答的问题占比)。
- 边界。 AI 回复只生成文字。它不改订单、不发邮件、不调用其他系统;聊天组件也没有聊天前表单,所以要邮箱就在对话里问,或用离线留言。
如果你需要一个能执行退款、改订单这类操作的机器人,TapCub 不做;有了之后,它衡量聊天的结果和转化。
常见问题
选聊天机器人供应商要看什么?
回答可控性、转人工、数据处理、报表、你用量下的成本、搭建投入、集成和语言。按你的需求加权,用同一个量表给每个供应商打分。
怎么公平地比较聊天机器人供应商?
用加权矩阵:权重加起来是 100,分数 1 到 5,总分 = Σ(权重 × 分数) ÷ 100。然后在两项权重之间移动 10 个点;如果赢家变了,这几家实际上打平。
关于数据要问哪些问题?
数据是否只按你的指令处理,子处理方是谁、变更时怎么通知你,合同结束时数据怎么删除或返还,以及是否允许审计。这些对应 GDPR 第 28 条。
公司要对自己的聊天机器人说的话负责吗?
在 Moffatt v. Air Canada(2024 BCCRT 149)一案中,裁判庭裁定航空公司要对其网站聊天机器人给出的错误信息负责。上线之前先测准确度和错误回答率。
聊天机器人试用要多久?
两周足够载入内容、做 30 题准确度测试、测试转人工并给矩阵打分。更长的试用多半只是推迟决定。
资料来源
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
