功能需求管理,是记录每条需求背后的问题,用同一把尺子给需求打分,并且每一条都有答复。常用的尺子是 RICE:触达 × 影响 × 信心 ÷ 工作量。下文给出要记的六个字段、五条示例需求在估计变化下的得分,为什么提到次数会误导你,以及三种答复的对照表。
读完你会知道
- 记录客户遇到的问题,而不只是他们要的功能,并且数不重复的人,不数提到的次数
- 用固定的 RICE 量表打分,再把最没把握的估计翻倍或减半:前三名不变就直接决定
- 触达要从产品使用里测,提到次数奖励声音最大的渠道,甚至会把排名颠倒
功能需求是什么,不是什么?
功能需求,是客户或同事针对自己遇到的问题提出的一个解决办法。人们写下来的是办法(「加个深色模式」),你真正需要的是问题(「我晚上用,白屏刺眼」)。两者不是一回事,优先级排错,大多从这条缝里开始。
尼尔森诺曼集团把同一个陷阱叫作「直接给方案」:团队常常「太快提出方案,却没有先弄清问题」,它的建议是「先提问,再谈方案」(NN/g)。落到功能需求上就是一条规则:记问题,把对方建议的办法当备注。
需求也不是承诺、不是缺陷、不是投票。缺陷是行为和你发布的功能不符;投票是一个人的偏好只算一次;需求清单是一份带证据的问题表,下面的打分把它变成顺序。
一条需求进来,要记哪些内容?
不管来自哪个渠道(客服对话、销售电话、邮件、社区帖子),每条需求都写成一行,固定六个字段:
| 字段 | 写什么 | 之后有什么用 |
|---|---|---|
| 问题 | 用对方的话写一句:想做什么、被什么挡住 | 能评估别的解法,不只是对方提的那个 |
| 建议的办法 | 对方要的功能,当备注 | 留住想法,又不让它定义问题 |
| 谁 | 账户或用户 ID,不只是姓名 | 之后能数出不重复的人数 |
| 现有替代做法 | 他们现在怎么凑合 | 替代做法省事,影响就小;很费事,影响就大 |
| 频率 | 多久遇到一次(每天、每月、一次) | 用来估计影响 |
| 链接 | 对话、工单或电话记录的地址 | 任何人一分钟内能核对证据 |
两个习惯让清单保持诚实。其一,按问题合并重复,不按字面合并:「导出 Excel」「下载我的表格」「要 CSV」是同一行、三个提出者。其二,数不重复的人,不数提到的次数。一位客户问了五次,是一个数据点,带五个时间。
RICE 打分是怎么算的?
RICE 把一条需求变成一个数,让五条互相竞争的需求能放在同一个尺度上比。它由 Intercom 发表,得分是 触达 × 影响 × 信心 ÷ 工作量(Intercom)。Intercom 的定义:
- 触达(Reach):一个时间段内受影响的人数,例如每季度多少客户。
- 影响(Impact):对每个人的效果,用固定量表:3 极大、2 高、1 中、0.5 低、0.25 极小。
- 信心(Confidence):你对其他估计有多把握:1.0 高、0.8 中、0.5 低,更低就是赌一把。
- 工作量(Effort):产品、设计和工程投入的总量,单位是人月。
得分可以读作「每投入一人月能带来的总影响」。两点提醒。其一,团队必须用同一套量表;另一家公司的 RICE 模板就把影响和工作量改成 1–5 分(Atlassian),两种方法的得分不能互相比较。其二,RICE 是排序工具,不替你做决定,用它找出分歧在哪,再讨论那一处。
| RICE 输入 | Intercom 量表 | 数字从哪来 |
|---|---|---|
| 触达 | 一个时间段内的人数,例如每季度用户数 | 碰过该功能的不重复用户数,来自产品数据 |
| 影响 | 3 极大、2 高、1 中、0.5 低、0.25 极小 | 需求所在步骤的流失或损耗时间 |
| 信心 | 1.0 高、0.8 中、0.5 低 | 有几份相互独立的证据 |
| 工作量 | 产品、设计、工程合计的人月 | 团队自己的估计,每条需求单位一致 |
量表出自 Intercom(2026-11-20 核对)。另一家厂商的模板对影响和工作量用 1–5 分,不同方法的得分不能互相比较。
算例:给五条需求打分
示例数据:一款 B2B 网页应用,每季度约有 3,000 名活跃用户,收集到五条需求。工作量是工程团队估的人月数。
| 需求 | 触达(每季度用户数) | 影响 | 信心 | 工作量 | 得分 |
|---|---|---|---|---|---|
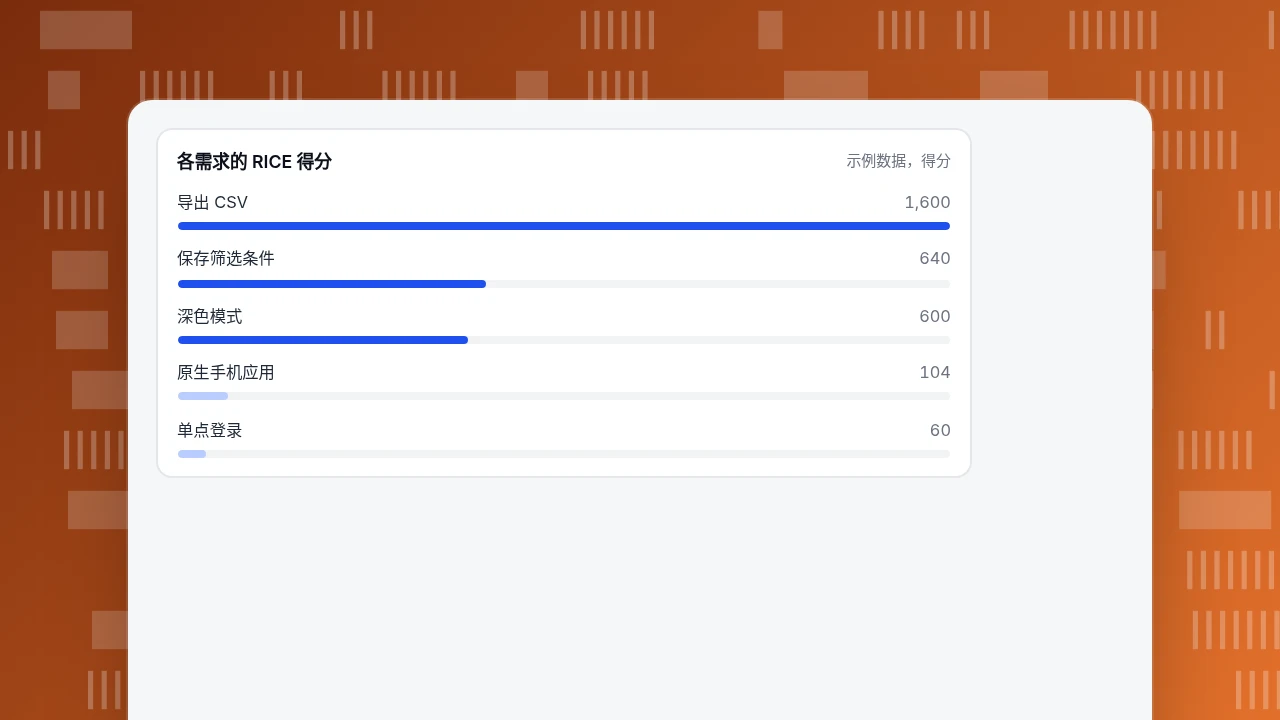
| 导出 CSV | 800 | 2 | 1.0 | 1 | 1,600 |
| 保存筛选条件 | 1,200 | 1 | 0.8 | 1.5 | 640 |
| 深色模式 | 3,000 | 0.5 | 0.8 | 2 | 600 |
| 原生手机应用 | 2,500 | 1 | 0.5 | 12 | 104 |
| 单点登录 | 150 | 3 | 0.8 | 6 | 60 |
验算首行:800 × 2 × 1.0 ÷ 1 = 1,600。第四行:2,500 × 1 × 0.5 ÷ 12 = 104.2。顺序是导出 CSV、保存筛选条件、深色模式、手机应用、单点登录。
读表别只看顺序。单点登录对每个人的影响最大(3),但只触达 150 人、要六个人月,所以只有 60 分。这不等于企业客户不重要,而是说按这组输入,要先拿出单点登录卡住了订单的有力证据,它才可能超过导出 CSV。证据应该写进信心,或者走另一种决策(合同里的承诺,而不是打分)。
各需求的 RICE 得分
示例数据,得分怎么检验排名稳不稳?
会改变冠军的估计,就是该复查的估计。把最没把握的一个输入改掉,一次只改一个,重新算,看顺序动不动。示例数据下:
- 导出 CSV 要花两倍时间(工作量 1 → 2):得分减半到 800,仍排第 1,这个结论很稳。
- 深色模式其实很容易做(工作量 2 → 1):得分翻倍到 1,200,从第三升到第二,超过保存筛选条件(640)。
- 单点登录实际触达 400 个账户、信心升到 1.0:400 × 3 × 1.0 ÷ 6 = 200,从第五升到第四,超过手机应用(104)。
- 手机应用的信心从 0.5 升到 0.8:2,500 × 1 × 0.8 ÷ 12 = 166.7,单独看,它会稳坐第四。
判断规则:某个估计减半或翻倍,前三名都不变,就别再估了,直接决定。如果会变,下一个小时花在测量那一个输入(通常是触达)上,而不是争论公式。
为什么需求条数会误导你?
条数奖励的是声音最大的渠道。假设清单里深色模式被提到 40 次,单点登录 12 次。按提到次数排,深色模式领先三倍多。各自除以可能受影响的人数,结论就反过来:
- 深色模式:40 次 ÷ 3,000 活跃用户 = 1.3% 的用户开过口。
- 单点登录:12 次 ÷ 150 个可能用到的账户 = 这一组的 8.0%。
提到次数衡量的是开口有多容易,不是多少人受影响。触达应该来自产品数据:上个季度有多少不重复用户碰过这条需求所在的功能。如果上季度 800 人导出过表格,其中 40 人提了更好的导出,触达就是 800,这 40 人只是证明问题确实被感受到,而不是问题的大小。
怎样拒绝需求又不失去客户?
每条需求都有三种答复之一,提出者应该知道是哪一种:
| 答复 | 含义 | 有效的回复 |
|---|---|---|
| 已规划 | 得分高,已排期 | 「我们在做,上线时我通知你」 |
| 暂不做 | 得分低或被卡住,但问题是真的 | 「我记下了你想做的事。它目前排不过正在做的,我会在 [日期] 再看」 |
| 不做 | 与产品方向冲突 | 「我们不会做,因为 [原因]。其他客户通常这样处理」 |
「暂不做」的回复示例:「谢谢你说明需要每月给财务交一份报表。现在没有定时导出,本季度也不在计划里。我已把你的场景和其他记录放在一起,1 月 15 日会重新过一遍清单。在那之前,表格下载可以满足一次性的版本。」
三个细节让这类回复不像敷衍:说出你听到的问题,用一个分句讲清取舍,给一个复审日期,并且到那天真的复审。
做完之后怎么确认功能有用?
打分发生在动工之前,所以要用一个数字把环闭上。上线时写下「影响」估计所假设的指标(例如「每月导出过的活跃用户占比」)和发布前的数值,四周后看同一个指标。如果影响打了 2 分(高),指标却没动,说明下一轮要重新校准影响量表,这比争论哪个需求赢了更值得在复盘里花时间。
功能需求管理的常见错误
- 给方案打分,而不是给问题打分。两条需求说的是同一个问题,就打一次分,再比较两种解法。
- 把信心当乐观。证据只有一次对话时就填 0.5,并且当真。
- 工作量单位混用。一条用人月,另一条用 T 恤尺码,得出的分数没有意义。
- 让一个大客户决定触达。一个客户的 10,000 个席位是一笔交易,不是触达数字,按承诺处理。
- 从不拒绝。不答复的需求清单会越长越没人看。
在 TapCub 里如何支撑功能需求打分
TapCub 不管理功能需求,不做投票板,也不发布路线图;它提供让打分诚实的数字。上面五条需求的例子,可以这样走:
- 在对话里收集证据。在 客服 › 客服工作台,每个对话进来时带着访客的来源、当前页面和最近的浏览轨迹,还能一键打开统计里的访客档案,所以「谁」和问题出现的页面不用再追问。
- 测量触达。在 全端分析 › 行为分析 › 事件分析,统计最近 90 天里触发了该需求对应事件(例如导出事件)的不重复用户数。这就是触达,单位是每季度用户数。
- 用漏斗估计影响。在 全端分析 › 行为分析 › 行为分析,围绕该需求所在的流程建一条漏斗。流失最多的一步会被标出,步转化率告诉你修复还有多大空间。
- 标记发布日。在 配置 › 日期标注 里给发布当天加一条标注,之后对比前后变化时,读的是有标记的日期。
- 四周后复查。用从标注日开始的日期范围重新打开同一个事件分析或漏斗,和你写下的基线对比。
TapCub 不给需求打分、排序或回复;公式留在你自己的表格里,TapCub 提供触达和前后对比的指标。
常见问题
功能需求是什么?
功能需求是客户、同事或用户针对一个问题提出的解决办法。要记录的是问题、谁遇到、多久一次,以及他们现在怎么凑合。建议的功能只当备注,因为同一个问题可能有比对方提的更便宜的解法。
怎样给功能需求排优先级?
每条按触达、影响、信心、工作量用固定量表打分,再按 触达 × 影响 × 信心 ÷ 工作量 排序。把最没把握的输入翻倍或减半来检验排名,前三名不变就可以决定。
应该做多少条功能需求?
按得分从高到低做,直到产能用完,而不是定一个固定数量。每个周期留一部分给稳定性和缺陷修复,因为需求也要和这些工作竞争;得分只在需求之间比较。
怎样拒绝一条功能需求?
先说明是哪种答复(已规划、暂不做、不做),点出你听到的问题,用一个分句讲取舍,并定一个复审日期。有日期的「暂不做」比沉默更诚实,也比含糊的「也许」代价小。
可以只按投票数排序吗?
不建议只靠投票。投票反映的是提出有多容易,会偏向声音最大的渠道。把它当作信心的证据,再配合从产品使用里测出来的触达。
资料来源
- Intercom,「RICE: Simple prioritization for product managers」:触达、影响(3 / 2 / 1 / 0.5 / 0.25)、信心(高 1.0 / 中 0.8 / 低 0.5)和以人月计的工作量。https://www.intercom.com/blog/rice-simple-prioritization-for-product-managers/ (2026-11-20 核对)
- Atlassian,RICE 模板:公式 (reach × impact × confidence) ÷ effort,影响和工作量为 1–5 分。https://www.atlassian.com/software/confluence/templates/rice (2026-11-20 核对)
- Nielsen Norman Group,「Stop Solutioneering」:先提问,再谈方案。https://www.nngroup.com/videos/stop-solutioneering/ (2026-11-20 核对)
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
