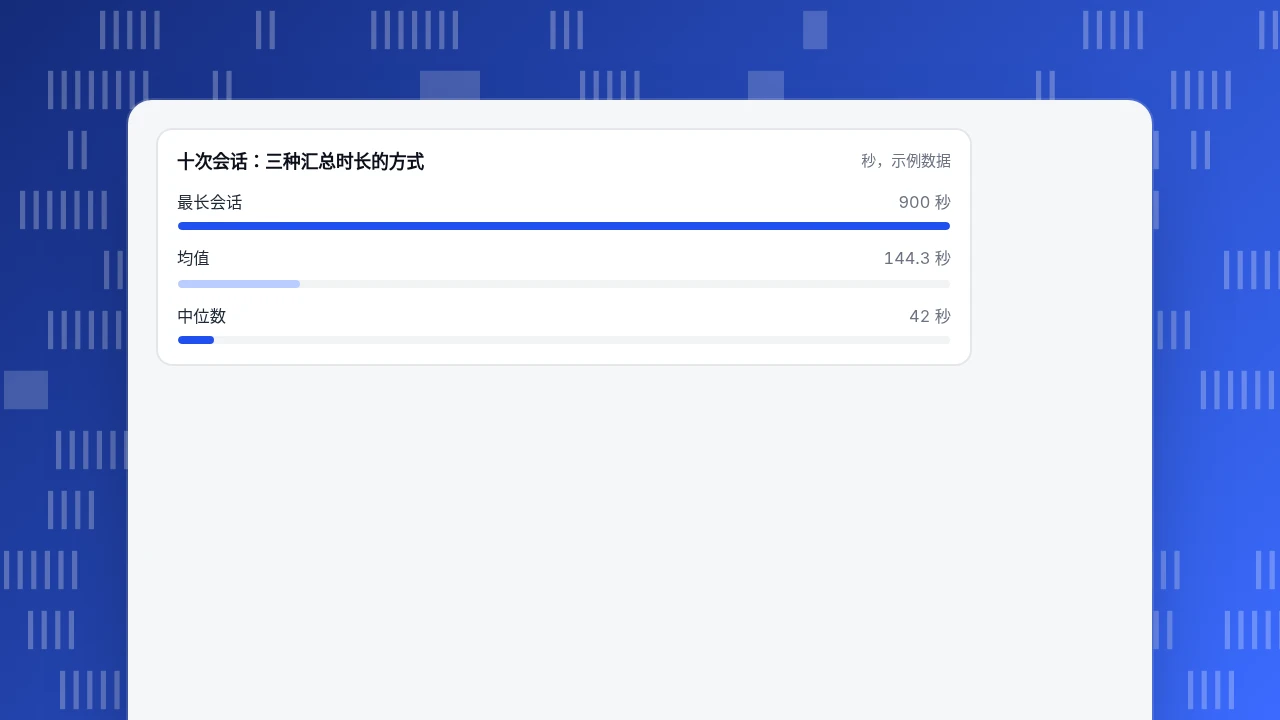
数据的例子包括页面网址、国家、2.4 秒的加载时间、5 分里的 4 分满意度评分、是否转化的二值,以及一条自由文本评论:每一个都是不同的类型,类型决定了哪种汇总是有效的。本文把一行真实风格的分析事件数据分成八种类型,说明每种允许什么、该避免什么,并用一个样本说明同样十次会话的均值(144.3 秒)和中位数(42 秒)为什么不一致。
读完你会知道
- 一行事件数据有十一个字段、八种类型;类型决定汇总方式、图表和要避免的错误
- 偏斜的数值用中位数或高百分位(中位数 42 秒对均值 144.3 秒),类别用计数和占比,是否类字段用比率
- 不要对标识符求平均,对有序评分求平均要谨慎,并保持字段类型和单位固定,数据才能一直可用
一行数据长什么样,里面有哪些类型?
数据是对某件事的一条记录:一个数字、一个标签、一个时间或一段文字。网站事件日志里的一行,已经包含了你会遇到的大部分类型。示例数据:
| 字段 | 值 | 类型 |
|---|---|---|
| timestamp | 2026-11-12 09:14:03 | 日期时间 |
| visitor_id | v_8f2a | 标识符 |
| event | page_view | 名义(类别) |
| page | /pricing | 名义 |
| country | US | 名义,地理 |
| device | mobile | 名义 |
| load_time_s | 2.4 | 连续数值 |
| pages_in_session | 3 | 离散计数 |
| satisfaction | 4(1 到 5 分制) | 有序 |
| converted | false | 二值 |
| referrer_text | 「来自新闻邮件」 | 非结构化文本 |
一条记录、十一个字段、八种不同的类型。本文余下部分说明每种类型允许做什么,因为类型决定了哪种汇总、哪种图表是有效的。更宽泛的定义见数据类型。
定性数据和定量数据有什么区别?
定量数据是测量得到的数值:加载时间、页面浏览数、收入。定性(类别)数据描述的是性质或标签:国家、设备、评分的描述、评论。区分很重要,因为算术只对前一种有意义。
| 定量 | 定性 | |
|---|---|---|
| 例子 | 每日会话数、订单金额、页面加载时间 | 流量来源、浏览器、评论文字 |
| 回答 | 多少?多久? | 哪一类?说了什么? |
| 汇总 | 均值、中位数、百分位、总和 | 计数、占比、最常见的值 |
| 图表 | 折线、直方图、散点 | 条形、堆叠条形 |
很多字段介于两者之间。1 到 5 分的满意度以数字存储,行为却像有排序的类别,所以它在下一张表里单独占一行。关于有序类别的详细内容,见有序数据的例子。
数据有哪些主要类型?各有什么例子,该怎么用?
| 类型 | 分析中的例子 | 可以做 | 要避免 |
|---|---|---|---|
| 名义 | 浏览器、国家、流量来源 | 计数、占比、最常见的值 | 求平均;当作有顺序来排名 |
| 有序 | 满意度 1 到 5;套餐层级 Free < Pro < Enterprise | 中位数、众数、分布、比较排名 | 假设 1 和 2 之间的差距等于 4 和 5 之间的差距 |
| 离散(计数) | 每次会话的页面浏览数、每个用户的事件数 | 总和、均值、中位数、直方图 | 把「2.4 次浏览」说成某一次访问的值;它是平均数 |
| 连续 | 会话时长、页面加载时间、订单金额 | 均值、中位数、百分位、相关 | 数值偏斜时只引用均值 |
| 二值 | 是否转化 | 比率(0 和 1 的均值)、比较比率 | 不说明分母就求和 |
| 时间序列 | 每日访客、每周收入 | 趋势、移动平均、季节性 | 把每一天当作彼此独立 |
| 标识符 | visitor_id、order_id | 统计不重复值、关联表 | 对 ID 求平均或求和 |
| 非结构化文本 | 聊天消息、搜索词、反馈 | 标注主题、统计提及、搜索 | 把字数当成度量 |
最常见的错误都来自「要避免」那一列:对有序评分求平均、对偏斜的时长只报均值,或者只报比率不说分母。
| 类型 | 分析中的例子 | 可以做 | 要避免 |
|---|---|---|---|
| 名义 | 浏览器、国家、来源 | 计数、占比、众数 | 求平均 |
| 有序 | 满意度 1 到 5 | 中位数、众数、分布 | 假设间隔相等 |
| 离散(计数) | 每次会话的页面浏览数 | 总和、均值、中位数 | 把均值当作某一次访问的值 |
| 连续 | 会话时长、加载时间 | 均值、中位数、百分位 | 偏斜时只报均值 |
| 二值 | 是否转化 | 比率、比较比率 | 只报比率不说分母 |
| 标识符 | visitor_id | 统计不重复值、关联 | 求和或求平均 |
示例数据。同样的类型适用于任何分析工具;每种类型适配的聚合方式见正文。
结构化、半结构化和非结构化数据有什么区别?
这种划分针对的是格式,不是含义。IBM 的解释给出了可用的定义:结构化数据有固定的模式,可以放进行和列;非结构化数据没有固定模式,包括邮件、图片和视频;半结构化数据没有预定义的数据模型,但用标签等元数据把内容组织成记录和字段。
| 格式 | 分析中的例子 | 怎么查询 |
|---|---|---|
| 结构化 | 每个字段一列的事件表 | SQL、标准报表 |
| 半结构化 | 以键值对(JSON)存储的事件属性 | 取出需要的键,再当作结构化数据处理 |
| 非结构化 | 聊天记录、开放式问卷回答 | 先搜索、标注或归纳,再计数 |
半结构化数据有重要的限制。比如 Google 分析的文档限制每个事件最多 25 个事件参数,事件名最多 40 个字符,参数值最多 100 个字符(页面地址等少数字段例外)。一个总被塞进长文本的属性会被截断;保持每个值简短,把长文本放到能存储和搜索的地方。
怎么选对统计量?一个算例
示例数据:十次会话的时长(秒)和十个满意度评分。
| 数据 | 值 | 均值 | 中位数 | 众数 |
|---|---|---|---|---|
| 会话时长(秒) | 12、18、25、31、40、44、58、75、240、900 | 144.3 | 42 | 无 |
| 满意度(1 到 5) | 5、5、4、5、2、4、5、1、5、3 | 3.9 | 4.5 | 5 |
先复算第一行:总和是 1,443,1,443 ÷ 10 = 144.3 秒,但十次会话里有八次比它短;中位数是排序后第 5 和第 6 个值(40 和 44)的平均,即 42 秒。两次很长的会话(240 和 900)把均值拉高了。对偏斜的时长,要报告中位数和一个高百分位。
评分排序后是 1、2、3、4、4、5、5、5、5、5,所以中位数是 (4 + 5) ÷ 2 = 4.5,最常见的评分是 5。3.9 的均值在评分里被广泛使用,但它假设各档之间间隔相等;报告分布(五个 5、两个 4、一个 3、一个 2、一个 1)更稳妥。
最后是时间序列:七天的访客(1,200、1,350、1,280、1,410、1,500、980、870)合计 8,590,7 日平均 1,227.1。周末的下降(980 和 870)才是规律;单独一天的数字,远不如一周的形状有信息量。
十次会话:三种汇总时长的方式
秒,示例数据数据从哪里来?
两类来源覆盖了你要分析的大部分数据。第一方数据是你自己收集的:你自己的事件、订单和客服消息。公开数据来自外部,比如政府统计。例如美国人口普查局的美国社区调查(American Community Survey)是一项持续进行的调查,每年提供关于职业、教育程度、退伍军人以及人们拥有还是租住住房等主题的信息。公开数据适合提供背景(市场有多大?),第一方数据适合做决策(我们的访客做了什么?)。把任何公开数字和你的数据比较之前,先核对它的日期和定义。
怎么记录数据才能一直可用?
五条规则,各有原因。
- 一个字段只有一个含义。 一个字段在有些行里是「mobile」,在另一些行里是屏幕宽度,就没法分析。
- 把单位写进字段名。
load_time_s和order_value_usd能避免秒和毫秒的混淆。 - 固定类型。 一个属性在一个版本里是数字,下一个版本里是文本,查询时就会拆成两列。
- 事件和属性的命名保持一致, 并且不超过平台限制(25 个参数、40 个字符的名称)。
- 确定哪些是标识符。 标识符用来关联和统计不重复值,绝不用来求平均。
同一个字段,设计得差和设计得好的差别,用下面三行就能看出来(示例):
| 设计得差 | 设计得好 | 好在哪里 |
|---|---|---|
time:有时是 2.4,有时是 2400 | load_time_s:始终是秒,始终是数字 | 单位和类型固定,均值和百分位才有意义 |
rating:「4」「四星」「good」 | satisfaction:整数 1 到 5 | 有序类别可以排序,可以算中位数 |
user:有时是邮箱,有时是编号 | visitor_id 加单独的 plan | 标识符只用于关联,类别单独存放 |
在 TapCub 里怎么处理这些数据类型?
拿会话时长这个例子来说。TapCub 提供与每种类型相配的聚合方式,你不必默认就用均值。
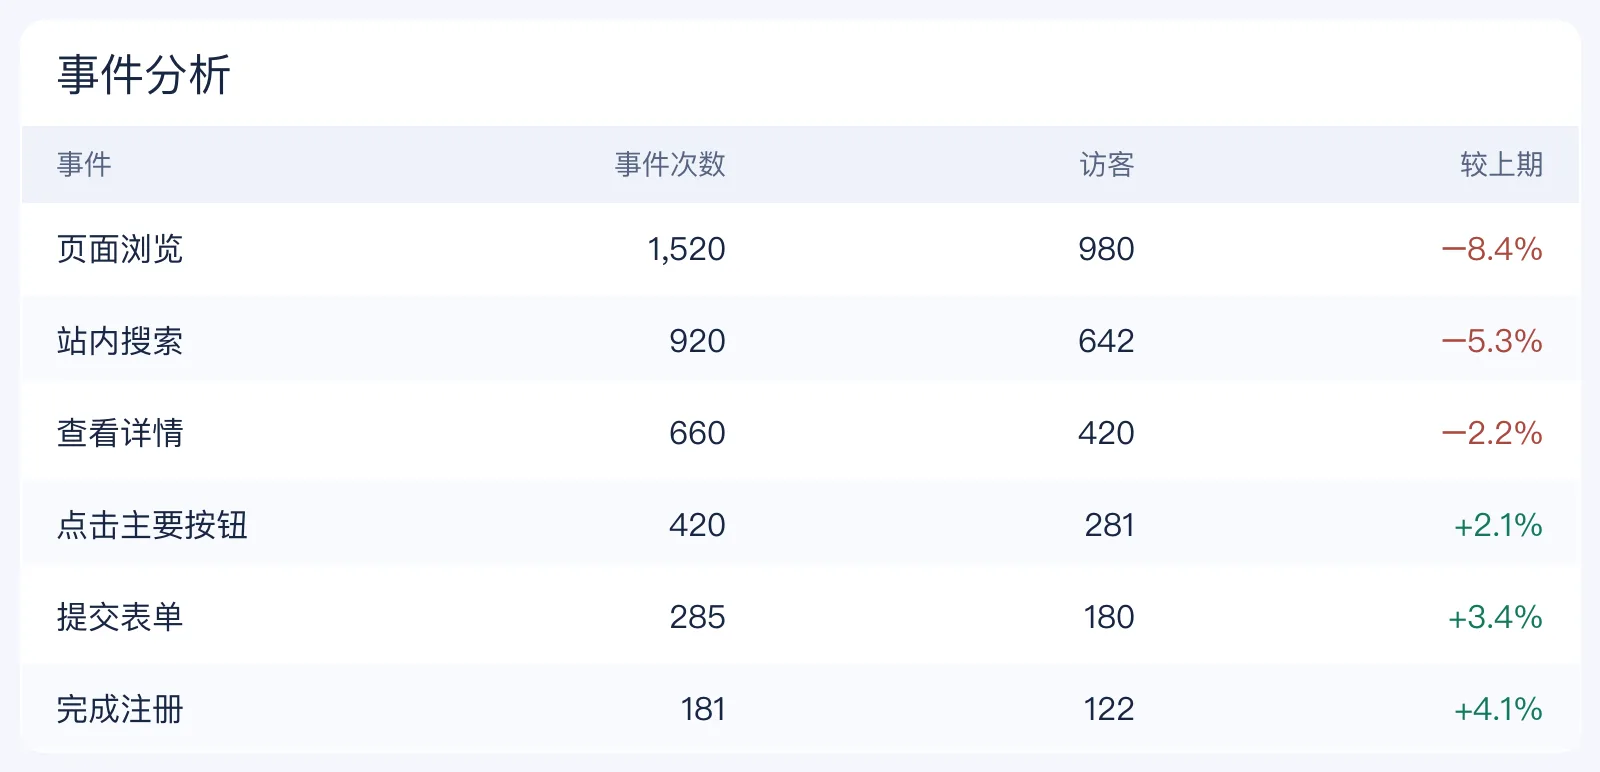
- 定义事件及带类型的属性。 在 全端分析 › 数据管理 › 埋点方案 里记录事件名、属性(名称、类型、是否必填、说明和示例)、平台和负责人。这就是开头那张事件行表里各字段的书面定义。
- 确认它到达了。 为该事件打开实时验证(近 24 小时),它显示每个事件的到达数和必填属性的完整度。没有计划过的新事件会先进入 全端分析 › 数据管理 › 事件收件箱,等有人认领。
- 选和类型匹配的聚合方式。 在 全端分析 › 行为分析 › 行为分析 里,事件聚合包括总次数、去重人数和人均,对数值属性还有求和、平均、中位数、P90、去重计数、最小值和最大值。偏斜的时长选中位数或 P90;二值字段看比率。
- 按名义字段拆分。 把同一个度量按设备、来源或国家拆分,最多三层。
- 需要原始行时再导出。 取原始行用 全端分析 › 数据管理 › 数据导出 的异步导出;控制台里的报表是汇总数据。
常见问题
数据有哪些例子?
数据的例子包括页面网址、国家、2.4 秒的加载时间、5 分里的 4 分满意度评分、是否转化的二值,以及一条自由文本评论。像上面的事件行那样,每一个都是不同的类型,允许的汇总方式也不同。
数据的四种主要类型是什么?
测量的四个层级是:名义(标签,如国家)、有序(有排名,如评分)、区间(等间隔但没有真正的零点,如摄氏温度)和比率(有真正的零点,如时长或收入)。在分析工作里,「离散」和「连续」是另一种常见的划分。
定量数据的例子有哪些?
会话时长、订单金额、每次会话的页面浏览数和加载时间。这些是可以相加、求平均的数字。样本里,十次会话时长合计 1,443 秒,均值 144.3,中位数 42。
定性数据的例子有哪些?
流量来源、浏览器、国家和开放式反馈。这些描述性质或标签,所以要计数、比较占比,而不是求平均。
结构化数据和非结构化数据有什么区别?
结构化数据有固定的模式,可以放进行和列,比如事件表。非结构化数据没有固定的模式,比如聊天记录、邮件和图片。半结构化数据介于两者之间,用标签或键来组织。
哪些数据不应该求平均?
标识符、名义类别,以及(要谨慎地)有序评分。对访客 ID 求平均没有意义,3.9 的平均评分也看不出大家是不是在 1 和 5 之间两极分化。要报告计数、占比或分布。
资料来源
- 宾州州立大学(GEOG 160). 4.2 Attribute Measurement Scales:名义、有序、区间和比率层级。2026-11-20 核对。
- IBM. Structured vs. unstructured data:结构化、半结构化和非结构化数据的定义。2026-11-20 核对。
- Google 分析帮助. Collection limits:25 个事件参数、事件名 40 个字符、参数值 100 个字符。2026-11-20 核对。
- 美国人口普查局. About the American Community Survey:关于职业、教育、退伍军人和住房状况的年度持续调查。2026-11-20 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
