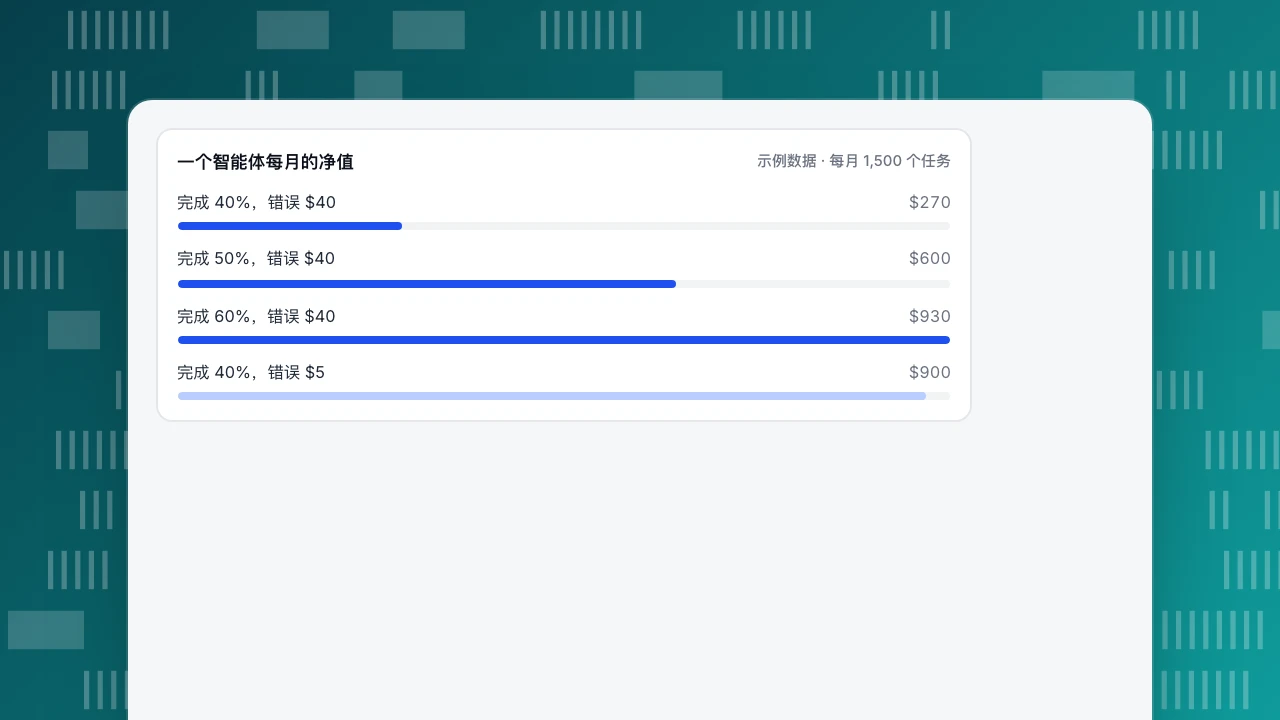
企业用 AI 智能体,要让它承担成功标准可衡量、失败代价低的任务,一个智能体只做一件事,每条输出都有出处。在一个月的算例里,同一个智能体在每个错误花 $40 时净赚 $270,在每个错误只花 $5 时净赚 $900。先从答错代价低的任务开始。
读完你会知道
- 用三个检验挑第一个任务:成功标准可衡量、失败时代价低、输出能对照来源检查
- 风险靠上线前的设计决定来控制:一个智能体做一件事、先只读、每条输出带出处、不可撤销的事由人批准、设上限和停止开关
- 示例里失败代价决定了门槛:错误成本 $40 时盈亏平衡完成率是 31.8%,$5 时是 21.5%,150 个任务的试运行得到 44.0%,越过了门槛
企业用的 AI 智能体是什么?和聊天机器人有什么区别?
AI 智能体是这样一种软件:由语言模型自己决定步骤、自己选择调用哪些工具来达成目标,而不是照着固定脚本走。Anthropic 的工程指南是这样划线的:工作流通过预先写好的代码路径来协调模型和工具,智能体则让模型自己主导流程。聊天机器人是更窄的情形:它在对话里回答,通常不在对话之外采取行动。「企业用的 AI 聊天机器人」和「企业用的 AI 智能体」有重叠,许多当作智能体卖的产品,其实是工作流,或者带检索的一次模型调用。
这个区别关系到风险,而不是用词。系统控制的步骤和工具越多,出错的方式越多,也越难看出错在哪里。同一份指南建议从最简单的方案开始,只有简单方案不够时才加上多步智能体,因为智能体是用成本和延迟换性能,而且错误会层层叠加。如果你还在选机器人的类型,见聊天机器人的类型;聊天机器人能安全承担的场景,见聊天机器人的使用场景。
哪些业务任务适合交给 AI 智能体?
用三个检验来挑任务,而不是看演示有多惊艳。好的起步任务有可衡量的成功标准(你能说清什么叫「正确完成」)、失败时代价低(错误的输出会被发现或很容易修复),以及输出能对照来源检查(一份文档、一个查询结果、一条记录)。这里的表把三个检验用在了六个常见任务上。
表里能看出两种规律。依据书面资料回答的智能体(客服问题、内部常见问题)三个检验全过,这就是客服通常是第一个落地场景的原因。对钱、人或合同采取行动的智能体,不管模型多好,都过不了第二个检验,所以应该由它提出建议,由人批准。Anthropic 的指南对客服得出了同样的结论:它适合能接触客户数据和知识库文章的对话类工作,成功可以通过用户定义的解决情况来衡量。
如果一个任务只通过一两个检验,先改任务,再换模型。缩小范围,加一个输出必须引用的来源,或者加一道批准环节。
| 任务 | 成功标准 | 失败的代价 | 能对照来源检查吗? | 结论 |
|---|---|---|---|---|
| 回答常规客服问题 | 问题解决,没有重复联系 | 低到中等;客户可以再问 | 能,对照帮助中心条目 | 适合作为第一个任务 |
| 回答关于自己统计数据的问题 | 数字和产生它的查询一致 | 展示查询时低,不展示时高 | 能,查询可以重新跑 | 适合作为第一个任务 |
| 总结或打标签(通话记录、工单) | 审核人不做修改就接受 | 低 | 能,对照原文 | 适合作为第一个任务 |
| 给具体客户起草邮件 | 准确、符合品牌语气 | 中等;发出去的错误会到客户手里 | 部分能 | 只起草,由人发送 |
| 批准退款或折扣 | 把正确的金额给正确的人 | 高;钱会流出去 | 能,但决定是一种判断 | 只提出建议,由人批准 |
| 筛选求职者 | 没有清晰可衡量的标准 | 高;影响到人 | 弱 | 不适合作为第一个任务 |
只通过一两个检验的任务,先要改任务(缩小范围、加来源、加批准环节),然后才需要更好的模型。
怎么控制 AI 智能体的风险?
控制风险,是上线前做出的一组简短的设计决定,而不是一份制度文件。每个智能体都过一遍这八条:
- 一个智能体只做一件事。「根据帮助中心回答运费问题」是一件事;「负责客服」不是。范围窄,出错的方式就窄。
- 先只读。 先上只能看数据、写文字、不能改任何东西的智能体。再一次加一项操作。
- 每条输出都带出处。 数字应来自一个能重新跑的查询;答案应来自一个能打开的条目。没有出处,就不输出。
- 不可撤销的事由人批准。 退款、发给客户的邮件、价格变更和删除,由智能体提出,由人批准。
- 答不了就转交,不要猜。 定义好智能体在什么条件下停下来,把任务连同上下文交出去。
- 设上限。 限制每个任务的步数、每天的量和每月的花费,避免循环失控。
- 有日志,有停止开关。 记录智能体做了什么,并能一步关掉。
- 限制它能读的数据。 只给能完成工作的最窄访问范围,不多给。
NIST 的 AI 风险管理框架是 2023 年 1 月发布的自愿性框架,把这项工作分成四个功能:治理、映射、衡量和管理(Govern、Map、Measure、Manage)。上面的清单对得上:任务和数据范围属于映射,上限和批准属于管理,下文的试运行属于衡量。
责任不会转移给软件。在 Moffatt v. Air Canada(2024 BCCRT 149)一案中,加拿大一个仲裁庭认定航空公司要对其网站聊天机器人告诉客户的信息负责。要按「每条输出都归你负责」来规划。
AI 智能体能省多少?一个月的算例
示例数据:一个团队有一项任务,每月出现 1,500 次,手工每次 6 分钟。可以是对进来的常规请求分类并回复。员工成本每小时 $30,也就是每分钟 $0.50。智能体每月 $300。
先定义「完成」。 输出被审核人不做任何修改就接受,算完成。假设智能体完成了 40% 的任务。
- 完成:1,500 × 40% = 600。未完成:1,500 − 600 = 900。
- 节省的时间:600 × 6 分钟 = 3,600 分钟 = 60 小时 = 60 × $30 = $1,800。
- 失败的尝试仍要花审核时间:假设每个 1 分钟,900 × 1 分钟 = 900 分钟 = 15 小时 = $450。
- 对已完成工作的抽查:600 的 10% = 60 次抽查 × 2 分钟 = 120 分钟 = 2 小时 = $60。
- 漏过去的错误:假设已完成输出里有 3% 是错的,600 × 3% = 18,每个要花 $40 来纠正(一次客户联系、一次返工)。18 × $40 = $720。
- 订阅费:$300。
每月净值:1,800 − 450 − 60 − 720 − 300 = $270。
这几乎是零,原因在错误的代价。改变一个假设:如果一个错误输出只要 $5 来修,而不是 $40,错误的成本是 18 × $5 = $90,净值变成 1,800 − 450 − 60 − 90 − 300 = $900。同一个智能体,用在失败代价低的任务上,价值是前者的三倍多。
盈亏平衡点在哪? 每个完成的任务,价值是 $3.00(6 分钟 × $0.50),减去预期错误成本(3% × $40 = $1.20),再减去抽查成本(10% × 2 分钟 × $0.50 = $0.10),得到 $1.70。每个未完成的任务浪费 $0.50 的审核。完成率为 c 时,每月净值是 1,500 × [c × 1.70 − (1 − c) × 0.50] − 300。它在 c = (300 ÷ 1,500 + 0.50) ÷ (1.70 + 0.50) = 0.70 ÷ 2.20 = 31.8% 时为零。
| 完成率 | 每月净值(错误成本 $40) |
|---|---|
| 30% | −$60 |
| 40% | $270 |
| 50% | $600 |
| 60% | $930 |
错误成本是 $5 时,盈亏平衡点降到 21.5%。对企业主来说,结论不是「智能体划算」或「不划算」,而是失败的代价决定了完成率必须越过的门槛。买之前先量出这道门槛。
一个智能体每月的净值
示例数据 · 每月 1,500 个任务上线前怎么试运行智能体?
试运行只回答一个问题:完成率有没有越过盈亏平衡点,还留有余量?分三个阶段做。
- 先写成功标准。 「完成」是什么意思,由谁判断?在看到任何输出之前就定下定义,这样就没法为了配合结果而调整它。
- 影子运行。 让智能体在真实任务上产出输出,同时人照常干活,然后对比。取 150 个任务。假设有 66 个被不加修改地接受:66 ÷ 150 = 44.0%。只有 150 个任务,95% 区间(Wilson 方法,NIST)是 36.3% 到 52.0%。下限 36.3% 高于 31.8% 的盈亏平衡点,所以即使按悲观的读法也成立。如果是 150 个里有 52 个(34.7%),下限会落在盈亏平衡点以下,结论就是「还不行」。
- 小范围推广。 让一小部分真实量,比如 10%,走智能体,持续两周,停止开关随时备好。抽样复盘,逐个读失败案例,并把完成的工作和人的产出对比。
在影子运行之前就定好通过或不通过的规则:只有区间下限越过盈亏平衡点才通过。当任务、来源资料或模型变了,就重新试运行。
企业采用 AI 智能体的常见错误
- 从最大、最重要的流程开始。 失败代价低的时候,第一次部署学到的最多。从错误只花几美元的地方开始,而不是从一位客户开始。
- 先买模型,再定义成功。 没有「完成」的标准,每个演示看起来都成功。
- 把尝试算成节省。 在算例里,1,500 个任务中有 900 个尝试了但没完成,仍然花了审核时间。
- 一个智能体给太多任务。 这样就没法说清哪一部分失败,也不知道该修什么。
- 输出没有出处。 如果无法对照什么来核对一个答案,错误就会通过客户被发现。
- 省掉停止开关。 不能一步关掉的智能体,在它出问题那天就是风险。
- 把试点当成结果。 150 个任务的影子运行是区间很宽的试验,不是保证。上线后继续抽样。
关于一种常见智能体,也就是客服机器人的成本和收益,见聊天机器人投资回报和 AI 客服智能体。
在 TapCub 里怎么用企业 AI 智能体
TapCub 把 AI 用在通过三个检验的地方:依据书面资料回答,以及回答关于你自己统计数据的问题。它不替你跑自主的多步工作。下面是每一块如何对应上面的清单。
- 客户问题,依据你的知识库回答。 在客服 › 知识库里写问答对和文档条目;在客服 › 聊天设置 › AI 接待里选关闭、仅坐席全离线时或 AI 先答,并设置单会话最多回答轮数(1 到 20,默认 6)。AI 只起草一条回复:它不改订单、不发邮件、不调用别的系统。没有把握时它转人工,工作台会标出原因。这对应清单里的第 1、2、5 条。
- 数据问题,依据你自己的数字回答。 在全端分析 › 智能运营 › AI 助手里,问数页签把一句话变成可重复的分析(指标、时间、对比、拆分和筛选)。数字来自对你项目数据执行的分析查询,而不是知识库,回答里附带查询条件,所以可以用在分析器中打开重新跑。这对应第 3 条。页面显示模型调用的每日上限,没配置模型时只按规则解析(角标:仅规则解析),这对应第 6 条。
- 问数字为什么变了。 变化归因页签按渠道、来源域名、国家、设备、着陆页等拆解一个变化,每个取值的贡献等于它的变化除以总变化。
- 接入你自己的智能体,只读。 MCP 接入页签给出端点(
/api/v1/mcp)和客户端配置。在配置 › 设置 › API 密钥里创建一个权限范围为读取报表的密钥。这些工具只读:不写事件、不改定义、不创建监控。这对应第 2、8 条。接入步骤见用 MCP 接入 AI 智能体。 - 知道边界。 TapCub 的 AI 不创建监控、不发通知、不退款、不改订单。如果你在别处搭了智能体,TapCub 的作用是衡量它做了什么:客服 › 客服报表里的已解决会话、转人工和满意度,以及统计里对你目标的影响。
常见问题
企业用的 AI 智能体是什么?
AI 智能体是这样一种软件:由语言模型自己决定步骤和工具来完成任务,比如依据帮助中心起草回复,或回答关于你数据的问题。它不同于步骤预先设定的固定工作流,也不同于通常只负责回答的聊天机器人。
企业应该先把哪些任务交给 AI 智能体?
有可衡量的成功标准、失败代价低、输出能对照来源检查的任务。依据书面知识库回答客服问题,以及回答关于自己统计数据的问题,都合适;批准退款或合同不合适,应该留给人。
企业用的 AI 智能体和 AI 聊天机器人有什么区别?
聊天机器人在对话里回答。智能体自己决定步骤,并能使用工具去行动,比如跑一个查询或发送某样东西。智能体能做更多,也有更多出错的方式,所以它需要上限、日志、批准和停止开关,而简单的回答机器人不需要这些。
AI 智能体处理企业数据安全吗?
安全来自范围,而不是来自模型。先给只读访问,只给它需要的最窄数据,每条输出带出处,并记录它做了什么。在这里的示例里,仅错误成本一项,就让一个月的净值从 $900 降到 $270。
怎么知道一个 AI 智能体值不值得上?
用你自己的数字算出盈亏平衡的完成率,然后做影子试运行,拿区间下限和它比较。在算例里,盈亏平衡是 31.8%,150 个任务的试运行得到 44.0%,下限 36.3%,所以通过。
资料来源
- Anthropic. Building effective agents——工作流与智能体的区别、何时使用智能体、客服场景。核对于 2026-11-17。
- NIST. AI Risk Management Framework——2023 年 1 月 26 日发布的自愿性框架,功能为治理、映射、衡量、管理。核对于 2026-11-17。
- Civil Resolution Tribunal of British Columbia. Moffatt v. Air Canada, 2024 BCCRT 149——对聊天机器人所提供信息的责任。核对于 2026-11-15。
- NIST/SEMATECH e-Handbook of Statistical Methods. Confidence intervals using the method of Agresti and Coull——试运行所用的 Wilson 区间。核对于 2026-11-17。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
