网站监控是对站点的持续检查,让你在访客之前发现问题,分四类:可用性、性能、错误和内容。每一类都需要各自的检查和各自的告警规则。下面讲合成检查和真实用户数据怎么配合、检查间隔和确认次数怎样决定发现时间,以及怎样按历史设定阈值。
读完你会知道
- 四类监控需要四种检查;一个在线探测不算监控
- 15 分钟的间隔可能完全漏掉一次 10 分钟的故障,而且永远不会触发两次失败才告警的规则
- 阈值要按历史设定并先试运行:示例里取平均值 14 天触发 6 天,取平均值加三倍标准差一天都不触发
什么是网站监控?它分哪四类?
网站监控是对站点的持续检查,让你在访客告诉你之前就先知道出了问题。它覆盖四件事:站点是否可用、速度快不快、有没有报错、内容是不是还是该有的样子。每一类回答不同的问题,用不同的信号,所以光有一个「在线检查」并不算监控。
| 类型 | 问题 | 典型信号 | 能抓住的故障举例 |
|---|---|---|---|
| 可用性 | 人们能访问站点吗,它的应答正确吗? | 响应状态、检查的响应时间、证书和 DNS 是否有效 | 服务器宕机、证书过期、DNS 配置错误 |
| 性能 | 对真实访客来说够快吗? | 页面加载和交互耗时,如核心网页指标 | 新加的脚本让手机上的页面变慢 |
| 错误 | 是不是有部分访客遇到了失败? | 服务器错误响应、脚本错误、错误率 | 一次发布弄坏了结账按钮 |
| 内容 | 页面上的东西对吗? | 检查预期文字或元素是否存在;robots 和索引标签 | 页面返回空白模板、误加了 noindex |
Google 讲分布式系统监控的工程书里,给服务列了四个「黄金信号」:延迟、流量、错误和饱和度。其中三个能直接对到上表:延迟就是性能,错误就是错误,流量突然塌掉往往是可用性故障最先出现的症状。本文讲的是适用于网站的实用版本。单个术语见监控。
本文的核心观点是:这四类需要不同的检查和不同的告警规则。把它们混在一起,团队就会收到一大堆关于慢页面的告警,而结账坏了却一片寂静。
| 类型 | 问题 | 典型信号 |
|---|---|---|
| 可用性 | 人们能访问站点吗,它的应答正确吗? | 响应状态、检查的响应时间、证书和 DNS 是否有效 |
| 性能 | 对真实访客来说够快吗? | 页面加载和交互耗时,如核心网页指标 |
| 错误 | 是不是有部分访客遇到了失败? | 服务器错误响应、脚本错误、错误率 |
| 内容 | 页面上的东西对吗? | 预期文字或元素是否存在;robots 和索引标签 |
每一类都需要各自的检查和各自的告警规则。
合成检查和真实用户数据怎么配合?
收集信号有两种方式。
合成监控按计划从外部向你的站点发出脚本化的请求,不管有没有人在访问。凌晨 3 点没有流量时发生的故障,就是靠它发现的。它看到的是脚本看到的东西。见合成监控。
真实用户监控记录真实访客在自己的浏览器、自己的网络里的体验。它能看到真实的设备、地点和路径,但只有在有人访问时才有数据。见真实用户监控。
| 合成检查 | 真实用户数据 | |
|---|---|---|
| 没人访问时也运行 | 是 | 否 |
| 能看到设备和网络的差异 | 否 | 是 |
| 适合 | 可用性、证书、关键流程 | 性能、错误、谁受了影响 |
| 弱点 | 只走站点里的一条路径 | 需要流量;脚本加载不出来时是静默的 |
「它在线吗」用合成检查,「对人们来说怎么样」用真实用户数据。要留意的漏洞是:站点宕得太彻底,连统计脚本都加载不出来,这时真实用户数据一片安静,而这种安静看起来像是零访问。设一条「超过一定分钟数没有数据到达就触发」的规则,就能补上。
多久检查一次,要失败几次才告警?
两个设置决定你多快知道:检查间隔,以及告警前要求连续失败几次。要求连续失败两次,可以避免因为一次网络抖动就告警。
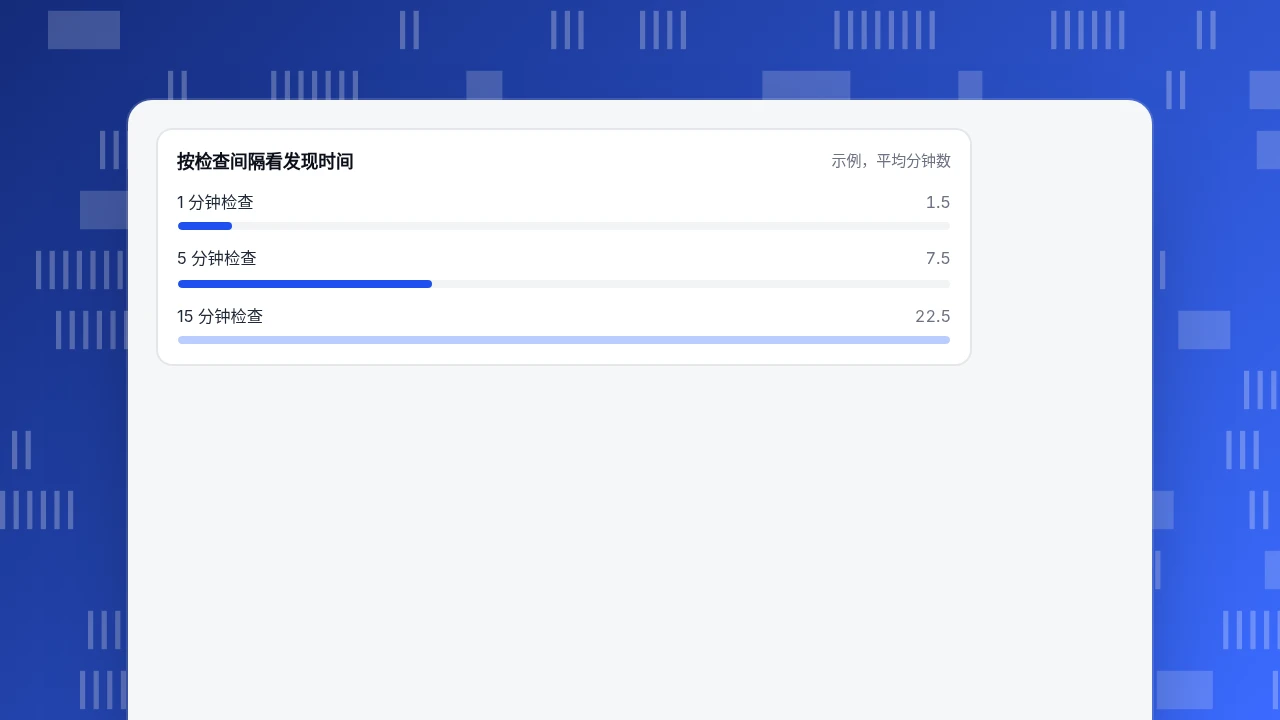
示例数据与算术:检查间隔为 T 分钟,连续两次检查失败才告警。故障开始后 0 到 T 分钟之间会出现第一次失败的检查,一个间隔之后触发告警。所以发现时间在 T 到 2T 分钟之间,平均是 1.5T。
| 检查间隔 | 发现时间(范围) | 平均 | 一次 10 分钟的故障至少让一次检查失败的概率 | 让连续两次检查失败的概率 |
|---|---|---|---|---|
| 1 分钟 | 1 到 2 分钟 | 1.5 分钟 | 一定 | 一定 |
| 5 分钟 | 5 到 10 分钟 | 7.5 分钟 | 一定 | 一定 |
| 15 分钟 | 15 到 30 分钟 | 22.5 分钟 | 66.7%(10 ÷ 15) | 0% |
用 15 分钟的检查间隔,一次 10 分钟的故障可能悄悄溜过去(三次里有一次逮不到),而且永远不会触发两次失败才告警的规则。检查间隔要按你承受不起的那种故障来选,而不是按工具允许的值来选。
这相当于多少停机?按 30 天的一个月算,99.9% 的可用性允许 30 × 24 × 60 × 0.001 = 43.2 分钟停机,99.5% 允许 216 分钟(3.6 小时),99% 允许 432 分钟(7.2 小时)。如果你的预算是 43.2 分钟,15 分钟的检查间隔已经粗到没法判断你有没有超出预算。
按检查间隔看发现时间
示例,平均分钟数性能方面该监控什么?
性能监控要回答真实访客对页面的体验如何,并且按搜索引擎和浏览器厂商定义的方式来测。Google 的 Web Vitals 指南定了三个核心网页指标和它们的「良好」阈值:最大内容绘制在 2.5 秒内,下一次绘制的交互响应(INP)不超过 200 毫秒,累计布局偏移不超过 0.1,每个都取页面加载的第 75 百分位,并按手机和桌面分别统计。它还指出这些首先是现场指标;实验室测试在开发时有用,但不能代替度量真实访问。另见 网站性能监控。
百分位很重要,因为平均数会掩盖慢的那一截。示例数据:20 次页面加载,最大内容绘制(秒)为 1.2、1.3、1.4、1.5、1.6、1.7、1.8、1.9、2.0、2.1、2.2、2.3、2.4、2.5、2.6、2.8、3.1、3.6、4.4 和 5.8。
| 统计量 | 数值 | 对照 2.5 秒阈值 |
|---|---|---|
| 中位数 | 2.15 秒 | 良好 |
| 平均数 | 2.41 秒 | 看起来良好 |
| 第 75 百分位 | 2.65 秒 | 需要改进 |
中位数和平均数都过关,第 75 百分位却不过关。四分之一的访客等了至少 2.65 秒,而指南度量的正是这个。要按页面、按设备来监控,而不只是全站汇总,因为一个慢的模板可能躲在一个不错的平均数里面。
什么样的错误值得告警?
错误是指一次请求或一次页面浏览没有做到它该做的事。Google 的监控章节把它分成三种:显式错误(比如服务器错误响应)、隐式错误(返回了成功响应,内容却不对)和按策略定义的错误(响应正确,但慢过了承诺的时间)。对网站来说,来源有:
- 服务器错误。 5xx 范围的 HTTP 状态码表示服务器没能完成一个有效的请求(RFC 9110 定义了这一类)。一个 500 只是噪声;占比上升才是信号。见 HTTP 500 错误。
- 浏览器里的脚本错误。 页面 JavaScript 里的异常,常出现在发布之后,可能不产生任何服务器错误就弄坏一个按钮。
- 断掉的流程。 页面能加载,却完成不了它的目的:结账后又回到购物车,表单点了没反应。
要看错误率,而不是错误数,因为流量会改变错误数。错误率 = 错误数 ÷ 浏览量。示例数据:20,000 次浏览里有 80 个错误,就是 80 ÷ 20,000 = 0.40%。同样 80 个错误如果出现在 2,000 次浏览上,就是 4.0%,情况完全不同。定义见错误率。
怎样写出人们不会忽略的告警规则?
Google 的监控章节给出了规则:针对用户感受到的症状来呼叫,让每次呼叫都要求人做出判断,把较低优先级的问题放进看板或工单,因为频繁的告警会让人养成扫一眼就过的习惯。用在网站上:
| 告警 | 条件 | 发往哪里 | 值班的人做什么 |
|---|---|---|---|
| 站点无法访问 | 连续两次检查失败 | 电话或聊天,立即 | 检查主机,重启或回滚 |
| 错误率飙升 | 每天或每小时的比率高于按历史定的阈值 | 聊天或邮件 | 找出是哪次发布或哪个页面在出错 |
| 流量塌陷 | 访问量远低于上周同一天 | 聊天或邮件 | 检查是统计坏了还是站点坏了 |
| 页面变慢 | 某类页面的第 75 百分位高于阈值 | 工单,每周复盘 | 排期修复;不是紧急事件 |
| 证书将到期 | 到期前 14 天 | 邮件 | 续期 |
阈值要按自己的历史来定,不要拍脑袋。示例数据:14 天的每日错误率(百分比)是 0.38、0.42、0.40、0.35、0.44、0.41、0.39、0.43、0.37、0.45、0.40、0.36、0.42 和 0.39。平均值是 0.40%,标准差约 0.03 个百分点。把阈值设在平均值(0.40%)上,14 天里有 6 天会触发,那是噪声。阈值设为平均值加三倍标准差,约 0.49%,取整为 0.50%,一天都不会触发,但能抓住一天达到 1.2% 的情况。如果工具有试运行功能,能显示这条规则在过去会触发多少次,开启规则之前先用它。
哪些错误会让网站监控变得嘈杂或者失明?
- 只检查首页。 首页可能完好,而结账坏了。要检查那些带来收入的页面。
- 一次失败就告警。 一次检查失败通常是网络噪声;要求两次。
- 针对原因告警,而不是针对症状。 「CPU 到 80%」也许说明不了什么;「错误率高于 1%」一定说明问题。
- 用平均数衡量性能。 如示例所示,平均数过了关,却有四分之一的访客体验不佳。
- 把安静当成健康。 如果统计脚本加载不出来,真实用户数据就会安静下来。既要对坏数据告警,也要对没有数据告警。
- 从不复盘告警。 每个月列出触发过的规则,以及有没有人做过什么。把那些答案是「什么也没做」的规则去掉或重新调整。
在 TapCub 里怎么监控错误、速度和流量
下面是上面的错误率示例在 TapCub 里的做法,从读数字到收到通知。
- 读当前状态。 打开 监测 › 错误。卡片显示错误数、错误率(错误数 ÷ 浏览量)、受影响访客和受影响会话。每组错误有次数、涉及会话和最后出现时间,状态分为活跃、已解决和已忽略;展开一组能看到每次发生时的页面、设备和会话。错误采集要在安装代码里打开。
- 看真实访问的速度。 打开 监测 › 性能。数字来自访客浏览器里的真实页面加载,阈值采用上面的核心网页指标。卡片可以在 P95、P75、中位数和平均数之间切换,页面分解按 P75 最大内容绘制列出最慢的页面。
- 创建监控。 在 全端分析 › 智能运营 › 监控 里,选内置指标
error_rate,条件选固定阈值(比如高于 0.50%),粒度选天。其他内置指标有errors、uv、sessions、pv、bounce_rate和avg_duration,条件还有周期变化、预测区间、异常和采集中断。 - 试运行。 试运行只计算,不发送,并报告过去 30 天这条规则会触发多少次,也就是上面示例里手工做的那项检查。
- 选择发到哪里。 渠道有邮件、企业微信、钉钉、飞书和 Webhook(带 Slack 模板)。默认情况下同一条规则约 60 分钟内不重复通知,连续命中三次会暂停。要防站点静默,就加一条采集中断条件,让一段时间没有数据时通知你。配置 › 设置 › 通知 里还有流量激增、流量下滑、爬虫异常和错误激增这几项运营告警。
TapCub 监控的是它自己的脚本从真实访问里收集的数据。它不从外部定时检查你的站点,所以不能代替在线检查或合成检查,也不检查页面内容。监控只负责通知,不会替你修复或回滚任何东西。监测 › 抓取健康 还多提供一个可用性信号,显示搜索引擎的抓取成功率、404 和 5xx。
常见问题
什么是网站监控?
网站监控是持续检查站点的可用性、性能、错误和内容,在访客反映之前发现问题。它把定时的外部检查(称为合成监控)和真实访问的数据结合起来,在指标越过阈值时发送告警。
网站上应该监控什么?
四件事:可用性(能不能访问、应答对不对)、性能(真实访客的页面速度和交互)、错误(服务器和脚本错误,按浏览量算成比率)以及内容(文字或元素对不对,有没有误加 noindex)。先从带来收入的页面开始,比如结账和注册。
多久检查一次网站?
按你承受不起的那种故障来选间隔。连续两次检查失败才告警时,发现时间在一到两个间隔之间,平均 1.5 个间隔。5 分钟的间隔每次都能发现一次 10 分钟的故障;15 分钟的间隔可能完全漏掉。关键页面的检查要比次要页面更频繁。
在线监控和性能监控有什么区别?
在线监控问站点到底有没有应答,通常靠外部的定时检查。性能监控问真实访客体验到的速度和流畅度,按某个百分位(比如第 75 百分位)测量页面加载和交互耗时。站点可以在线,但仍然太慢。
网站监控和网站统计是一回事吗?
不是。网站统计对访问进行计数和描述,用来了解受众和效果。监控盯着站点的健康状况,在出问题时提醒你。它们共用一些数据,比如真实访问里的错误数和页面速度,但回答的是不同的问题。
资料来源
- Google。Monitoring Distributed Systems,《Site Reliability Engineering》。四个黄金信号、错误的种类,以及针对症状告警的规则。2026-11-19 核对。
- Google。Web Vitals,web.dev。核心网页指标的阈值、第 75 百分位,以及现场数据与实验室数据。2026-11-19 核对。
- IETF。RFC 9110: HTTP Semantics,5xx 服务器错误状态码类别。2026-11-19 核对。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
