公开的网站流量数据有三类:所有者公布的精确计数(维基媒体的页面浏览量)、用抽样信号做的排名(Tranco、Cloudflare Radar)和浏览器遥测(CrUX)。只有前一类测的是流量,其余是热门度的替代指标。没有哪个公开来源能给出任意私营站点的访问量,所以每个数字都要记下单位、窗口和日期。
读完你会知道
- 只有维基媒体这类所有者公布的计数才是在测量流量;排名和遥测是不同单位的热门度替代指标
- 英文维基百科 2025 年计入的请求有 35.6% 不是用户流量,前 40 名域名的排名在 39 天里移动了 29%
- 在每个公开数字旁记下来源、单位、范围、窗口和拉取日期,以便重新核对
公开的网站流量数据到底有哪些?
公开的流量数据有三类,彼此不能互换:所有者自愿公布的精确计数、用抽样信号建立的排名,以及描述体验而非规模的浏览器遥测。没有哪个公开来源能告诉你任意一个私营网站的访问量。知道自己手里的是哪一类,才能决定该相信到什么程度。
下面的来源都可以免费读取,我们在 2026-11-19 和 2026-11-20 直接查询或读取了每一个。对你找到的任何流量数据,要核对四件事:谁测的,统计的是什么(访问、页面浏览、DNS 查询还是用户),时间窗口多长,以及有没有去掉机器人。
哪个来源提供什么、样本从哪来、可靠到什么程度?
| 来源 | 报告什么 | 抽样和窗口 | 作为流量数据的可靠性 |
|---|---|---|---|
| Wikimedia 页面浏览量接口 | 维基媒体各站点每个页面或每个项目的页面浏览量,区分用户和自动化访问者,数据始于 2015 年 5 月 | 完整计数;自动化流量用其自己的机器人识别过滤 | 仅对该站点是精确的 |
| Tranco | 一百万个域名各一个排名,每天更新 | 对多家提供方过去 30 天的排名取平均 | 只是排名;每天都在动 |
| Cloudflare Radar 域名排名 | 有序的前 100 名,之后是从 200 到 1,000,000 的无序排名区间 | 基于匿名化的 1.1.1.1 解析器查询;热门度是查询某域名的用户群体的估计规模 | 只是数量级 |
| Chrome 用户体验报告(CrUX) | 各源的真实用户性能分布和粗略的热门度区间,BigQuery 中按月,始于 2017 年 | 符合条件的 Chrome 用户,在公开可发现且足够热门的源上 | 出现在其中是下限;没有访问数 |
| 服务商免费数据(混合估算) | 访问量估算和排名,服务商自述混合了多种来源 | 模型;具体站点的样本不公开 | 是估算;要校准 |
这样一张表说明了一件事:只有第一行是对流量的测量,其余各行是热门度的替代指标。
| 来源 | 报告什么 | 作为流量的可靠性 |
|---|---|---|
| Wikimedia 页面浏览量接口 | 区分用户和自动化访问者的页面浏览量,始于 2015 年 5 月 | 仅对该站点是精确的 |
| Tranco | 一百万个域名各一个排名,对多家提供方取 30 天平均 | 只是排名;每天都在动 |
| Cloudflare Radar 排名 | 有序前 100 名,之后是从 200 到 1,000,000 的无序区间 | 只是数量级 |
| Chrome 用户体验报告 | 真实用户性能和粗略热门度区间,按月 | 出现在其中是下限;没有访问数 |
| 服务商免费数据 | 混合的访问量估算和排名 | 是估算;要校准 |
来源描述已于 2026-11-20 对照各提供方文档核对。
怎样自己把数据拉下来?
前两个来源不需要账号。在终端里运行下面的命令,它们和本文例子用的是同样的调用。
- 英文维基百科 2025 年每月页面浏览量,仅用户流量:
curl "https://wikimedia.org/api/rest_v1/metrics/pageviews/aggregate/en.wikipedia.org/all-access/user/monthly/2025010100/2025120100"
把 user 改成 all-agents 就包含自动化流量。
- 某个域名的 Tranco 排名历史:
curl "https://tranco-list.eu/api/ranks/domain/example.com"会返回每份每日榜单中的一个排名。 - BigQuery 里的 CrUX: 数据集在 BigQuery 每月免费额度内免费。
metrics_summary表给出每个源每个月的粗略热门度区间。 - Cloudflare Radar: 打开 Domains 页面,下载区间 CSV。记住区间内的顺序是有意隐藏的。
把你拉取每个数字的日期记下来。排名和月度数字都会变化,没有日期的数字之后就没法核对。
算例:精确的公开数据,仍然能告诉你噪声有多大
连那个仅有的精确来源,也显示了「流量」这个概念有多不稳定。2026-11-20 从维基媒体接口拉取的英文维基百科 2025 年真实数据:
- 规模。 按月的用户页面浏览量,从 1 月的 8,075,023,328 到 6 月的 6,637,486,973,比值为 8.075 ÷ 6.637 = 1.22。2025 年总计 85,541,514,536,约每月 71.3 亿。
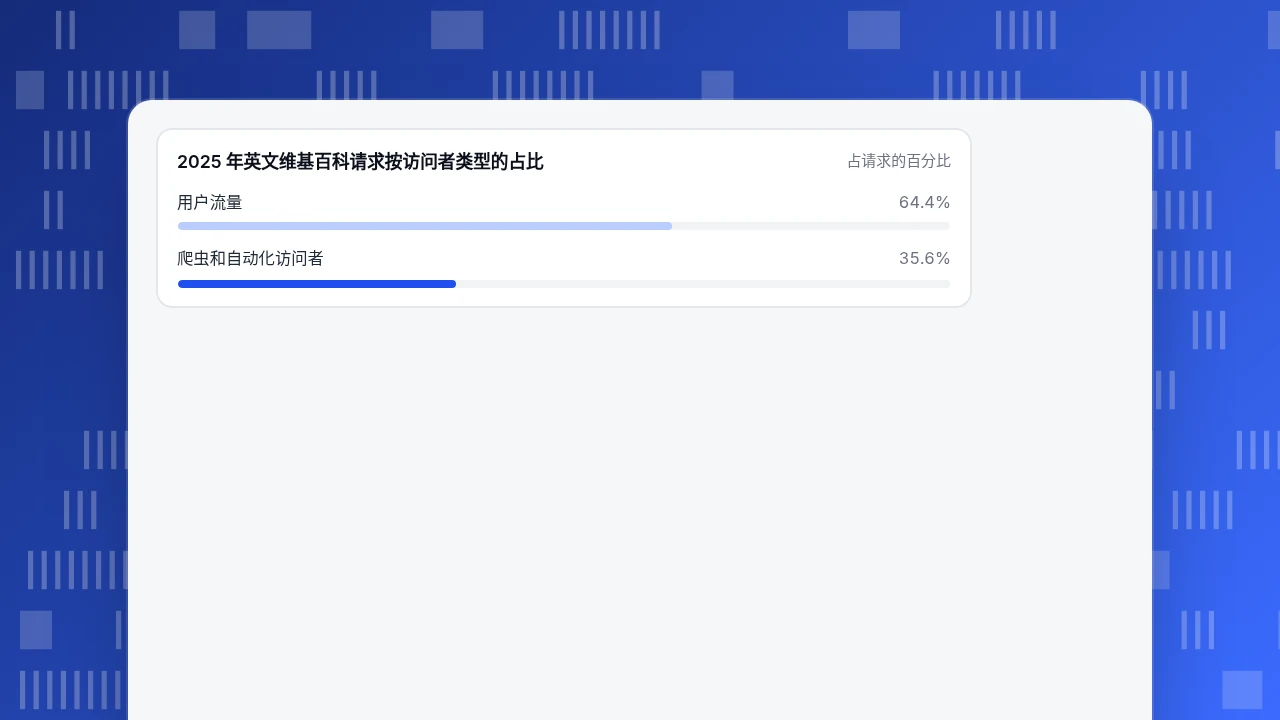
- 机器人占比。 包含全部访问者时全年合计 132,913,760,903。用户流量占 85.54 ÷ 132.91 = 64.4%,所以 35.6% 的计入请求是自动化的。
- 占比在变。 按月看,用户占比从 9 月的 57.8% 到 10 月的 70.6%,在相邻两个月之间波动 12.8 个百分点。
再看排名,来自 Tranco 的 39 份每日榜单,2026-10-12 到 2026-11-19:wikipedia.org 在 31 到 40 之间,波动 (40 − 31) ÷ 31 = 29.0%;example.com 在 165 到 186 之间,12.7%。
对任何读公开数据的人,这意味着:
- 精确计数的月度差异达到 20%,可能只是季节性,不是趋势。
- 「真人占比」本身就是一个会变动的测量值,所以对机器人分类不同的两个来源可以彼此不一致,而且谁都没错。
- 榜单顶端几个名次的变化不是信号;要比较几周的排名,不要比较几天。
2025 年英文维基百科请求按访问者类型的占比
占请求的百分比没有哪个公开来源能告诉你什么?
无论你选哪个来源,都还有四个缺口,每一个都是不要把单个数字当作事实引用的理由。
| 统计的单位 | 来源 | 能换算成访问吗? |
|---|---|---|
| 页面浏览 | Wikimedia | 不能,除非知道每次访问的页数,而接口没有给 |
| 一群解析器用户对域名的查询 | Cloudflare Radar | 不能:查询不是访问,而且该解析器的用户不是全部上网的人 |
| 符合条件的 Chrome 用户体验 | CrUX | 不能:只收录部分 Chrome 用户,Chrome 也不公布占比 |
| 排名位置 | Tranco | 不能:排名没有单位 |
- 没有一个单位是对得上的。 表里有四种不同的单位。访问、页面浏览、查询和排名是不同的东西,所以不能把一个来源和另一个来源相减。
- 没有哪个样本是整个网络。 每个来源只看到自己的一块:一个站点自己的服务器、一个解析器的用户、一个浏览器里选择加入的用户。
- 没有哪个来源是新鲜的。 Radar 的区间在推出时用的是七天窗口,Tranco 用 30 天,CrUX 按月发布,所以上周开始的活动在其中好几个里是看不到的。
- 没有哪个来源用同样的方式去掉机器人。 维基媒体的数字显示差别可以有多大,其他每个来源都用自己的规则。
怎样记录一个公开数字,让别人之后还能核对?
一个公开数字只有在别人能再找到它时才有用。在你保留的每个数字旁边写下五件事:
- 来源和接口,例如「Wikimedia 页面浏览量接口,aggregate」。
- 单位,例如「页面浏览,仅用户类访问者」。
- 范围,例如「en.wikipedia,all-access」。
- 窗口,例如「2025 年 1 月到 12 月」。
- 拉取日期,例如「2026-11-20」。
这样,「英文维基百科 2025 年 85,541,514,536 次用户页面浏览,2026-11-20 从维基媒体接口拉取」这样的数字就能重新运行和对比。而「维基百科每月约有 70 亿次访问」就不行:它把单位从页面浏览换成了访问,而且没有窗口也没有日期。
针对一个具体问题,怎样选来源?
按下面的决策顺序。
- 站点所有者公布数字吗? 用他们的数字。维基媒体是标准的例子;有些公司在财报或公开页面里发布统计。
- 需要很多站点之间的相对顺序吗? 用排名榜单,而且用 Tranco 这样的 30 天平均,不要用单日数据。差距小于你测出的波动(下面例子里是 6% 到 29%)的排名,当作并列。
- 只需要数量级吗? Cloudflare 的排名区间或是否出现在 CrUX,能告诉你一个站点是在几十万的量级还是几百万的量级,别的就没有了。
- 要的是体验,不是规模吗? CrUX 给出符合条件的源的真实用户性能分布。
- 需要一个私营站点的访问数吗? 公开渠道没有。用混合估算,并用你知道的站点校准,见一个网站有多少访客;网站流量统计里的基准汇总,说明了哪些已发布的数字站得住。
用 TapCub,你能公开自己流量的哪些部分?
TapCub 不采集其他网站的流量,所以它不是竞争对手公开数据的来源。它能做的,是让你自己的数字精确,并且在你愿意时变成公开的。流程:
- 安装脚本,打开网站统计 › 概览看你自己的访客、会话和页面浏览。识别出的机器人和 AI 爬虫在网站统计 › 机器人里单独统计,所以你的真人总数不会被维基媒体数据里 35.6% 那种自动化流量抬高。
- 记下你读每个数字的日期,并用日期选择器让每次对比的窗口相同。
- 要公开,进入配置 › 设置 › 公开分享。它会创建一个只读链接;你可以加密码、选择开放哪些模块(概览、页面、来源、受众、机器人),并限制链接能显示多少天的历史。
- 知道哪些不能分享:访客列表和会话永远不能通过公开链接查看。
- 用配置 › 日期标注标出发版和活动,让读你数字的人看得出某个月为什么跳升。
常见问题
有关于一个网站流量的公开数据吗?
只有所有者公布时才有。维基媒体是个清楚的例子,它有一个报告页面浏览量的公开接口。对其他网站,只有排名和估算,没有精确的访问计数。
Tranco 或其他网站排行榜有多可靠?
作为热门度排名可靠,作为流量不可靠。Tranco 对多家提供方取 30 天平均使榜单稳定,但我们看到 wikipedia.org 在 39 天里在第 31 到第 40 名之间移动。Tranco 的作者也指出,来源排名彼此不一致,也可能被操纵。
CrUX 能显示一个站点有多少访客吗?
不能。CrUX 报告的是公开可发现且足够热门的源的真实用户性能。被收录说明站点有足够的 Chrome 访客可以测量,但不说明有多少。
公开的流量数字包含机器人吗?
取决于来源。维基媒体过滤了自动化流量,同时仍单独报告它:2025 年英文维基百科计入的请求里 35.6% 不是用户流量。对其他来源,在服务商说明之前,假设机器人可能混在里面。
为什么两个来源对同一个站点显示的流量不同?
它们在不同的窗口里统计不同的东西:查询、访问、页面浏览或用户,机器人规则也不同。同一个来源随时间比较,第二个来源只用来看数量级。
资料来源
- Wikimedia。Pageviews analytics API:入门和页面浏览量数据湖文档,数据始于 2015 年 5 月,机器人过滤,user 与 all-agents;查询于 2026-11-20。
- Tranco。Tranco:面向研究的热门网站排名,多家提供方排名的 30 天平均、每日更新、接口;排名历史查询于 2026-11-19。
- Cloudflare。Radar Domain Rankings,有序前 100 名、从 200 到 1,000,000 的无序区间、基于解析器的热门度。核对日期 2026-11-20。
- Google Chrome。CrUX methodology和 BigQuery 中的 CrUX,收录规则、始于 2017 年的月度表。核对日期 2026-11-20。
这篇文章对你有帮助吗?
我们会根据反馈修改和补充这篇内容。
提交没有成功,请稍后再试。
谢谢你的反馈,我们会据此改进这篇内容。你已经反馈过这篇了,谢谢。
